
投稿日:2026.09.13 最終更新日:2026.09.20
合成データとは?8社の事例でわかる使い道と品質の見極め方
人工的に作ったデータは、何に使えるのか。
8社の事例から、品質と事業の入口を考えます。
合成データとは、実際の記録の特徴や、設定した条件をもとに人工的に作るデータです。顧客情報に似た表、仮想の道路画像、AIの練習問題などが含まれます。集めにくいデータを補い、開発や学習を進めるために使います。大切なのは、量を増やすことより、使う目的に合うかを実データで確かめることです。見た目が本物に似ていても、業務で役立つとは限りません。この記事では8社の取り組みを比べ、品質の見極め方と、新規事業の入口を解説します。
この記事の結論
合成データは、何を再現し、どう確かめるかを決めてから作ります。
- テスト、画像・ロボット、文章の8社の取り組みを紹介
- 形式、傾向、業務での成果を分けて品質を確認
- 業務知識、現場の接点、評価の力を生かす参入方法を解説
目次
合成データとは何か?架空の記録を作る理由
たとえば、通販サイトの返品機能を開発するとします。必要なのは、購入、発送、返品、返金までがつながるテスト用の記録です。しかし、本物の顧客情報を開発会社にそのまま渡すのは難しい場合があります。
そこで、架空の顧客と注文を作ります。同じ顧客の注文番号をそろえ、発送前の返品や、一部だけの返金も用意します。このように、試したい状況を人工的に作るのが合成データの使い方です。
合成データは、でたらめな値を並べたものではありません。「注文の後に発送される」「返品した商品に対応する返金がある」といった関係を保ちます。何を本物に近づけるかは、用途によって変わります。
実データから傾向を学ぶ方法もあれば、業務のルールから作る方法もあります。仮想空間で物体を動かし、カメラにどう映るかを計算する方法もあります。生成AIだけを指す言葉ではありません。AWSの解説も、AIの学習やテストなどの用途を整理しています。
ここで区別したいのが、「本物ではない」と「安全に使える」の違いです。実在の人の特徴が残ることも、元の資料の利用条件が関わることもあります。人工的に作っただけで、自由に配布できるわけではありません。
足りないのは、件数ではなく特定の場面かもしれない
正常に動いた機械の記録が多くても、故障前の記録は少ない。晴れた道路の画像はあっても、雨の夜の画像は足りない。このように、知りたい場面に限ってデータが集まらないことがあります。
合成データは、その穴を狙って補う手段です。ただし、知らない故障を正確に作れる魔法ではありません。故障の仕組みを理解していなければ、不自然な記録を増やすだけになるおそれがあります。
最初に考えるべき問いは、「何件増やすか」ではなく「どの場面を再現したいか」です。ここが曖昧なままでは、生成した後の良し悪しも判断できません。
表・画像・文章では、合成データの使い道が違う
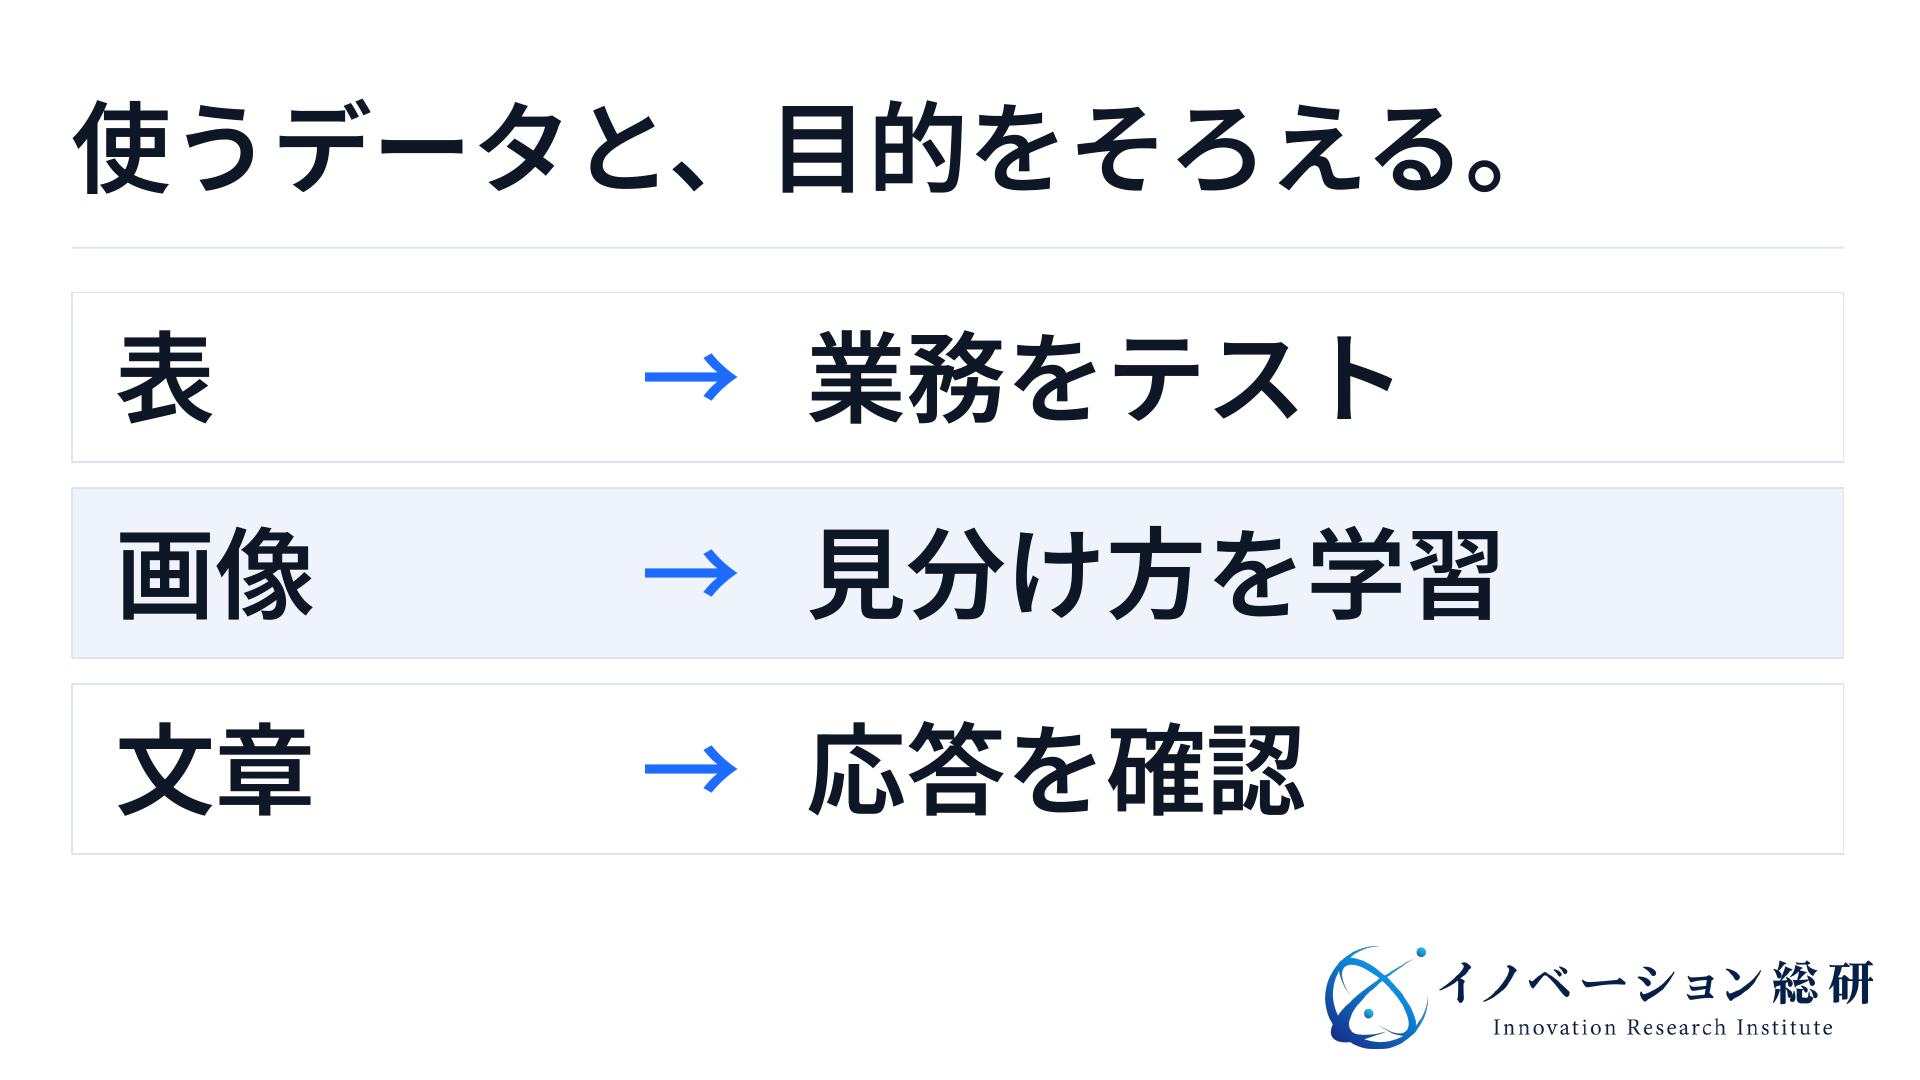
同じ合成データでも、顧客の購買履歴とロボットの学習画像では、作り方も評価方法も異なります。製品を選ぶ前に、扱うデータと用途を分けましょう。
| データの種類 | 作るものの例 | 主な使い道 | 最初に確かめる点 |
|---|---|---|---|
| 表・時系列 | 架空の注文、取引、設備の記録 | システムのテスト、分析、予測モデルの学習 | 項目の関係、時間の順序、例外の再現 |
| 画像・映像 | 仮想の道路、商品、工場内の画像 | 画像認識、ロボットの学習や評価 | 光、物体、動き、センサーの再現 |
| 文章・図表 | 質問と回答、文書、グラフの問題 | 言語モデルの学習、回答品質のテスト | 内容の正しさ、難しさ、重複や偏り |
表では、個々の値より関係が重要になることがあります。年齢と購買傾向を学ばせたいなら、その関係が崩れたデータは役立ちません。システムのテストなら、存在しない顧客番号に注文が結びついていないかが問題になります。
画像では、見栄えの良さだけを見ないことが大切です。たとえば、照明の反射で見えなくなる部品を検出したいなら、その反射を再現する必要があります。美しい工場の画像を大量に作っても、狙った弱点の改善には直結しません。
文章では、流ちょうさと正確さを分けます。質問も回答も同じAIに作らせると、同じ誤りを繰り返す可能性があります。業務の手順や正解を知る人が確認できる範囲から考えると、目的を絞りやすくなります。
マスキングやデータ拡張とは、どう違うのか
マスキングは、実データの氏名や番号などを隠したり置き換えたりする処理です。合成データの製品にも、この機能を含むものがあります。ただし、特定の項目を置き換えることと、記録全体を新しく作ることは同じではありません。
データ拡張は、手元のデータを加工して学習例を増やす考え方です。画像の向きを変える方法もあれば、合成データで不足する場面を補う方法もあります。名称だけで優劣を決めず、何を変更し、何を保つのかを確認しましょう。
合成データを使う8社は、何を提供しているのか
ここでは、生成・評価の製品を提供する企業と、AIの学習に活用する企業を分けて紹介します。8社すべてが同じ製品を売っているわけではありません。製品の提供と、研究で示された結果も区別して読みます。
| 企業 | 主な製品・取り組み | 誰の何を支えるか | 確認できる段階 |
|---|---|---|---|
| Tonic | Fabricate | 開発者向けに、つながりを保ったテストデータを作る | 製品提供・機能公開 |
| Syntho | Syntho Engineなど | 企業のテスト、デモ、分析向けに複数の生成方法を提供 | 製品提供 |
| SAS | SAS Data Maker | 企業の分析・AI開発向けにデータを生成する | Microsoft Marketplaceで提供 |
| DataCebo | SDV、SDMetrics | 開発者向けに表の生成と評価を支える | 公開ソフト・企業向け製品 |
| NVIDIA | Isaac Sim | ロボット開発者向けに仮想環境と学習データを作る | 開発基盤を提供 |
| Parallel Domain | PD Replica、PD Sim | 自動運転などの失敗場面を再現して評価する | 製品・利用方法を公開 |
| Hugging Face | Cosmopedia | 言語モデルの学習用文章と生成方法を公開する | データ・研究を公開 |
| Microsoft | Phiシリーズ | AIモデルの学習で合成データを活用する | モデル・研究を公開 |
表の上半分は、企業がデータを作って使うための道具です。下半分には、仮想環境や学習方法の開発も含まれます。自社が使う道具を探すのか、参入のヒントを得たいのかを分けて読むと、各社の違いがつかみやすくなります。
1.Tonic:別々のシステムをつなぐテストデータを作る
TonicのFabricateは、架空のデータを作る製品です。2026年5月には、複数のデータベースやファイルをまとめて扱う機能を紹介しました。同じ顧客や商品を表す番号のつながりを保ちながら、データを作る設計です。Tonicの機能発表
通販の仕組みで考えると、顧客、商品、在庫、決済は別々の場所で管理されます。一つの表だけが正しくても、在庫にない商品を出荷したり、存在しない注文に返金したりすれば、テストは成立しません。
この事例の面白さは、データの生成だけでなく、システム間のつながりを商品にしている点です。AIエージェントのテストでも、問い合わせ文だけでなく、参照する注文や在庫をそろえる必要があります。
イノベーション総研は、日本企業の複雑な業務を整理する仕事に注目します。返品、訂正、承認のやり直しなどを、テスト可能な条件へ落とし込む役割です。ただし、製品が接続できることと、その企業固有の例外を再現できることは別です。導入側にも業務を説明できる担当者が必要になります。
2.Syntho:AIだけに頼らず、作り方を使い分ける
Synthoは、AIによる生成、機密情報の置き換え、業務ルールに基づく生成を組み合わせる方針を示しています。テストやデモ、データ共有などが主な用途です。2026年6月には、MOSTLY AIのブランド取得を発表しました。会社全体の買収と読み替えないことが必要です。Synthoの発表
たとえば、商品番号は決められた形式で作り、売上の傾向は実データから学び、氏名は架空のものへ置き換える。こうした使い分けなら、すべてをAIに任せる必要はありません。
ここから読み取れるのは、生成方法を増やすことより、用途に合う方法を選ぶ重要性です。営業デモなら説明したい業務が再現できればよく、需要予測の学習なら季節や価格の関係が重要になります。
参入する側には、業種別の設定や確認項目を用意する道があります。ただし、設定を毎回一から作る受託業務では、件数が増えるほど人手も増えます。共通化できる項目と、顧客ごとに判断する項目を分けることが、収支を考える出発点です。
3.SAS:分析で使うデータを、企業が調達しやすい形にする
SASは2025年11月、SAS Data MakerのMicrosoft Marketplaceでの提供を発表しました。表の統計的な特徴や、項目間・時間方向の関係を扱う合成データ製品です。企業の分析やAI開発を支える位置づけです。SASの提供開始発表
この事例は、生成技術だけでなく、企業が既存の調達経路から導入できる点に特徴があります。新しい道具を試せても、契約や運用の担当が決まらず、業務に組み込めない場合があるためです。
イノベーション総研が見る参入の余地は、分析の目的とデータの設定をつなぐ部分です。たとえば、売上予測に使うなら、どの季節や顧客層で誤差を減らしたいのかを先に整理します。その目的に応じて、生成後の評価方法を変えます。
注意したいのは、製品の提供開始を、個別業務での成果と同一視しないことです。既存の分析環境への接続方法、データの保管場所、費用の増え方は案件ごとに確認します。今後の開発予定も、利用できる機能とは分けて判断します。
4.DataCebo:生成した後の評価も、使える道具にする
DataCeboは、表形式のデータを作るSDV(Synthetic Data Vault)と、評価のためのSDMetricsを開発しています。SDVは、単独の表だけでなく、関連する複数の表なども扱います。SDMetricsでは、形式、統計的な特徴、プライバシーなどを分けて評価します。SDV公式リポジトリ、SDMetrics公式文書
重要なのは、評価の点数が一つではないことです。たとえば、番号が重複していないかを調べる検査と、購買の傾向が似ているかを調べる検査では、確かめているものが違います。書式の検査が満点でも、予測が当たるとは限りません。
公式文書でも、統計的な類似性と、利用先の仕事で得られる成果は一致しない場合があると説明しています。これは、導入を考える企業にとって大切な区別です。
イノベーション総研は、顧客が必要とする評価を選び、その結果を説明する役割にも価値があると考えます。ただし、評価レポートを出すだけでは不十分です。どの用途を試し、どの用途は未確認なのかまで示すことで、データを渡す側と使う側の認識をそろえられます。
5.NVIDIA:ロボットが学ぶ環境そのものを作る
NVIDIAのIsaac Simは、ロボットやセンサーを仮想空間で動かす開発基盤です。設計データや実世界の記録などを取り込み、物体、材質、物理的な動きを設定します。その環境から合成データを作り、ロボットの学習やテストに使えます。Isaac Sim公式ページ
たとえば、箱を見つけて運ぶロボットなら、箱の位置、照明、カメラの条件を変えます。現場で一つずつ撮影する前に、想定する場面を広く試すための基盤です。
ただし、仮想空間でできたことが、そのまま現場でできるとは限りません。物体の滑りやすさ、照明の反射、センサーの癖が違えば、結果も変わります。ここに、現場の設備や作業を知る企業の役割があります。
新規事業として考えるなら、汎用の仮想世界を作るだけでなく、特定の工場や作業を再現するサービスが候補です。必要なのは現場へのアクセスと、実機の結果を確かめる相手です。ロボット事業全体の入り方は、フィジカルAIの記事でも整理しています。
6.Parallel Domain:うまくいかなかった場面を、繰り返し試す
Parallel Domainは、自動運転などの開発で使う仮想環境を提供しています。2026年9月の解説では、実走行で問題が起きた場面をPD Replicaで再現し、PD Simで条件を変えて評価する流れを紹介しました。Parallel Domainの解説
一度見逃した歩行者がいたなら、同じ映像を再生するだけでなく、服の色、光、動き出すタイミングなどを変えます。何が失敗の原因になったかを調べ、似た条件でも問題が残らないかを試す考え方です。
この事例が示すのは、正常な場面を大量に増やす以外の使い道です。実際の失敗から、次に必要なデータを決めています。なお、これは同社が示す製品の利用方法であり、すべての事故を防げるという実績ではありません。
参入を考える企業は、走行距離のような量だけでなく、失敗を分類できる記録に注目できます。工場の搬送や屋外の点検にも、同じ問いは応用できます。ただし、仮想環境による評価だけで、安全性の確認が完了するわけではありません。自動運転の記事では、運行や責任の論点も扱っています。
7.Hugging Face:学習用の文章を、作り方ごと公開する
Hugging Faceは2024年、Cosmopediaを公開しました。言語モデルの学習に使う人工的な文章と、その生成方法を共有する取り組みです。教科書風の解説、ブログ、物語など、文章の種類や読み手を変えて作っています。Cosmopediaの公開資料
ここで参考になるのは、長い文章を大量に出すだけではない点です。何を題材にするか、誰に説明するか、どの形式にするかを変え、学習内容の偏りを減らそうとしています。
一方、公開資料は、生成した文章に誤りがあり得ることも説明しています。公開データだから正しいとは限りません。特に、業務で使う手順や専門知識は、別の根拠で確かめる必要があります。
イノベーション総研は、日本語の特定業務に必要な教材や評価問題を整える仕事に、この考え方を応用できると見ています。強みになるのは、文章を生成する能力だけではありません。どんな問いに答えられるべきかを定め、正解を確認できる知識と権利のある資料が必要です。
8.Microsoft:苦手な図表を補うために、学習例を設計する
MicrosoftはPhiシリーズの研究で、合成データを学習に取り入れています。2026年に公開した画像と言葉を扱うモデルの解説では、図表や文書、数式などを含む学習例をプログラムで作る方法を説明しました。Microsoft Researchの解説
図と質問と答えを対応させて作れば、内容や正解を管理しやすくなります。実際に集めたデータでは少ない形式を補うこともできます。同社は、合成データを良質な実データの代わりではなく、補う手段として位置づけています。
たとえば、日本語の帳票を読むAIを考えるなら、よくある書式だけでなく、注記が多い表や、単位が途中で変わる表も問題になります。何を苦手としているかを調べ、その条件を増やす発想です。
この事例から、少量でも狙いの明確な学習例に価値があると考えられます。ただし、海外モデルの研究結果を、そのまま日本語の帳票業務に当てはめることはできません。実際の帳票で読み違いが減るか、別に確かめる必要があります。
合成データ市場で、生成の先に広がる競争
8社の取り組みを横に並べると、競争する場所が少しずつ違うことがわかります。データを作る製品だけでなく、既存システムへの接続、仮想環境の再現、品質の評価まで広がっています。
SASは2024年11月、Hazyの主要なソフトウェア資産の取得を発表しました。その後、Data Makerの提供を進めています。Synthoによる2026年のMOSTLY AIブランド取得も含め、製品やブランドの関係は変わりつつあります。SASの資産取得発表
ただし、こうした動きだけで市場全体の成長率は判断できません。表のテストデータと、ロボットの仮想環境では、費用を払う部門も導入の条件も異なります。市場全体の予測額より、狙う用途の顧客と支払者を具体化する方が、参入の検討には役立ちます。
イノベーション総研は、事業を三つの仕事に分けて考えます。一つ目は、必要なデータを作る仕事。二つ目は、業務や開発環境につなぐ仕事。三つ目は、使ってよい範囲を評価し、説明する仕事です。
生成の仕組みを自社開発しなくても、二つ目や三つ目から入る道があります。一方、汎用製品が対応する機能を、そのまま受託で再現するだけでは差が出にくくなります。対象業務を深く理解し、顧客が自力で解けない問題を見つけることが重要です。
自社の状況から、次に確認することを選ぶ
該当する項目を開くと、記事の読む場所がわかります。点数を付ける診断ではありません。
NEXT STEP
次のステップ
生成できることを、顧客が使える価値へ変える
顧客が困る場面、自社が持つ業務知識やデータ、効果を確かめる相手を整理します。生成、業務への接続、品質評価のどこを担うかを考える事業相談です。
「本物に似ている」と「仕事で使える」をどう確かめるか
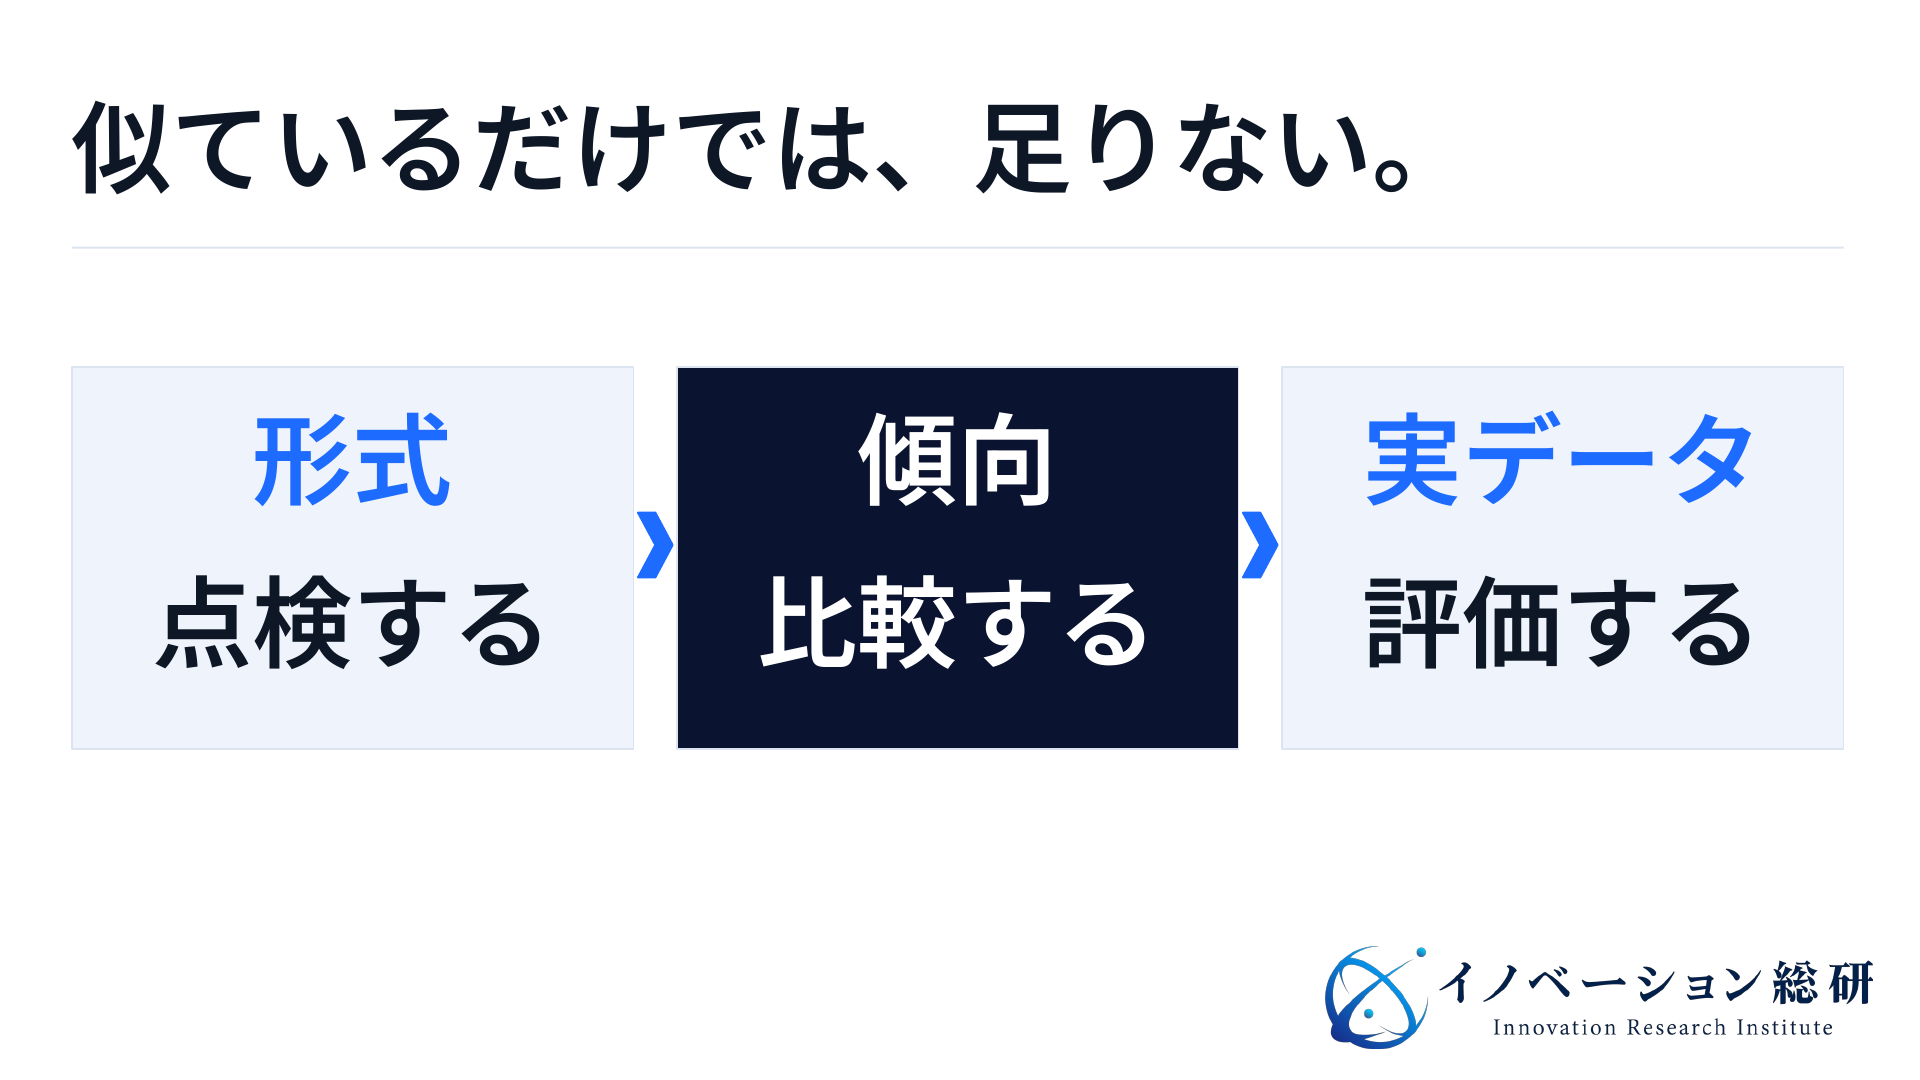
合成データの品質は、一つの点数では判断できません。形式が正しいこと、必要な傾向を再現すること、利用先で成果が出ることを分けて確認します。
まず、形式と関係を確かめます。注文番号が重複していないか、発送日が注文日より前になっていないか、返金額が支払額を超えていないか。こうした業務の条件に反すれば、学習やテストの前に修正が必要です。
次に、必要な傾向を見ます。売上の平均が近くても、繁忙期の変動が消えていれば、在庫計画には使いにくくなります。全体の平均だけでなく、用途に関係する顧客層や場面に分けて比べます。
最後に、実データで仕事の結果を確かめます。AIの学習なら、合成データを使わない場合と、加えた場合を比べます。評価に使う実データは、生成方法の調整や学習に使ったものと分けておきます。同じ問題を練習と採点の両方に使うと、実力を高く見積もるためです。
返品のテストなら、何を合格にするのか
冒頭の通販の例なら、テスト用の記録が何件あるかより、必要な処理を試せるかを見ます。全品返品、一部返品、発送前の取り消し、返金の失敗など、業務で起こり得る条件をそろえます。
「一部返品の後に、残りの商品も返品した」という場合はどうでしょう。最初の返金額と次の返金額の合計が正しいかを確認する必要があります。個々の表の見た目だけでは、この不具合は見つかりません。
この例での合格条件は、必要な処理が試せ、期待する結果と照合できることです。AIの正答率と同じものさしを無理に使う必要はありません。顧客の困りごとに合わせて、評価の単位を決めます。
プライバシーの確認は、品質の評価と別に行う
人工的なデータでも、元の人について推測できる情報が残る場合があります。英国の情報保護当局ICOも、合成データから元のデータの特徴が推測され得ることを説明しています。これは技術的な注意点であり、日本の個別案件の適法性を判断するものではありません。ICOの解説
合成しただけで、匿名性や法令適合が保証されるわけではありません。元データを使う権限、生成中の保管場所、出力に残る情報、提供先での利用条件を分けて確認します。必要に応じて、法務や情報管理の担当者、外部の専門家と判断します。
生成費用だけで、安くなるかを判断しない
合成データの費用は、生成サービスの料金だけではありません。元データの整理、業務ルールの設定、品質の評価、誤りの修正、運用への組み込みが加わります。
画像なら、物体や現場の再現に費用がかかることがあります。表なら、複数のシステムの項目をそろえる作業が必要です。文章なら、専門家が正解を確認する費用を見落とせません。
比較する相手も、単純な「実データの収集費用」だけではありません。既存のテストデータを整備する方法、必要な場面だけ追加収集する方法、対象業務を絞る方法も候補になります。合成データを使う前提で費用を計算しないことが大切です。
イノベーション総研では、顧客にとって減る負担と、供給側に残る手間を分けて考えます。テスト準備が速くなっても、供給側が毎回手作業で修正していれば、継続するほど収支が苦しくなるかもしれません。
料金の説明も、生成件数だけに寄せる必要はありません。対象業務の設定、評価レポート、更新対応など、実際に提供する仕事と結びつけます。ただし、顧客が理解できない細かな料金項目を増やすより、どこまで含むかを明確にする方が重要です。
合成データで新規事業を始める三つの入口
生成の基盤を持つ企業と、同じ土俵で競う必要はありません。顧客の業務、現場への接点、品質を確かめる力を持っていれば、それを生かす入口を考えられます。以下は、8社の取り組みを踏まえたイノベーション総研の分析です。掲載企業が提携先を募集しているという意味ではありません。
| 参入の入口 | 最初の顧客と支払者 | 提供する仕事 | 必要な資産・提携先 | 収支を左右する点 |
|---|---|---|---|---|
| 業務別のテストデータ | 企業の開発・品質管理部門 | 例外を含むデータとテスト条件を整える | 業務知識、既存システムの情報、生成製品の提供者 | 顧客ごとの設定・更新にかかる人手 |
| 現場別の画像・仮想環境 | 工場、ロボット、自動運転の開発部門 | 苦手な場面を再現し、評価環境につなぐ | 現場への接点、設計情報、実機で評価する相手 | 再現の費用、現場変更への対応 |
| 用途別の品質評価 | データを提供・利用する企業の責任部門 | 評価項目、未確認範囲、更新後の差を示す | 評価用の実データ、専門知識、情報管理の専門家 | 評価責任、再評価の頻度、説明の工数 |
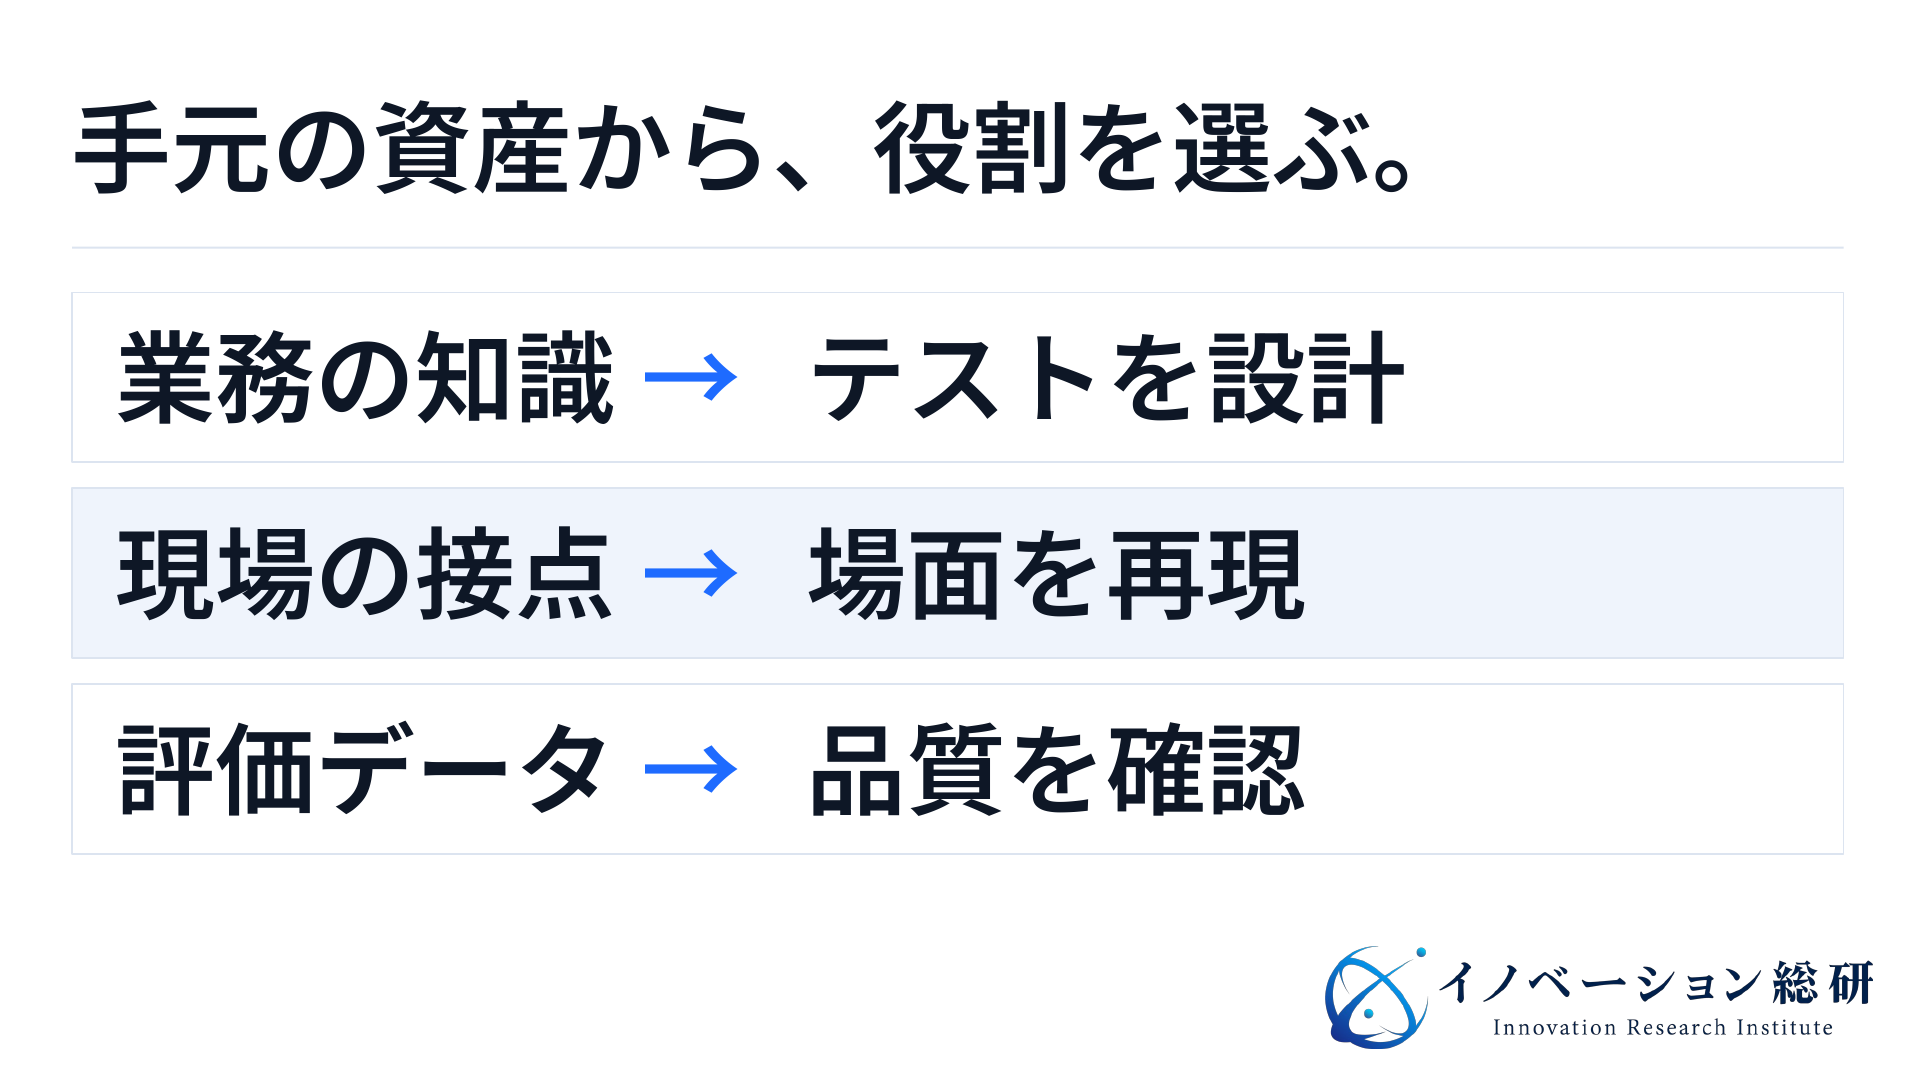
三つの入口は、顧客が買うものが違います。テストの準備を減らしたいのか、現場の失敗を再現したいのか、データを使う判断を助けてほしいのか。自社の技術より先に、この違いを顧客と確かめる必要があります。
入口1:業界の例外を、テストできる形にする
受発注、保険、決済などの業務では、通常の流れより、取り消しや訂正で問題が起きることがあります。その例外を知る企業は、テスト条件を商品にする道を考えられます。
たとえば、業務システムを長く支援してきた企業なら、顧客がよく困る処理を整理できます。生成の仕組みは既存製品を使い、業務の条件と確認方法を自社の提供価値にする形です。
懸念は、顧客固有の仕様に引きずられることです。毎回すべて作り直すなら、共通の商品として広げにくくなります。対象を一つの業務に絞り、共通部分と個別部分を見極める必要があります。
入口2:現場の失敗を、再現できる環境にする
工場や物流の現場を知る企業なら、ロボットや画像認識が苦手な状況を集める役割が考えられます。単に画像を納品するのではなく、何が変わると失敗するのかを説明できる環境を提供します。
ここでは、現場の設計情報や撮影条件が資産になります。ただし、取引先の図面や映像を、他社向けの商品に転用してよいとは限りません。利用範囲を確かめ、共有できる部分と顧客内に閉じる部分を分けます。
実機で確かめる相手がいない場合は、仮想環境の出来栄えだけで価値を判断しないことが必要です。設備会社や導入企業との提携を先に検討します。
入口3:何に使えるかを、第三者にも説明できるようにする
データを買う側は、「どのくらい本物に近いか」だけでは判断できません。どの条件で試したか、使えない場面は何か、更新後に何が変わったかを知る必要があります。
そこで、用途に合わせた評価と記録を提供する道が考えられます。品質の専門家だけでなく、対象業務を知る人が、結果の意味を説明する役割です。
ただし、「安全を保証する」「どんなAIでも精度が上がる」といった約束は避けます。評価した範囲、前提、責任の分担を明確にしなければ、案件が増えるほど負担も大きくなります。
データを増やしても、うまくいかない四つの条件
第一は、足りない場面を知らないことです。顧客が何に失敗しているかを把握せずに増やしても、必要な改善につながりません。収集、業務整理、対象の絞り込みが先になる場合があります。
第二は、元データの偏りを見落とすことです。特定の地域や顧客層に偏った記録から作れば、その偏りも引き継ぐ可能性があります。少ない事例を増やす場合も、実際には起きない組み合わせを作っていないかを確かめます。
第三は、生成した内容を無選別で使い続けることです。2024年のNature掲載論文は、モデルが作ったデータで学習を繰り返す条件で、元の分布の特徴が失われる問題を示しました。いわゆるモデル崩壊です。すべての合成データ利用で必ず起きる、という意味ではありません。Shumailovらの研究論文
第四は、確認に使う本物のデータがないことです。作ったデータ同士だけを比べても、現場で役立つかはわかりません。評価用の実データを持つ顧客や提携先は、生成の仕組み以上に重要になる場合があります。
データを増やす判断と、使う判断は分けておきましょう。どの条件で採用し、どの条件では使わないかを決めておくことが、誤った期待を防ぎます。
参入・提携・待機・見送りを分けるには
まず、自社が持つものを三つに分けます。対象業務を説明できる知識、利用できる権利のあるデータ、成果を確かめられる顧客や現場です。すべてを自社で持つ必要はありませんが、不足を曖昧にしたまま進めないことが大切です。
顧客の課題が明確で、必要なデータと評価の相手がそろうなら、参入を検討できます。業務の知識はあっても生成や評価の技術が足りないなら、既存製品や専門企業との提携が候補です。
元データの利用条件が未確認なら、その確認がつくまで待機します。現場での効果を評価できず、支払う部門も決まらないなら、見送りも選択肢です。市場の成長が期待されることと、自社が事業にできることは別だからです。
相談の前には、「誰の、どの仕事を、何から何へ変えるか」を一文で書いてみてください。続けて、現在のデータ準備にかかる手間、よく起きる失敗、利用できる資料、評価できる相手を整理します。生成件数の希望だけより、事業の条件を話しやすくなります。
AIを業務の中で動かすサービスまで考える場合は、AIエージェントの参入方法と合わせて読むと、データを作る役割と、運用を担う役割を分けられます。
イノベーション総研では、こうした顧客、提供価値、必要な資産、費用の負担者を整理します。事業案がまだ曖昧なら、無料診断Compassで現在地を確認できます。テーマ選びから事業の具体化まで相談したい場合は、事業開発支援サービスをご覧ください。個別の法令適合や情報保護の認証を代行する案内とは分けています。
合成データについてよくある質問
生成方法、安全性、AIの学習、参入条件について、間違えやすい点を整理します。
まとめ:合成データは、使い道と確かめ方をセットで考える
合成データは、集めにくい記録や場面を人工的に補う手段です。表、画像、文章で目的が異なり、8社の取り組みも、生成、接続、評価という別々の仕事を支えています。
本物に似ているだけでは、仕事で役立つとは限りません。形式と関係を点検し、必要な傾向を比べ、実データで成果を確かめます。プライバシーや利用条件は、それとは別に確認します。
新規事業では、生成件数を売る前に、顧客が困る場面を定めることが重要です。業務知識、現場への接点、評価できるデータのどれを持つかを整理すると、自社が担う仕事と、提携すべき相手が見えてきます。
CONTACT
お問い合わせ
合成データで、自社は誰のどの困りごとを解くか
顧客、支払者、必要なデータ、評価方法、継続する費用を整理します。参入、提携、待機、見送りを比べ、事業案を具体化します。個別の法令適合や匿名性の認証を保証する相談とは分けています。


