
投稿日:2026.09.05 最終更新日:2026.09.20
RAGは検索精度だけでは決まらない|主要9社と事業化の論点
RAGは、検索精度を上げれば成功するのか。
主要9社は、どこで違いを作っているのか。
結論は、情報の更新、権限、評価を一つの運用として回せるかです。企業事例から、導入と新規事業の判断材料を整理します。
この記事の結論
RAGの価値は、検索機能ではなく知識運用で決まります。
- RAGの仕組みを、文書処理から回答まで順に解説します。
- 国内外9社の役割を、4層の業界構造で比較します。
- 三つの参入ルートと、誤回答・権限・原価の責任を示します。
目次
RAGとは、情報を探してから生成AIに答えさせる仕組み
RAGは「Retrieval-Augmented Generation」の略で、日本語では検索拡張生成と呼ばれます。生成AIが質問へ答える前に、社内文書やデータベースから関係する情報を探し、その内容を根拠として回答を作る仕組みです。
たとえば、社員が「当社の出張費の上限はいくらですか」と質問したとします。一般的な生成AIは、会社固有の規程を知りません。RAGは最新の旅費規程を検索し、該当箇所を生成AIへ渡します。回答と一緒に文書名やページを示せば、利用者も根拠を確かめられます。
ただし、RAGを入れれば正しい回答が出るとは限りません。古い規程が残っていれば、古い情報を使います。閲覧権限を引き継げなければ、見てはいけない文書を回答に混ぜる恐れがあります。検索結果が適切でも、生成AIが意味を取り違える場合もあります。
この記事の結論は、RAGの成否は検索精度だけでなく、情報の更新、権限、評価を一つの運用として回せるかで決まるということです。主要9社の取り組みを比べ、導入と新規事業の判断材料を整理します。
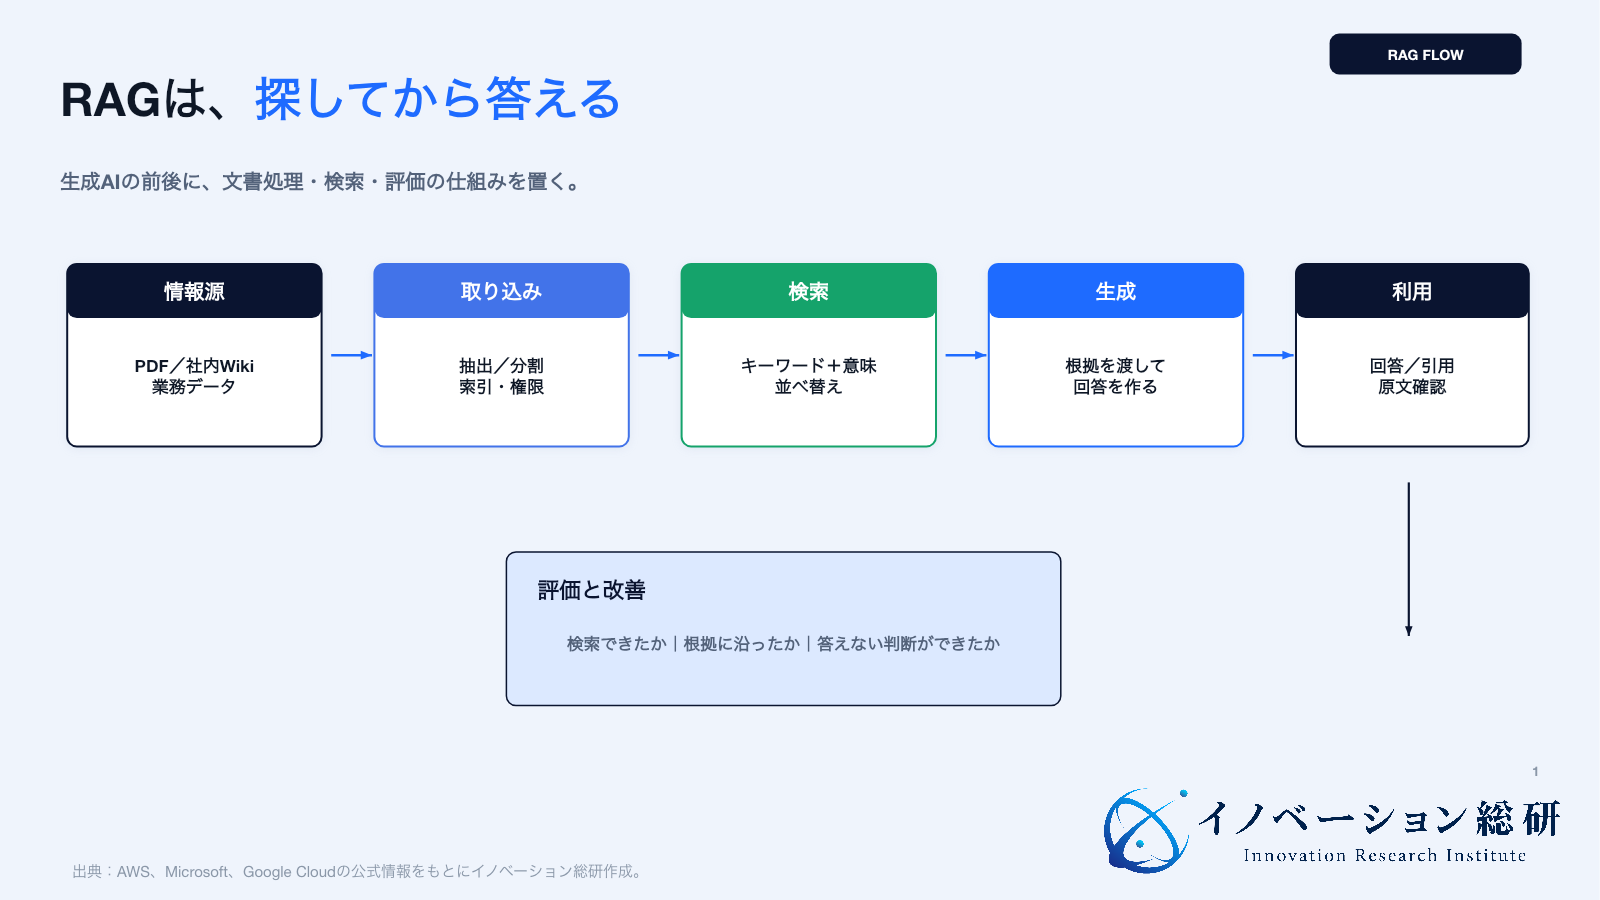
RAGは、検索と生成の間に四つの処理を置く
まず、PDF、社内Wiki、ファイルサーバー、業務データなどを取り込みます。次に、文書を検索しやすい大きさへ分け、内容を数値の並びに変換して索引へ登録します。この数値表現をベクトルと呼び、意味が近い文章を探すために使います。
質問を受けると、キーワード検索やベクトル検索で候補を集めます。その後、質問との関係が強い順に並べ直します。この処理がリランキングです。最後に、選んだ情報と回答ルールを生成AIへ渡し、出典付きの文章を作ります。
ここで大切なのは、生成AIより前の処理です。表の読み取りに失敗した、文書の分け方が悪い、検索対象に最新情報がない。この場合、強い生成AIへ替えても回答は良くなりません。
検索、引用、回答不能の三つを分けて評価する
RAGの評価では、「良い答えだったか」だけを見ない方がよいでしょう。少なくとも三つに分けます。
- 必要な情報を検索できたか。
- 回答が検索した情報に沿っているか。
- 根拠がないときに、答えない判断ができたか。
検索できない問題と、生成AIが間違える問題は、直す場所が違います。評価を分けると、文書処理、検索設定、プロンプト、生成AIのどこを直すべきかが分かります。
社内情報の鮮度と根拠が求められる理由
生成AIは、学習した時点より後の社内情報を自動では知りません。また、契約書、設計書、顧客対応履歴など、社外へ出せない情報を一般向けAIの学習に使うことも現実的ではありません。
RAGは、生成AIそのものを学習し直さず、検索対象を更新できます。就業規則が変われば索引を更新し、新しい規程を回答へ使わせます。回答に引用元を付けられるため、利用者が原文へ戻る導線も作れます。
企業で使われる主な用途は、社内検索、問い合わせ対応、営業提案、調査、契約書の確認、保守支援です。共通するのは、公開情報だけでは答えられず、根拠を確かめる必要がある仕事です。
| 業務 | RAGが探す情報 | 利用者へ返すもの | 人が残す判断 |
|---|---|---|---|
| 社内問い合わせ | 規程、手順書、FAQ | 回答案と根拠ページ | 例外承認、規程解釈 |
| 営業提案 | 商品資料、導入事例、顧客履歴 | 提案の下書き、類似事例 | 顧客への約束、価格 |
| 調査・分析 | 報告書、開示資料、ニュース | 比較表、論点、引用 | 投資・経営判断 |
| 契約確認 | 契約書、ひな型、法務メモ | 条項の抽出、差分 | 法的判断、交渉方針 |
| 保守支援 | マニュアル、障害履歴、部品情報 | 原因候補、確認手順 | 操作、停止、復旧 |
一方、RAGは計算の正しさや、業務の最終判断を保証する仕組みではありません。検索した文書同士が矛盾する場合もあります。規程の例外や顧客との個別契約は、文章を見つけるだけでは決められません。検索で助ける範囲と、人が承認する範囲を分ける必要があります。
RAG市場は「社内検索」からAIエージェントの知識基盤へ動く
初期のRAGは、質問へ一度検索し、一度回答する構成が中心でした。現在は、複雑な質問を小さく分け、複数の検索を行い、結果をまとめる方向へ進んでいます。Microsoftは、複雑な質問を副質問へ分解し、キーワード検索とベクトル検索を並行して行う「agentic retrieval」をAzure AI Searchで提供しています。
この変化は、RAGがチャット画面の裏側だけでなく、AIエージェントが仕事を進めるための知識基盤になることを意味します。たとえば、営業支援エージェントが顧客情報を調べ、提案書を作り、承認を依頼する場合、検索は一回では終わりません。顧客、商品、契約、過去事例を順に確認します。
もう一つの変化は、文字以外への対応です。NVIDIA NeMo Retrieverは、文章だけでなく、表や画像を含む文書の取り込みを扱います。Google CloudのVertex AI RAG Engineも、データ取り込み、索引、検索、生成AIへの接続を管理サービスとしてまとめています。
そのため、競争の中心は「ベクトル検索ができるか」から移りつつあります。複数のデータ源を安全につなぐ、表や画像を正しく読む、複数回の検索過程を記録する、品質と費用を継続して測る。この運用全体が差になります。
業界構造は、文書処理から業務アプリまでの4層で見る
RAG市場には、クラウド企業、検索企業、データベース企業、生成AI企業、業務アプリ企業が並びます。同じ「RAG」という言葉を使っていても、担う範囲は違います。4層に分けると、自社に足りない機能と提携先が見えます。
| 層 | 主な仕事 | 代表的な機能 | 主な企業 |
|---|---|---|---|
| 1. 文書処理・接続 | 情報源をつなぎ、検索可能にする | コネクター、OCR、表・画像抽出、分割 | AWS、Google、NVIDIA、Stockmark |
| 2. 検索・知識基盤 | 必要な情報を速く探す | ベクトルDB、全文検索、知識グラフ | Microsoft、Pinecone、Neo4j |
| 3. RAG運用 | 検索手順と回答品質を制御する | リランキング、権限、評価、監視 | AWS、Microsoft、Google、Stockmark |
| 4. 業務アプリ | 利用者の仕事へ組み込む | 社内検索、調査、文書分析、AIエージェント | Glean、Hebbia、各業務SaaS企業 |
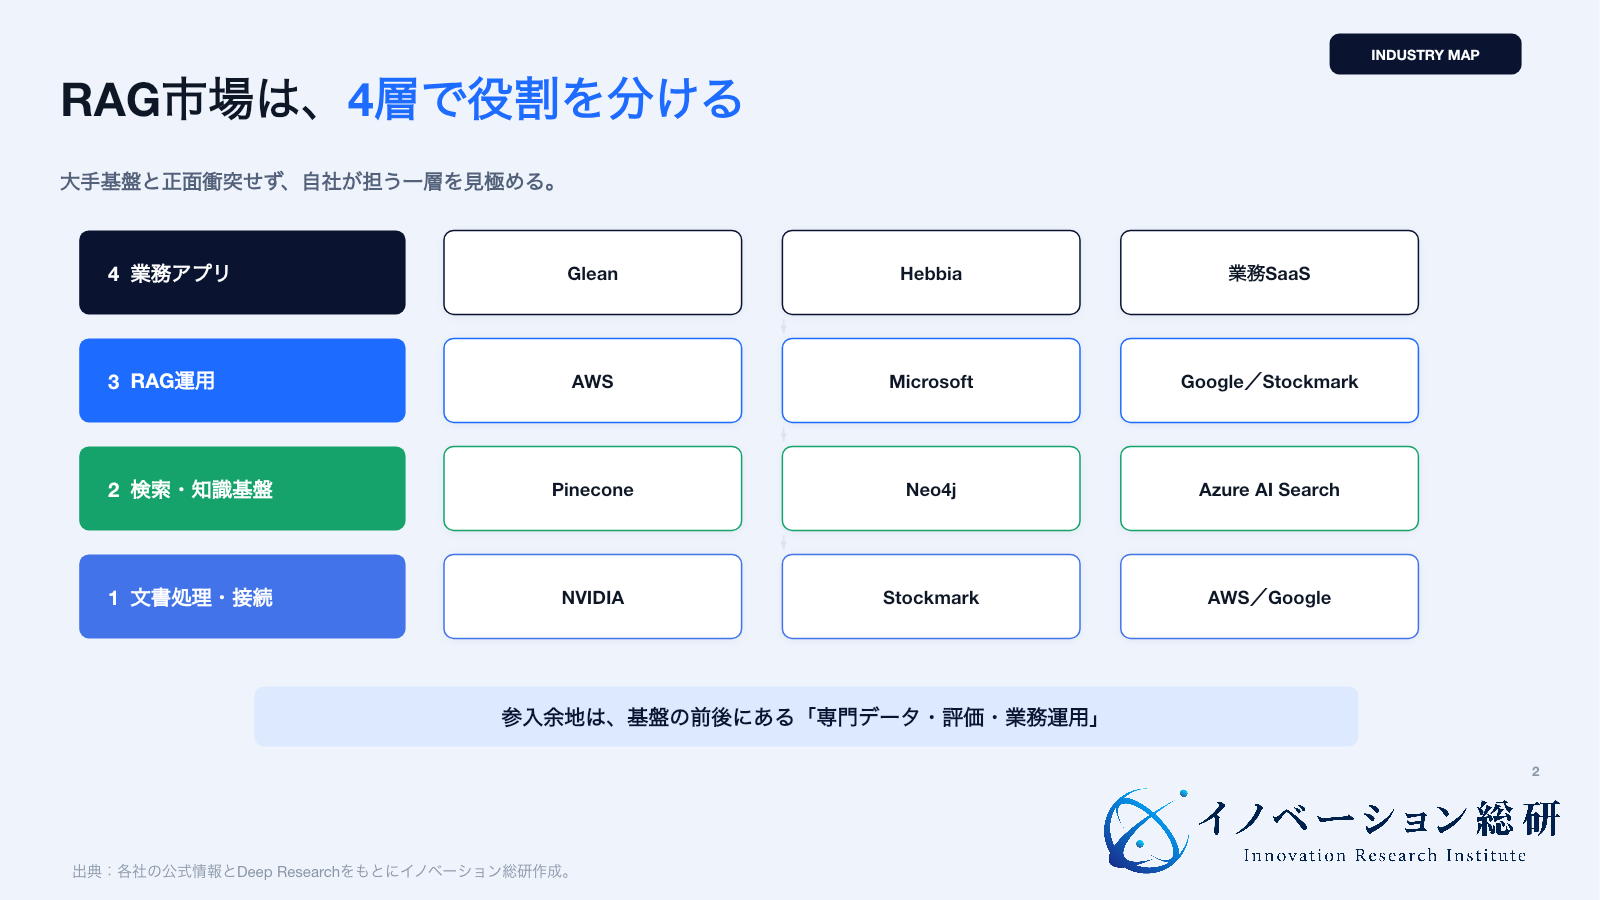
大手クラウドは、1層から3層までを一つのサービスにまとめています。GleanやHebbiaは、4層の業務体験に強みを置きます。Pineconeはベクトル検索、Neo4jは関係性をたどる知識グラフを中心にします。Stockmarkは、日本語の業務文書を取り込み、評価する部分に踏み込んでいます。
新規参入企業が4層すべてを自前で作る必要はありません。むしろ、既存基盤を使い、特定業界のデータ整備、評価、業務設計を担う方が現実的です。ただし、基盤企業へ依存する費用、データ移転、障害時の責任は事前に決めます。
RAGを進める主要9社は、どこで違いを作っているか
ここでは、国内外9社を取り上げます。各社の公式情報をもとに、何を提供し、RAGのどの課題を担うかを整理しました。製品の優劣ではなく、自社の用途に合う役割を見分けるための比較です。
| 企業 | 主な役割 | 公式情報から確認できる特徴 | 段階 |
|---|---|---|---|
| AWS | 管理型RAG基盤 | データ接続、取り込み、検索、引用、権限フィルター | 商用提供 |
| Microsoft | 検索・エージェント検索 | 質問分解、並列検索、ハイブリッド検索、意味順の並べ替え | 商用提供・一部プレビュー |
| Google Cloud | 管理型RAG基盤 | データ取り込み、ベクトル保存、検索、モデル接続 | 商用提供 |
| NVIDIA | 文書処理・検索部品 | 文章、表、画像の抽出、埋め込み、リランキング | 商用提供 |
| Glean | 企業内検索 | 社内システム横断、権限継承、企業知識グラフ | 商用提供 |
| Hebbia | 専門業務の調査 | 複雑な仕事の分解、複数文書の並列分析、確認可能な表 | 商用提供 |
| Stockmark | 日本語文書の構造化・評価 | 表や画像の抽出、知識グラフ、QAによる自動評価 | 商用提供・機能拡張 |
| Neo4j | GraphRAG | 企業・人物・契約などの関係をグラフで検索 | 商用提供 |
| Pinecone | ベクトル検索基盤 | 管理型ベクトルDB、メタデータ検索、企業向け配備 | 商用提供 |
AWSは、RAGの取り込みから引用までを管理サービスにする
Amazon Bedrock Knowledge Basesは、データの取り込み、索引、保存、検索、生成AIへの受け渡しを管理します。Amazon S3だけでなく、SharePoint、Confluence、Google Drive、OneDriveなどのコネクターも案内しています。
企業導入で重要なのは、文書ごとのアクセス権を検索結果へ反映できる点です。社員が元の文書を見られないなら、RAGの回答にも使わせない設計が必要です。AWSをすでに使う企業には選択肢が多い一方、データ源ごとの権限対応と利用費の監視は別途必要です。
Microsoftは、複雑な質問を分けて探す仕組みへ進む
Azure AI Searchのagentic retrievalは、複雑な質問を複数の副質問へ分け、キーワード検索とベクトル検索を並行して実行します。結果を意味の近さで並べ直し、出典と検索過程を返します。
Microsoft 365やAzureに情報が集まる企業では、検索とAIエージェントを同じ基盤で設計しやすくなります。一方、一部の機能はプレビューを含みます。本番で使う範囲は、提供状態、地域、SLA、費用を分けて確かめる必要があります。
Google Cloudは、RAG基盤をモデルや保存先から切り離す
Vertex AI RAG Engineは、データ取り込み、文書分割、ベクトル化、検索、生成AIへの接続を管理します。Googleは、モデル、ベクトル保存先、データ源を用途に合わせて選べる点を示しています。
これは、特定の生成AIだけに固定せず、業務ごとに構成を変えたい企業に向きます。ただし、選択肢が増えるほど、どの構成を標準にするかという設計負担も増えます。自由度と運用の簡単さを同時には最大化できません。
NVIDIAは、表や画像を含む文書の前処理を狙う
NVIDIA NeMo Retrieverは、文書の索引作成と検索に使うマイクロサービス群です。文字だけでなく、表や画像を含む文書の抽出、埋め込み、リランキングを扱います。
製造、医療、建設、金融では、重要情報が表、図、帳票に入っています。単純な文字抽出では、行と列の対応や図の意味が崩れます。NVIDIAの取り組みは、RAGの品質が生成AIより前の文書処理で決まることを示しています。
Gleanは、権限を守る社内検索を仕事の入口にする
Gleanは、複数の社内システムを横断して検索するサービスです。元のシステムの権限を尊重し、内容、活動、利用者情報から企業の知識グラフを作ると説明しています。
特徴は、RAGの部品を売るのではなく、社員が毎日使う検索体験を提供する点です。企業名、プロジェクト、担当者の関係まで使えば、同じ言葉を含む文書を探すだけでなく、仕事の文脈に合う情報を出せます。新規参入では、この利用画面と顧客接点にどう差を作るかが問われます。
Hebbiaは、専門家の調査過程を見える形にする
HebbiaのMatrixは、複雑な仕事を分け、多数の文書を並行して分析し、結果を表の形で見せます。金融、法律、コンサルティング、製薬など、根拠確認が必要な専門業務を主な用途に挙げています。
単一の回答だけでなく、どの文書のどこから判断したかを列ごとに確認できる点が重要です。RAGを会話画面から専門業務の作業台へ変えています。専門家が最終判断をする前提で、調査時間を短くする設計です。
Stockmarkは、日本語文書の構造化とRAG評価をつなぐ
StockmarkのSATは、表や画像を含む文書から情報を抽出し、RAGで使いやすい形へ構造化するサービスです。さらに、質問と回答を使った自動評価により、複数の設定を比較し、回答が良くなった理由まで分析すると説明しています。
日本企業では、紙から変換したPDF、独自用語、長い報告書が多くあります。Stockmarkは、検索エンジンそのものより、企業データを検索可能にする前処理と評価に価値を置いています。国内の導入支援会社にとって、提携対象にも競合にもなり得ます。
Neo4jは、関係をたどるGraphRAGを提供する
Neo4jのGraphRAGは、文書から企業、人物、商品、契約などを取り出し、その関係をグラフとして保存します。ベクトル検索と組み合わせ、複数の関係をたどる質問へ答えます。
たとえば、「この部品を使う製品と、その供給企業に関係する規制は何か」という質問は、似た文章を探すだけでは難しい場合があります。関係性を明示すると、答えへ至る道筋を追いやすくなります。ただし、グラフの設計と更新には手間がかかります。すべての用途をGraphRAGにするのではなく、関係が価値を持つ業務へ絞ります。
Pineconeは、ベクトル検索の運用負担を引き受ける
Pineconeは、RAG向けの管理型ベクトルデータベースを提供します。大量のベクトルを保存し、質問に近い情報を高速に検索します。メタデータによる絞り込みや、企業向けの配備方法も用意しています。
RAGを自社開発する企業には、検索基盤を一から運用しなくてよい利点があります。一方、ベクトルDBだけでは、文書の更新、権限、回答評価、利用画面は完成しません。Pineconeを使う場合も、誰が残りの工程を担うかを決めます。
主要9社から見える三つの競争軸
9社を横断すると、競争軸は三つに整理できます。
第一は、情報へ安全につなぐ力です。GleanやAWSは、複数の情報源と権限の引き継ぎを重視します。コネクターが多いだけでなく、更新の検知、削除の反映、アクセス権の再現が必要です。接続先が増えるほど、企業は基盤を替えにくくなります。
第二は、難しい文書と質問を扱う力です。NVIDIAとStockmarkは表や画像の処理、Microsoftは質問の分解、Neo4jは関係の検索に力を置きます。単純な社内FAQを超えると、検索方法を一つに固定できません。
第三は、業務の最後までつなぐ力です。Gleanは日常の社内検索、Hebbiaは専門調査の作業台を提供します。RAGをAPIとして提供するだけでなく、利用者が根拠を確認し、修正し、次の行動へ移れる画面を持っています。
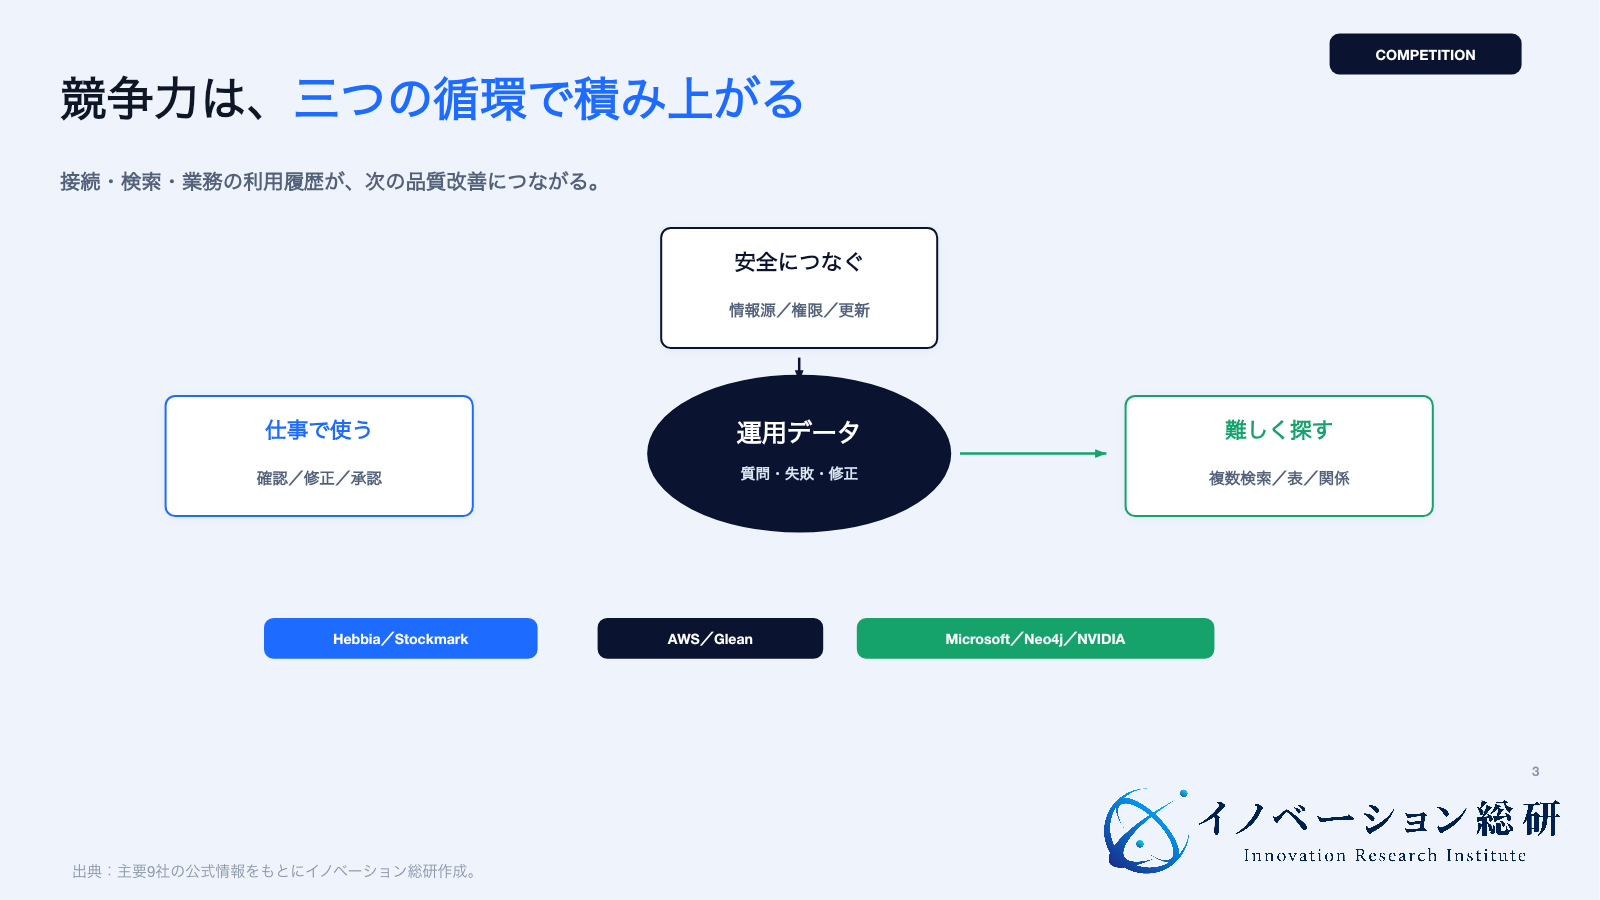
三つに共通するのは、企業固有の情報と利用履歴が積み上がる点です。どの文書が役立ったか、どの質問に答えられなかったか、誰が回答を修正したかが蓄積されると、同じ機能を導入した競合より品質を上げられます。この運用データが、RAG事業の防御力になります。
導入でRAGが失敗するのは、検索以外の設計が抜けるから
RAG導入の失敗は、検索精度が少し低いことだけではありません。現場で使われない、機密情報が漏れる、費用が増え続ける、誤回答の責任を決められない。この四つが事業上は深刻です。
最初の問題は、情報の正本が決まっていないことです。同じ規程の旧版と新版が別の場所にあれば、RAGは両方を検索します。文書の所有者、更新日、失効日を管理しないまま取り込むと、回答の根拠を示しても正しさは担保できません。
次は権限です。検索基盤側で部署や役職を見ず、生成AIの画面だけにログインを付ける設計では不十分です。検索する時点で、利用者が閲覧できる文書へ絞る必要があります。ゼロトラストと同じく、利用者、情報、状況を結び付けて判断します。
第三は評価です。見栄えの良い数件だけで判断すると、珍しい質問や新しい規程に弱いまま公開されます。頻出質問、答えがない質問、複数文書の比較、権限違反を含む評価セットを作り、変更のたびに再確認します。
第四は費用です。複雑な質問を何度も検索し、長い文書を生成AIへ渡すと、検索と生成の費用が増えます。品質だけを追うと、一件の問い合わせにかかる原価が人手を超えることもあります。回答時間、検索回数、利用モデル、キャッシュを測ります。
| 失敗要因 | 表面に出る症状 | 原因を確かめる指標 | 主な対策 |
|---|---|---|---|
| 文書が古い | 回答の根拠が旧版 | 更新反映時間、失効文書数 | 所有者、期限、削除連携を決める |
| 権限が弱い | 見てはいけない内容が出る | 権限テスト、不正検索件数 | 文書単位のACLを検索時に適用 |
| 評価がない | 改修後に別の回答が悪化 | 検索再現率、根拠一致、回答不能率 | 固定評価セットで回帰試験 |
| 費用が見えない | 利用増で赤字になる | 一回答原価、検索回数、入力文字量 | 用途別モデル、上限、キャッシュ |
| 業務につながらない | チャットが使われなくなる | 継続率、原文遷移、業務時間 | 承認・記録・修正まで組み込む |
まだ埋まっていない市場は、ナレッジ運用と専門業務にある
汎用のベクトルDB、クラウドRAG基盤、社内検索には大手企業がいます。新規参入が同じ機能を安く作るだけでは、価格と販売力で不利になります。空白は、既存基盤の前後にある仕事です。
一つ目は、ナレッジ運用です。文書の所有者を決め、重複と旧版を見つけ、更新を促し、検索できない質問から不足情報を特定します。情報を取り込む作業ではなく、企業の知識を使える状態に保つ継続サービスです。
二つ目は、専門業務です。製造の不具合解析、医療機器の規制確認、保険の査定、建設の安全管理など、用語、文書形式、責任が固有の領域です。業界の評価問題と業務画面を持てれば、汎用RAGとの差を作れます。
三つ目は、監査可能性です。どの情報を検索し、何を生成AIへ渡し、誰が回答を承認したかを残します。規制産業や重要な判断では、回答精度だけでなく、後から説明できることに価値があります。
四つ目は、GraphRAGの運用です。関係性が重要な業務では有効ですが、知識グラフの設計、重複統合、更新、費用が障壁になります。業界の共通モデルと更新サービスを持つ企業には機会があります。
NEXT STEP
次のステップ
RAGの機能ではなく、自社に残る資産を選ぶ。
顧客、固有データ、専門家、評価問題、運用原価を棚卸しし、RAGで継続して担える一つの仕事を具体化します。
新規事業では、RAGの三つの参入ルートが考えられる
イノベーション総研では、RAGへの参入を三つに分けます。どれを選ぶかは、技術より、自社が持つ顧客、データ、専門家で決まります。
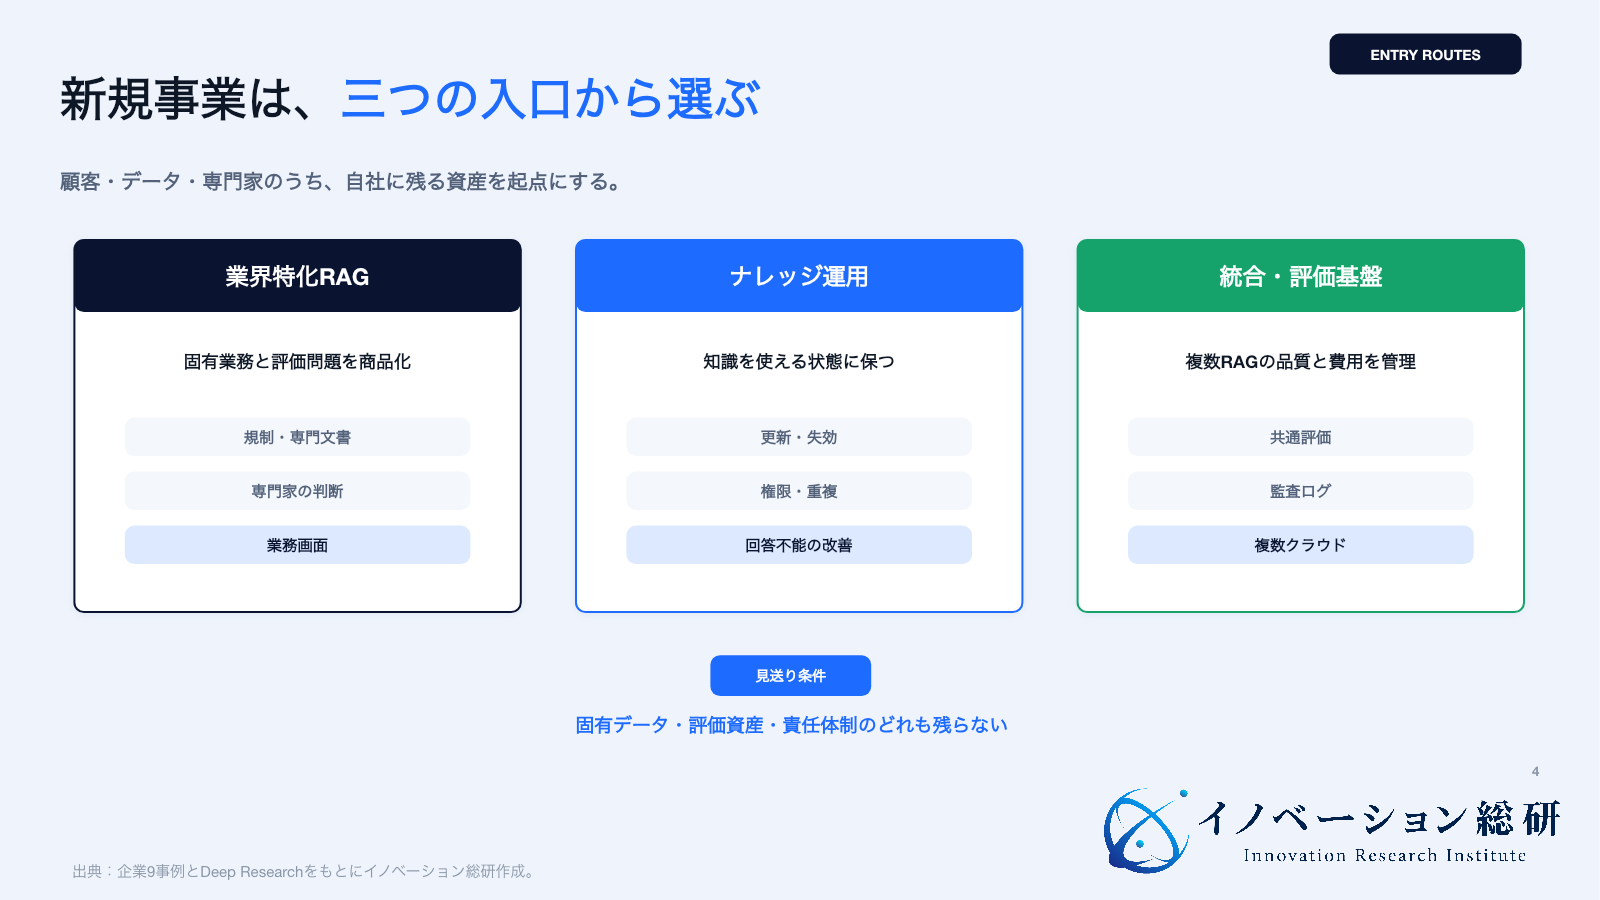
| 参入ルート | 主な顧客 | 商品にする仕事 | 必要な資産 | 主な提携先 | 最大の懸念 |
|---|---|---|---|---|---|
| 業界特化RAG | 規制・専門文書が多い企業 | 業界文書の検索、評価、業務画面 | 専門家、評価問題、顧客接点 | クラウド、生成AI、業務SaaS | 誤回答の責任が重い |
| ナレッジ運用サービス | 社内情報が散在する中堅・大企業 | 文書整備、権限、品質、更新の運用 | 情報管理ノウハウ、運用体制 | 社内検索、文書管理、SIer | 人手原価が増えやすい |
| RAG統合・評価基盤 | 複数のRAGを持つ大企業 | 共通評価、監視、費用管理、監査 | 評価データ、連携技術、運用ログ | AWS、Microsoft、Google、DB企業 | 基盤機能へ吸収される |
業界特化RAGは、正解より「判断の型」を持つ
業界特化では、公開文書を検索できるだけでは弱いでしょう。顧客が持つ固有データと、専門家が使う判断手順を組み込みます。保険なら約款と査定基準、製造なら図面と不具合履歴、建設なら施工計画と安全基準です。
競争力になるのは、業界の質問集、正しい根拠、答えてはいけない条件です。顧客のデータを共有学習に使えない場合でも、評価問題と運用設計は自社の資産になります。
ナレッジ運用は、検索できない理由を直す継続事業にする
導入時のデータ移行だけでは、売上が一度で終わります。毎月、重複文書、更新の遅れ、回答不能、権限エラーを分析し、文書の担当部署へ改善を返すサービスにします。
注意点は採算です。顧客ごとに人が文書を読み続けると、利用が増えるほど原価も増えます。標準の品質指標、自動検査、担当者向け画面を持ち、専門家が見る例外を絞ります。
RAG統合・評価基盤は、複数部署を横断する企業に向く
大企業では、各部署が別々のRAGを作り始めます。使う生成AI、検索基盤、評価方法が違うと、費用とリスクを比較できません。共通の評価セット、ログ形式、権限試験、費用画面を提供する余地があります。
ただし、クラウド企業も評価と監視の機能を拡張しています。単なる管理画面は吸収されやすいでしょう。業界監査、複数クラウド、既存システムまで横断する能力が必要です。
責任分界は、RAGの回答ルールより先に決める
RAGには、データを持つ顧客、基盤を提供するクラウド企業、検索・生成AIの企業、導入会社、業務の利用者が関わります。誤回答や情報漏えいが起きたとき、誰が何を確認するかを契約と運用で決めます。
| 場面 | 顧客が持つ責任 | 提供者が持つ責任 | 先に合意すること |
|---|---|---|---|
| 文書の正しさ | 正本、所有者、失効を決める | 取り込みと削除を正しく反映する | 更新頻度、反映時間、例外 |
| アクセス権 | 閲覧できる人を承認する | 検索時に権限を適用する | 権限の正本、テスト、ログ |
| 回答品質 | 最終判断と業務利用を管理する | 検索・回答の品質を測り改善する | 合格基準、回答不能、承認範囲 |
| 障害・費用 | 重要業務と予算上限を決める | 原因切り分け、復旧、利用量を示す | SLA、縮退運転、費用上限 |
| 事故対応 | 対外判断と通知を行う | 証拠を保全し、影響範囲を調べる | 初動時間、連絡先、再発防止 |
「AIが作った回答なので保証しない」とだけ書いても、利用者は守れません。どの用途なら参考情報として使えるか、どの用途は人の承認が必要か、何を自動実行してはいけないかを画面と権限で制御します。
特に、AIエージェントと組み合わせる場合は、検索結果が次の操作につながります。誤った回答が、発注、送信、設定変更へ進む恐れがあります。検索、提案、承認、実行を分け、取り消せない操作の前には人の確認を置きます。
RAGへの関わり方を4つに分けて考える
参入:顧客・データ・専門家がそろう
一つの業界、一つの判断業務へ絞って商品化します。
提携:顧客接点か技術の片方が足りない
クラウド、検索、文書管理の企業と責任を分けます。
待機:利用頻度と一回答原価が読めない
有償の小規模利用から継続率と原価を確認します。
見送り:固有資産と責任体制が残らない
汎用チャットの再販売に留め、別の顧客課題を選びます。
自社は参入・提携・待機・見送りのどれか
RAG市場が伸びていても、すべての会社が参入すべきではありません。次の四つに分けて考えます。
| 判断 | 選ぶ条件 | 次の行動 |
|---|---|---|
| 参入 | 特定業界の顧客、データ、専門家、責任体制がある | 一つの業務へ絞り、評価問題と運用を商品化 |
| 提携 | 顧客か専門性はあるが、検索・AI基盤が足りない | クラウド・DB企業と役割、粗利、事故対応を合意 |
| 待機 | 技術はあるが、利用頻度と原価が読めない | 有償の小規模業務で継続率と一件原価を確認 |
| 見送り | 汎用チャット以外の差がなく、誤回答の責任も持てない | 再販売に留めるか、別の顧客課題を選ぶ |
見送り条件は明確です。顧客データへ継続してアクセスできない、正解データを作れる専門家がいない、権限を検索へ反映できない、回答の利用範囲を制御できない、顧客ごとの手作業を減らせない。このどれかが解けないなら、RAG事業の拡大は危険です。
イノベーション総研では、RAGの事業性を「顧客の切実さ」「固有データへの接点」「評価資産」「業務への組み込み」「継続運用の粗利」「責任を持てる範囲」で見ます。検索精度のデモより、使われ続ける条件と事故時の設計を重視します。
RAGに詳しい相談先は、評価と運用を説明できるかで選ぶ
相談先を選ぶときは、対応できる生成AIの数だけを見ない方がよいでしょう。次の質問に具体的に答えられるかを確認します。
- 検索の失敗と生成AIの失敗を分けて評価できるか。
- 文書の更新、削除、重複、権限を継続して管理できるか。
- ベクトル検索、キーワード検索、GraphRAGを用途で使い分けられるか。
- 一回答の費用と、利用が増えたときの運用原価を示せるか。
- 誤回答、情報漏えい、障害時の責任分界を設計できるか。
- 生成AIを使わない検索や既存FAQも、中立に比較できるか。
良い相談先は、最初から大きなRAG基盤を勧めません。業務で困っている質問、利用者、正本データ、誤った場合の影響を整理します。そのうえで、検索だけで十分か、RAGが必要か、GraphRAGまで必要かを判断します。
新規事業の相談でも同じです。「RAG市場が伸びる」ではなく、誰のどの仕事を引き受け、どのデータと評価が自社に残るかを具体化できる相手を選びます。
RAGに関するよくある質問
本記事のまとめ|RAGは知識運用で差がつく
RAGは、社内外の情報を検索し、その内容を生成AIへ渡して回答を作る仕組みです。最新情報や企業固有の情報を扱い、根拠を示せる点に価値があります。
一方、検索技術だけでは成功しません。文書の更新、閲覧権限、回答評価、費用、業務への組み込みが必要です。AWS、Microsoft、Google、NVIDIA、Glean、Hebbia、Stockmark、Neo4j、Pineconeの違いも、この4層のどこを担うかで理解できます。
新規事業では、汎用RAG基盤へ正面から参入するより、業界特化RAG、ナレッジ運用、統合・評価基盤が候補です。ただし、固有データ、評価資産、専門家、継続運用の粗利、責任範囲がなければ差は残りません。
RAGで何を答えるかより、誰の知識をどう保ち、どの判断まで安全につなぐか。この問いに答えられる企業が、検索機能ではなく事業を作れます。
主な出典
この記事は、各社の公式情報と「Enterprise RAG Market Research」をもとに構成しました。各機能や提供状態は、本文のリンク先で確認できます。
- AWS Amazon Bedrock Knowledge Bases
- Microsoft Azure AI Search agentic retrieval
- Google Cloud Vertex AI RAG Engine
- NVIDIA NeMo Retriever
- Glean Search FAQ
- Hebbia Matrix
- Stockmark SAT
- Stockmark RAG自動評価
- Neo4j GraphRAG
- Pinecone RAG
CONTACT
お問い合わせ
RAGを、検索デモで終わらない事業へ。
市場、主要企業、自社資産、提携先、評価、運用原価、誤回答の責任を整理し、参入・提携・待機・見送りの条件へ落とします。


