
投稿日:2026.09.05 最終更新日:2026.10.09
RAGは検索精度だけでは決まらない|主要9社と事業化の論点
RAGは、検索精度を上げれば成功するのか。
主要9社は、どこで違いを作っているのか。
結論は、情報の更新、権限、評価を一つの運用として回せるかです。企業事例から、導入と新規事業の判断材料を整理します。
この記事の結論
RAGでは、検索・生成の精度と、情報の更新・権限・評価を一緒に設計します。
- RAGの仕組みを、文書処理から回答まで順に解説します。
- 国内外9社の役割を、4層の業界構造で比較します。
- 三つの参入ルートと、誤回答・権限・原価の責任を示します。
目次
RAGとは、情報を探してから生成AIに答えさせる仕組み
RAGは「Retrieval-Augmented Generation」の略で、日本語では検索拡張生成と呼ばれます。生成AIが質問へ答える前に、社内文書やデータベースから関係する情報を探し、その内容を根拠として回答を作る仕組みです。
たとえば、社員が「当社の出張費の上限はいくらですか」と質問したとします。ところが、一般的な生成AIは、会社固有の規程を知りません。
そこで、最新版の旅費規程を検索対象へ反映したRAGが、該当箇所を生成AIへ渡します。さらに、回答と一緒に文書名やページを示せば、利用者も根拠を確かめられます。
ただし、RAGを入れれば正しい回答が出るとは限りません。たとえば、古い規程が残っていれば、古い情報を使います。
また、閲覧権限を引き継げなければ、見てはいけない文書を回答に混ぜる恐れがあります。さらに、検索結果が適切でも、生成AIが意味を取り違える場合もあります。
この記事の結論は、RAGの成否は検索精度だけでなく、情報の更新、権限、評価を一つの運用として回せるかで決まるということです。主要9社の取り組みを比べ、導入と新規事業の判断材料を整理します。
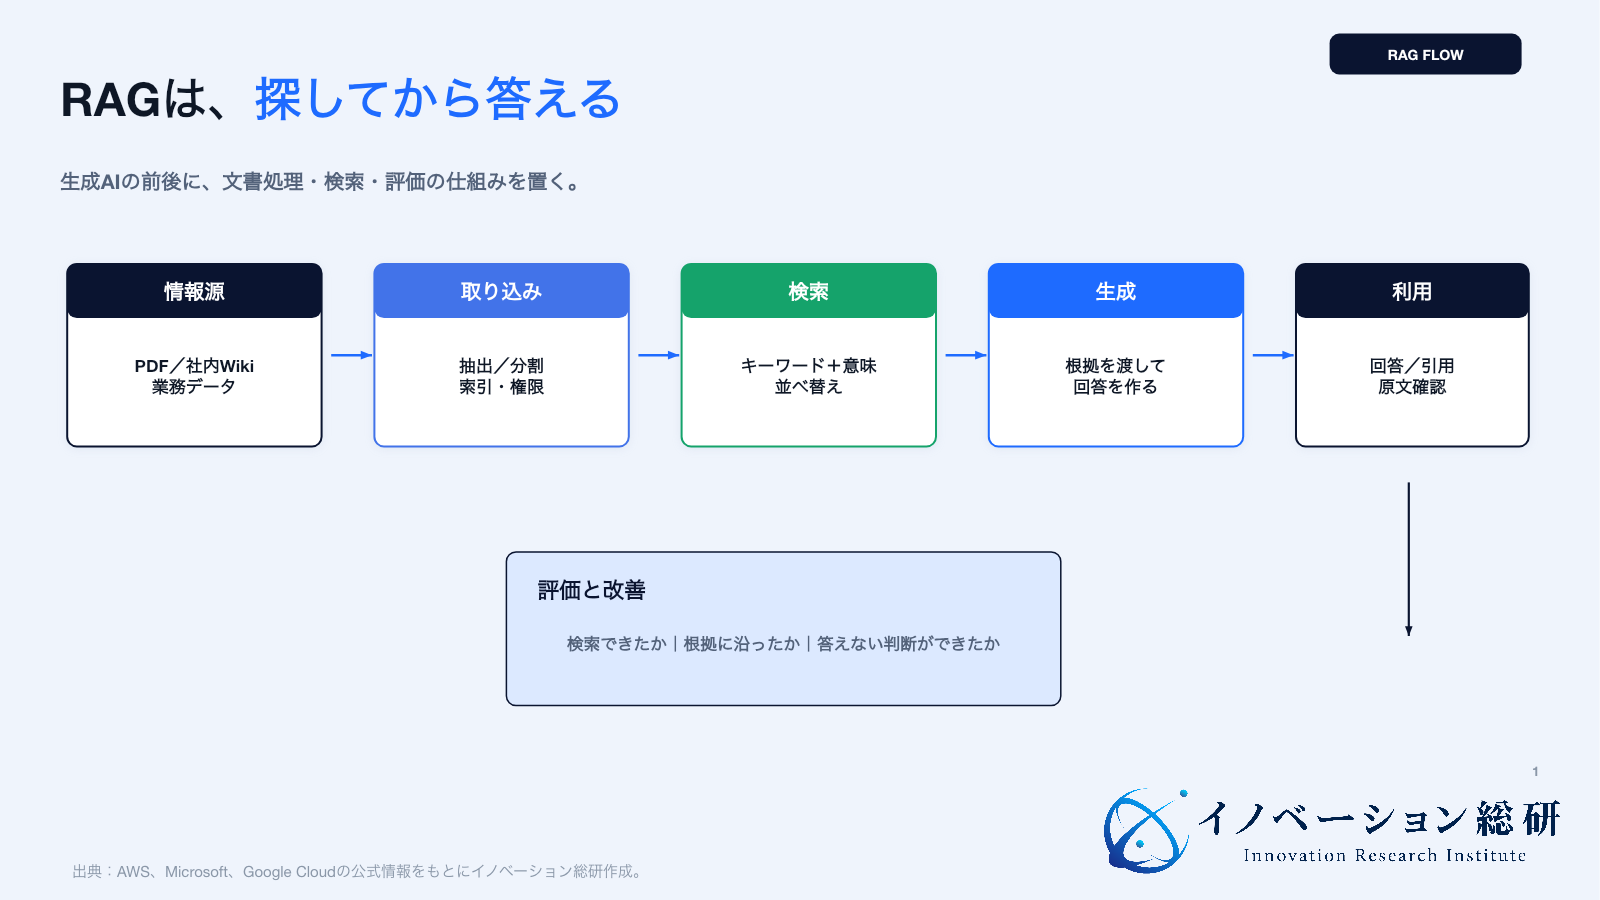
RAGは、文書の取り込みから検索・回答までをつなぐ
まず、PDF、社内Wiki、ファイルサーバー、業務データなどから必要な情報を取り込み、検索用の索引を作ります。ベクトル検索を使う場合は、文書を適切な大きさへ分け、内容を数値の並びへ変換します。
この数値表現が、意味の近い情報を探すためのベクトルです。
質問を受けると、キーワード検索、ベクトル検索、または両方を組み合わせた検索で候補を集めます。必要に応じて、質問との関連性で順序を付け直すリランキングを行い、選んだ情報と回答ルールを生成AIへ渡します。
すべてのRAGでベクトル化やリランキングが必須なわけではありません。
ここで大切なのは、生成AIより前の処理です。たとえば、表の読み取りに失敗した、文書の分け方が悪い、検索対象に最新情報がないといった場合、生成AIのモデルだけを替えても、根拠の欠落や誤りは解消できない場合があります。
検索、引用、回答不能の三つを分けて評価する
RAGの評価では、「良い答えだったか」だけを見ない方がよいでしょう。少なくとも三つに分けます。
- 必要な情報を検索できたか。
- 回答が検索した情報に沿っているか。
- 根拠がないときに、答えない判断ができたか。
検索できない問題と、生成AIが間違える問題は、直す場所が違います。評価を分けると、文書処理、検索設定、プロンプト、生成AIのどこを直すべきかが分かります。
社内情報の鮮度と根拠が求められる理由
生成AIは、学習した時点より後の社内情報を自動では知りません。また、契約書、設計書、顧客対応履歴など、社外へ出せない情報を一般向けAIの学習に使うことも現実的ではありません。
RAGは、生成AIそのものを学習し直さず、検索対象を更新できます。たとえば、就業規則が変われば索引を更新し、新しい規程を回答へ使わせます。
また、回答に引用元を付けられるため、利用者が原文へ戻る導線も作れます。
企業で使われる主な用途は、社内検索、問い合わせ対応、営業提案、調査、契約書の確認、保守支援です。共通するのは、公開情報だけでは答えられず、根拠を確かめる必要がある仕事です。
| 業務 | RAGが探す情報 | 利用者へ返すもの | 人が残す判断 |
|---|---|---|---|
| 社内問い合わせ | 規程、手順書、FAQ | 回答案と根拠ページ | 例外承認、規程解釈 |
| 営業提案 | 商品資料、導入事例、顧客履歴 | 提案の下書き、類似事例 | 顧客への約束、価格 |
| 調査・分析 | 報告書、開示資料、ニュース | 比較表、論点、引用 | 投資・経営判断 |
| 契約確認 | 契約書、ひな型、法務メモ | 条項の抽出、差分 | 法的判断、交渉方針 |
| 保守支援 | マニュアル、障害履歴、部品情報 | 原因候補、確認手順 | 操作、停止、復旧 |
一方、RAGは計算の正しさや、業務の最終判断を保証する仕組みではありません。たとえば、検索した文書同士が矛盾する場合もあります。
また、規程の例外や顧客との個別契約は、文章を見つけるだけでは決められません。そのため、検索で助ける範囲と、人が承認する範囲を分ける必要があります。
RAG市場は「社内検索」からAIエージェントの知識基盤へ動く
検索結果を一度渡して答える構成に加え、複雑な質問を分けて複数の検索を行う構成もあります。例えばMicrosoftのagentic retrievalには、この質問分解を使う機能があります。
ただし、2026年9月27日時点では質問分解などはプレビューです。正式提供の範囲は、後述の企業比較で分けて説明します。
この変化は、RAGがチャット画面の裏側だけでなく、AIエージェントが仕事を進めるための知識基盤になることを意味します。たとえば、営業支援エージェントが顧客情報を調べ、提案書を作り、承認を依頼する場合、検索は一回では終わりません。
顧客、商品、契約、過去事例を順に確認します。
もう一つの変化は、文字以外への対応です。たとえば、NVIDIA NeMo Retrieverは、文章だけでなく、表や画像を含む文書の取り込みを扱います。
また、Google CloudのVertex AI RAG Engineも、データ取り込み、索引、検索、生成AIへの接続を管理サービスとしてまとめています。
検索方式に加え、接続・文書処理・評価・運用までを比較します。各社が扱う範囲が広がる一方、機能の数だけでは自社の業務に合うかは決まりません。
同じ評価用文書と質問を使い、品質、権限の反映、応答時間、費用を比べます。
業界構造は、文書処理から業務アプリまでの4層で見る
RAG市場には、クラウド企業、検索企業、データベース企業、生成AI企業、業務アプリ企業が並びます。ただし、同じ「RAG」という言葉を使っていても、担う範囲は違います。
そこで、4層に分けると、自社に足りない機能と提携先が見えます。
| 層 | 主な仕事 | 代表的な機能 | 主な企業 |
|---|---|---|---|
| 1. 文書処理・接続 | 情報源をつなぎ、検索可能にする | コネクター、OCR、表・画像抽出、分割 | AWS、Google、NVIDIA、Stockmark |
| 2. 検索・知識基盤 | 必要な情報を速く探す | ベクトルDB、全文検索、知識グラフ | Microsoft、Pinecone、Neo4j |
| 3. RAG運用 | 検索手順と回答品質を制御する | リランキング、権限、評価、監視 | AWS、Microsoft、Google、Stockmark |
| 4. 業務アプリ | 利用者の仕事へ組み込む | 社内検索、調査、文書分析、AIエージェント | Glean、Hebbia、各業務SaaS企業 |
同じ企業が複数の層を担います。自社で管理する範囲を先に決め、機能が重なる契約と、誰も担当しない工程がないかを確認します。
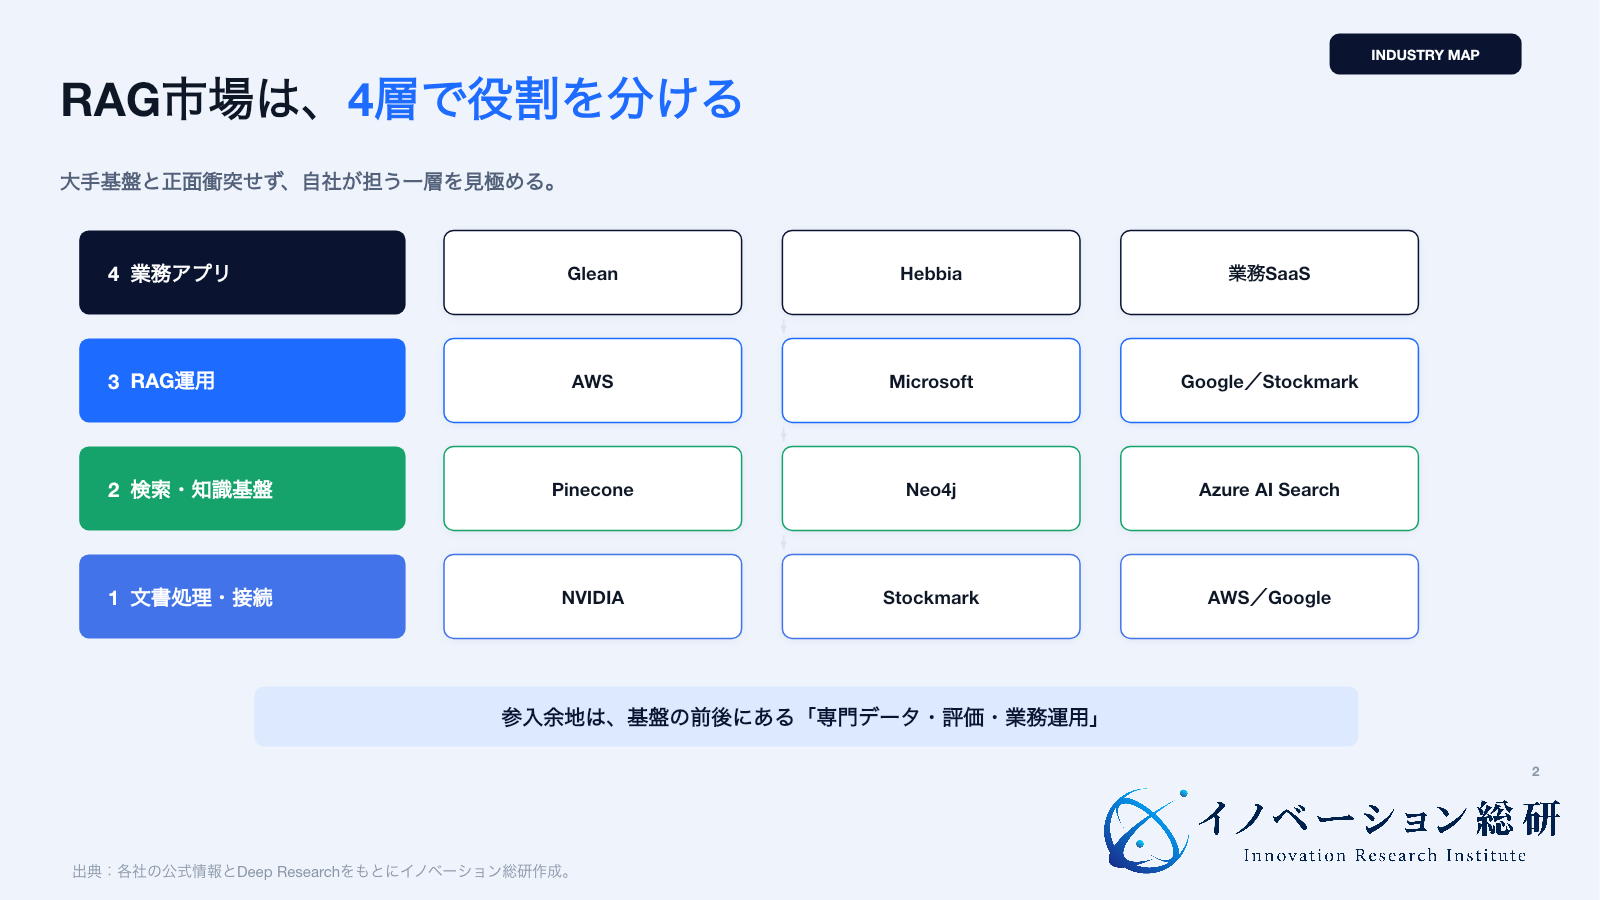
大手クラウドは、1層から3層までを一つのサービスにまとめています。一方、GleanやHebbiaは、4層の業務体験に強みを置きます。
また、Pineconeはベクトル検索、Neo4jは関係性をたどる知識グラフを中心にします。そして、Stockmarkは、日本語の業務文書を取り込み、評価する部分に踏み込んでいます。
新規参入企業が4層すべてを自前で作る必要はありません。むしろ、既存基盤を使い、特定業界のデータ整備、評価、業務設計を担う方が現実的です。
ただし、基盤企業へ依存する費用、データ移転、障害時の責任は事前に決めます。
RAGを進める主要9社は、どこで違いを作っているか
ここでは、国内外9社を取り上げます。具体的には、各社の公式情報をもとに、何を提供し、RAGのどの課題を担うかを整理しました。
なお、これは製品の優劣ではなく、自社の用途に合う役割を見分けるための比較です。
| 企業 | 主な役割 | 公式情報から確認できる特徴 | 段階 |
|---|---|---|---|
| AWS | 管理型RAG基盤 | 取り込み・検索・引用。Managedでは第三者接続と文書権限にも対応 | 商用提供 |
| Microsoft | 検索・エージェント検索 | 検索結果の抽出。質問分解・回答生成などはプレビュー | GAとプレビューを機能別に確認 |
| Google Cloud | 管理型RAG基盤 | データ取り込み、ベクトル保存、検索、モデル接続 | 商用提供 |
| NVIDIA | 文書処理・検索部品 | 文章、表、画像の抽出、埋め込み、リランキング | マイクロサービス・開発用ライブラリ |
| Glean | 企業内検索 | 社内システム横断、権限継承、企業知識グラフ | 商用提供 |
| Hebbia | 専門業務の調査 | 複雑な仕事の分解、複数文書の並列分析、確認可能な表 | 商用提供 |
| Stockmark | 日本語文書の構造化・評価 | 表や画像の抽出、知識グラフ、QAによる自動評価 | 商用提供・機能拡張 |
| Neo4j | GraphRAG | 企業・人物・契約などの関係をグラフで検索 | 構築用の文書・ツールを公開 |
| Pinecone | ベクトル検索基盤 | 管理型ベクトルDB、属性検索。Assistantは文書QA・引用も提供 | 商用提供 |
表の「提供」は、すべての機能・地域・料金プランで使えるという意味ではありません。以下の各社説明と公式文書で、必要な機能の条件を確認します。
AWSは、RAGの取り込みから引用までを管理サービスにする
Amazon Bedrock Knowledge BasesにはManagedとCustomer-managedの方式があります。現行の公式説明では、第三者サービスのコネクターや文書単位のアクセス権制御はManagedの機能です。
SharePoint、Confluence、Google Drive、OneDriveなどを接続でき、対応する文書権限で検索結果を絞ります。ただし、Webクローラーはこの権限制御の対象外です。
Customer-managedは保存先などを自社で選んで構成する方式で、同じ権限連携がそのまま付くわけではありません。サービス名だけでなく、方式・データ源ごとに、権限と更新がどこまで引き継がれるかを確認します。
引用が表示されることと、引用内容が正しく解釈されることも別に評価します。
Microsoftは、複雑な質問を分けて探す仕組みへ進む
Azure AI Searchのagentic retrievalは、検索した情報、引用元、検索処理の記録を返す仕組みです。キーワード検索、ベクトル検索、またはハイブリッド検索を用います。
複数の副質問を並行して探す機能と、キーワード・ベクトルを常に同時に使うことは同じではありません。
2026年9月17日更新の公式文書では、API 2026-04-01の最小構成による抽出型の検索などは正式提供です。一方、LLMによる質問分解や回答の文章化などはAPI 2026-08-01-previewで扱います。
プレビューはSLAがなく、本番用途には推奨されていません。試せる機能と本番契約に含められる機能を分けて選びます。
Google Cloudは、RAGの構成要素を選べる管理基盤を提供する
Vertex AI RAG Engineは、データ取り込み、文書分割、ベクトル化、検索、生成AIへの接続を管理します。Googleは、モデル、ベクトル保存先、データ源を用途に合わせて選べる点を示しています。
これは、特定の生成AIだけに固定せず、業務ごとに構成を変えたい企業に向きます。ただし、選択肢が増えるほど、どの構成を標準にするかという設計負担も増えます。
利用する地域、モデル、保存先の対応を確かめ、構成変更時にも同じ評価を行います。
NVIDIAは、表や画像を含む文書の前処理を狙う
NVIDIA NeMo Retrieverは、文書の索引作成と検索に使うマイクロサービス群です。文字だけでなく、表や画像を含む文書の抽出、埋め込み、リランキングを扱います。
表の行・列の対応や図中の注記が失われると、検索対象に文書があっても必要な意味を取り出せません。NVIDIAの機能を比較する際も、自社の帳票や図を使い、抽出結果が原文と合うかを確認します。
こうした機能の提供自体が、特定業務での回答精度向上を証明するものではありません。
Gleanは、権限を守る社内検索を仕事の入口にする
Gleanは、複数の社内システムを横断して検索するサービスです。元のシステムの権限を尊重し、内容、活動、利用者情報から企業の知識グラフを作ると説明しています。
特徴は、RAGの部品を売るのではなく、社員が毎日使う検索体験を提供する点です。たとえば、企業名、プロジェクト、担当者の関係まで使えば、同じ言葉を含む文書を探すだけでなく、仕事の文脈に合う情報を出せます。
そのため、新規参入では、この利用画面と顧客接点にどう差を作るかが問われます。
Hebbiaは、専門家の調査過程を見える形にする
HebbiaのMatrixは、複雑な仕事を分け、多数の文書を並行して分析し、結果を表の形で見せます。金融、法律、コンサルティング、製薬など、根拠確認が必要な専門業務を主な用途に挙げています。
単一の回答だけでなく、どの文書のどこから判断したかを列ごとに確認できる点が重要です。つまり、RAGを会話画面から専門業務の作業台へ変えています。
あくまで、専門家が最終判断をする前提で、調査時間を短くする設計です。
Stockmarkは、日本語文書の構造化とRAG評価をつなぐ
StockmarkのSATは、2024年6月にベータ版の募集が発表され、表や画像を含む文書の構造化を扱います。続く2025年1月のRAG自動評価機能の発表では、期待する回答と生成された回答をAIで比較し、評価とその理由を示す仕組みが説明されています。
「改善が起きた原因を特定する」機能という意味ではありません。
同社は、AIによる評価結果も誤る可能性があり、人が最終確認する必要があると明記しています。導入時は、設定の比較をAIで省力化しつつ、期待回答そのものの正しさ、業務上許されない誤り、採点の見落としを専門家が確認します。
評価機能の導入と、本番で使える品質の承認を分けることが示唆です。
Neo4jは、関係をたどるGraphRAGの構築を支援する
Neo4jのGraphRAG解説は、知識グラフを検索に使う設計方式を紹介しています。既存の関係データや文書から構築したグラフを使い、ベクトル検索などと組み合わせて情報を探します。
GraphRAGは一つの完成品の商品名ではなく、同社は構築用の文書やKnowledge Graph Builderなどのツールも公開しています。
たとえば、「この部品を使う製品と、その供給企業に関係する規制は何か」という質問は、似た文章を探すだけでは難しい場合があります。関係性を明示すると、答えへ至る道筋を追いやすくなります。
ただし、グラフの設計と更新には手間がかかります。すべての用途をGraphRAGにするのではなく、関係が価値を持つ業務へ絞ります。
Pineconeは、ベクトル検索の運用負担を引き受ける
Pineconeは、RAG向けの管理型ベクトルデータベースを提供します。具体的には、大量のベクトルを保存し、質問に近い情報を高速に検索します。
さらに、メタデータ(文書の属性情報)による絞り込みや、企業向けの配備方法も用意しています。
検索基盤を自社で管理する負担を減らせる一方、ベクトルDB単体では文書管理や回答画面まで完結しません。Pineconeには別途、文書を取り込み、引用付きで回答するAssistantもあります。
DBを部品として使うのか、回答機能まで使うのかで、残る実装作業を比較します。属性による絞り込みは公式のメタデータフィルターの説明で確認できますが、元システムの権限を正しく反映する設計は別に必要です。
主要9社から見える三つの競争軸
9社を横断すると、競争軸は三つに整理できます。
第一は、情報へ安全につなぐ力です。たとえば、GleanやAWSは、複数の情報源と権限の引き継ぎを重視します。
そして、コネクターが多いだけでなく、更新の検知、削除の反映、アクセス権の再現が必要です。しかも、接続先が増えるほど、企業は基盤を替えにくくなります。
第二は、難しい文書と質問を扱う力です。たとえば、NVIDIAとStockmarkは表や画像の処理、Microsoftは質問の分解、Neo4jは関係の検索に力を置きます。
つまり、単純な社内FAQを超えると、検索方法を一つに固定できません。
第三は、業務の最後までつなぐ力です。たとえば、Gleanは日常の社内検索、Hebbiaは専門調査の作業台を提供します。
つまり、RAGをAPIとして提供するだけでなく、利用者が根拠を確認し、修正し、次の行動へ移れる画面を持っています。
質問、役立った文書、修正の履歴は、改善箇所を探す材料になります。ただし、蓄積だけで競合より高い品質になるわけではありません。
再利用できる範囲を顧客と合意し、改善前後を同じ条件で比較して、検索漏れや誤回答が実際に減ったかを確かめます。
RAG導入の失敗を防ぐため、文書・権限・評価・費用を確認する
RAG導入の失敗は、検索精度が少し低いことだけではありません。現場で使われない、機密情報が漏れる、費用が増え続ける、誤回答の責任を決められないという四つが事業上は深刻です。
最初の問題は、情報の正本が決まっていないことです。たとえば、同じ規程の旧版と新版が別の場所にあれば、RAGは両方を検索します。
そのため、文書の所有者、更新日、失効日を管理しないまま取り込むと、回答の根拠を示しても正しさは担保できません。
次は権限です。たとえば、検索基盤側で部署や役職を見ず、生成AIの画面だけにログインを付ける設計では不十分です。
検索する時点で、利用者が閲覧できる文書へ絞る必要があります。ゼロトラストと同じく、利用者、情報、状況を結び付けて判断します。
第三は評価です。というのも、見栄えの良い数件だけで判断すると、珍しい質問や新しい規程に弱いまま公開されるからです。
そのため、頻出質問、答えがない質問、複数文書の比較、権限違反を含む評価セットを作り、変更のたびに再確認します。
第四は費用です。たとえば、複雑な質問を何度も検索し、長い文書を生成AIへ渡すと、検索と生成の費用が増えます。
しかも、品質だけを追うと、一件の問い合わせにかかる原価が人手を超えることもあります。そのため、回答時間、検索回数、利用モデル、キャッシュを測ります。
| 失敗要因 | 表面に出る症状 | 原因を確かめる指標 | 主な対策 |
|---|---|---|---|
| 文書が古い | 回答の根拠が旧版 | 更新反映時間、失効文書数 | 所有者、期限、削除連携を決める |
| 権限が弱い | 見てはいけない内容が出る | 権限テスト、不正検索件数 | 文書単位のACLを検索時に適用 |
| 評価がない | 改修後に別の回答が悪化 | 検索再現率、根拠一致、回答不能率 | 固定評価セットで回帰試験 |
| 費用が見えない | 利用増で赤字になる | 一回答原価、検索回数、入力文字量 | 用途別モデル、上限、キャッシュ |
| 業務につながらない | チャットが使われなくなる | 継続率、原文遷移、業務時間 | 承認・記録・修正まで組み込む |
回答不能率は低ければよい指標ではありません。根拠がない質問への保留と、根拠があるのに答えられない失敗を、別々に数えます。
架空例:100問中88問が適切でも、残る誤りを分ける
社内規程の問い合わせを想定した架空の評価例です。人が原文を確認して作った100問のうち、80問には回答根拠があり、20問にはありません。
件数は説明用の仮定で、製品の実績や合格基準ではありません。
| 対象 | 適切だった結果 | 残った問題 |
|---|---|---|
| 根拠がある80問 | 70問で根拠に沿う正答:87.5% | 10問は誤答。検索漏れか読み違いかを調べる |
| 根拠がない20問 | 18問で回答を保留:90.0% | 2問は根拠のない回答:この区分の10.0% |
| 合計100問 | 適切な回答・保留は88問:88.0% | 全体の数字だけでは、誤りの重大さは分からない |
総合点だけでなく、答えてはいけない場面で答えた件数を確認します。この例の2問が給与や契約の重要判断に関わるなら、88%を理由にそのまま公開できません。
用途ごとに影響と許容条件を決め、担当者への引き継ぎや原文確認を組み込みます。
閲覧権限は、この100問とは別に試します。同じ質問を権限のある人・ない人で実行し、権限変更や文書削除が検索結果、回答、キャッシュへ反映されるかを確認します。
試験で漏れが見つからなかったことを、あらゆる入力で漏れない保証にはしません。
RAGの原価は、検索・生成料金と人の確認時間を合算する
別の架空計算例で、月1,000件の質問に検索・生成費が1件30円、索引等の固定運用費が月2万円かかるとします。さらに、100件を人が1件10分、時間単価3,000円で確認すると、確認費は5万円です。
合計は月10万円、質問1件当たり100円となり、30円のAPI費だけで見た場合と違います。
これらは実在サービスの料金ではなく、初期開発費、営業費、税金、利益を含めない仮定です。導入後は実際の確認件数・工数で更新し、従来の対応と同じ品質条件で比較します。
作業時間の削減と、そのまま現金支出が減ることも分けて見積もります。
取得した文書に含まれる指示を、そのまま実行しない
OWASPのプロンプトインジェクションの説明は、外部文書などに入った指示がAIの挙動を変える危険を挙げ、RAGでも完全には防げないとしています。検索結果は参考資料であり、システムへの指示と同じ扱いにしない設計が必要です。
特にAIエージェントと組み合わせる際は、利用できる機能と権限を絞り、出力をプログラムで検査し、高リスクな送信・変更は人が承認します。プロンプトに注意書きを入れるだけで済ませず、悪意ある文書を想定した試験と、被害を限定する制御を重ねます。
RAGの事業機会は、既存基盤で足りない業務から探す
汎用の検索・RAG基盤には既存の提供企業がいます。以下は市場の空白が実証された領域ではなく、顧客が既存サービスで解決できていない仕事を探すための候補です。
既存の機能や支援会社と比較し、追加で費用を払う理由を確かめます。
一つ目は、ナレッジ運用です。具体的には、文書の所有者を決め、重複と旧版を見つけ、更新を促し、検索できない質問から不足情報を特定します。
つまり、情報を取り込む作業ではなく、企業の知識を使える状態に保つ継続サービスです。
二つ目は、専門業務です。たとえば、製造の不具合解析、医療機器の規制確認、保険の査定、建設の安全管理など、用語、文書形式、責任が固有の領域です。
そのため、業界の評価問題と業務画面を持てれば、汎用RAGとの差を作れます。
三つ目は、監査可能性です。具体的には、どの情報を検索し、何を生成AIへ渡し、誰が回答を承認したかを残します。
特に、規制産業や重要な判断では、回答精度だけでなく、後から説明できることに価値があります。
四つ目は、GraphRAGの運用です。GraphRAG(関係性のデータを使うRAG)は、関係性が重要な業務では有効ですが、知識グラフの設計、重複統合、更新、費用が障壁になります。
そのため、業界の共通モデルと更新サービスを持つ企業には機会があります。
NEXT STEP
次のステップ
RAGの機能ではなく、自社に残る資産を選ぶ。
顧客、固有データ、専門家、評価問題、運用原価を棚卸しし、RAGで継続して担える一つの仕事を具体化します。
新規事業では、RAGの三つの参入ルートが考えられる
イノベーション総研では、RAGへの参入を三つに分けます。技術とともに、自社が持つ顧客接点、利用許諾を得たデータ、専門家、運用体制を確認します。
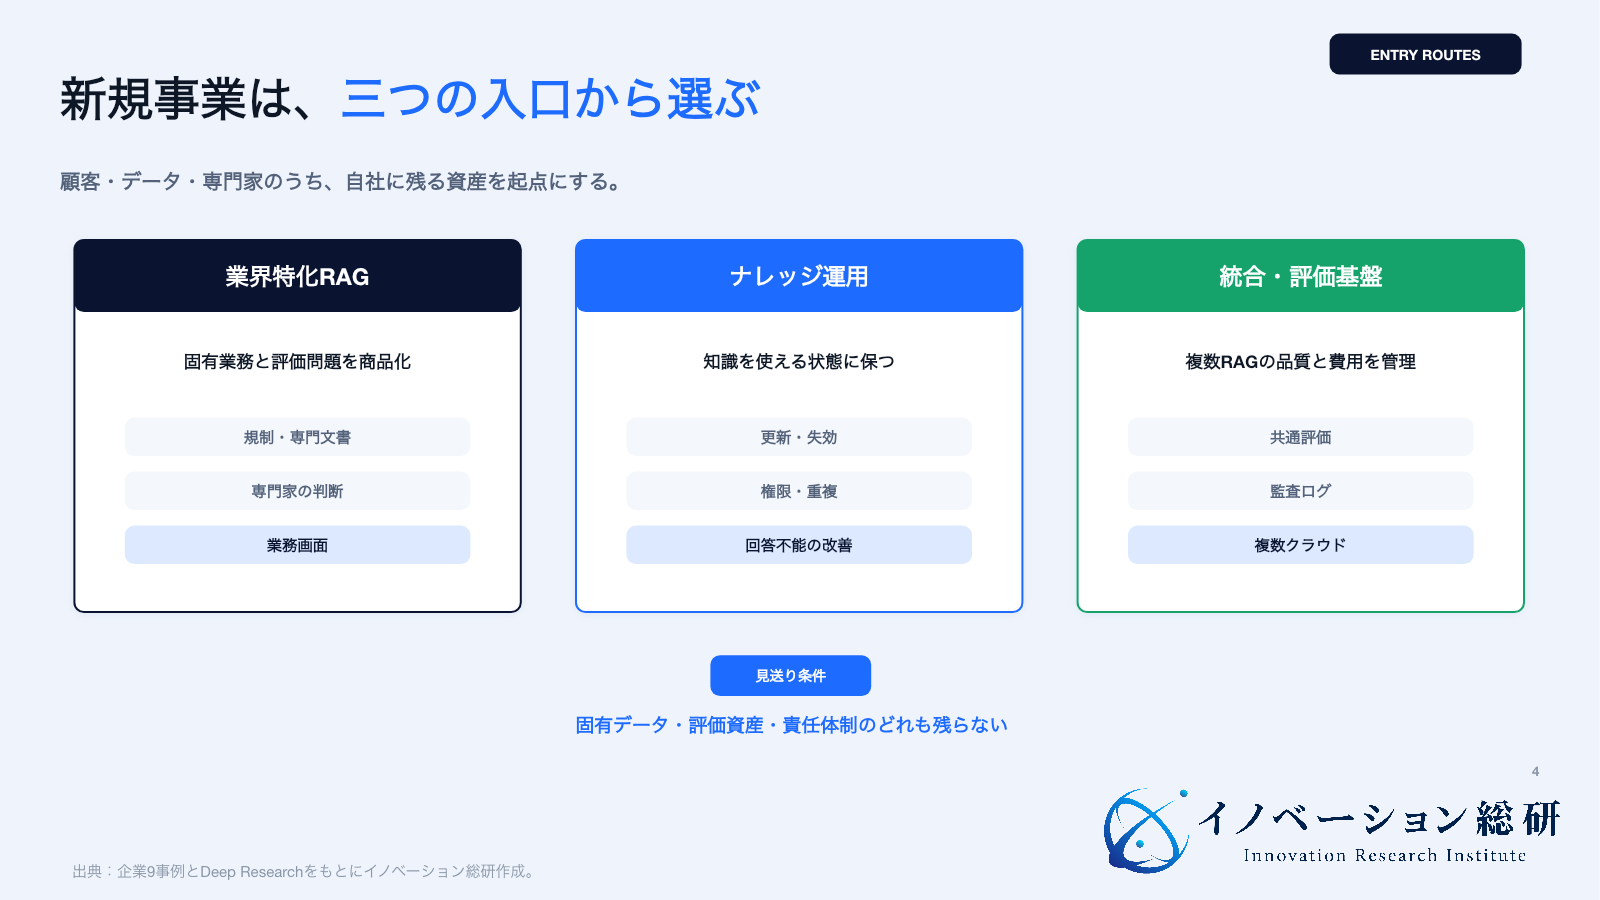
次の表では、販売先と引き受ける仕事を先に見て、必要な資産・提携先・採算上の懸念を照合します。
| 参入ルート | 主な顧客 | 商品にする仕事 | 必要な資産 | 主な提携先 | 最大の懸念 |
|---|---|---|---|---|---|
| 業界特化RAG | 規制・専門文書が多い企業 | 業界文書の検索、評価、業務画面 | 専門家、評価問題、顧客接点 | クラウド、生成AI、業務SaaS | 誤回答の責任が重い |
| ナレッジ運用サービス | 社内情報が散在する中堅・大企業 | 文書整備、権限、品質、更新の運用 | 情報管理ノウハウ、運用体制 | 社内検索、文書管理、SIer | 人手原価が増えやすい |
| RAG統合・評価基盤 | 複数のRAGを持つ大企業 | 共通評価、監視、費用管理、監査 | 評価データ、連携技術、運用ログ | AWS、Microsoft、Google、DB企業 | 基盤機能へ吸収される |
業界の専門家がいるなら、まず評価問題を作れる一業務から試します。専門家がいない場合は、文書整理や運用支援など、自社が品質を確かめられる範囲に絞ります。
業界特化RAGでは、根拠と業務の判断手順をそろえる
業界特化では、公開文書を検索できるだけでは弱いでしょう。むしろ、顧客が持つ固有データと、専門家が使う判断手順を組み込みます。
たとえば、保険なら約款と査定基準、製造なら図面と不具合履歴、建設なら施工計画と安全基準です。
競争力になるのは、業界の質問集、正しい根拠、答えてはいけない条件です。評価問題や運用ログにも顧客の秘密情報が含まれ得ます。
自社に残す範囲、保管期限、他社へ再利用できる範囲を合意し、一般化できる設計と顧客固有の内容を分けます。
ナレッジ運用は、検索できない理由を直す継続事業にする
導入時のデータ移行だけでは、売上が一度で終わります。毎月、重複文書、更新の遅れ、回答不能、権限エラーを分析し、文書の担当部署へ改善を返すサービスにします。
注意点は採算です。というのも、顧客ごとに人が文書を読み続けると、利用が増えるほど原価も増えるからです。
そのため、標準の品質指標、自動検査、担当者向け画面を持ち、専門家が見る例外を絞ります。
RAG統合・評価基盤は、複数部署を横断する企業に向く
複数部署で別々のRAGを使う企業では、共通管理が課題になる場合があります。ところが、使う生成AI、検索基盤、評価方法が違うと、費用とリスクを比較できません。
そこに、共通の評価セット、ログ形式、権限試験、費用画面を提供する余地があります。
ただし、クラウド企業も評価と監視の機能を拡張しています。そのため、単なる管理画面は吸収されやすいでしょう。
むしろ、業界監査、複数クラウド、既存システムまで横断する能力が必要です。
RAGの回答ルールと、運用・事故対応の担当を一緒に決める
RAGには、データを持つ顧客、基盤を提供するクラウド企業、検索・生成AIの企業、導入会社、業務の利用者が関わります。誤回答や情報漏えいが起きたとき、誰が何を確認するかを契約と運用で決めます。
以下は実務上の担当分けの例で、法的責任を一律に割り当てるものではありません。
| 場面 | 顧客側の担当例 | 提供側の担当例 | 先に合意すること |
|---|---|---|---|
| 文書の正しさ | 正本、所有者、失効を決める | 取り込みと削除を正しく反映する | 更新頻度、反映時間、例外 |
| アクセス権 | 閲覧できる人を承認する | 検索時に権限を適用する | 権限の正本、テスト、ログ |
| 回答品質 | 最終判断と業務利用を管理する | 検索・回答の品質を測り改善する | 合格基準、回答不能、承認範囲 |
| 障害・費用 | 重要業務と予算上限を決める | 原因切り分け、復旧、利用量を示す | SLA、縮退運転、費用上限 |
| 事故対応 | 対外判断と通知を行う | 証拠を保全し、影響範囲を調べる | 初動時間、連絡先、再発防止 |
「AIが作った回答なので保証しない」とだけ書いても、利用者は守れません。どの用途なら参考情報として使えるか、どの用途は人の承認が必要か、何を自動実行してはいけないかを画面と権限で制御します。
特に、AIエージェントと組み合わせる場合は、検索結果が次の操作につながります。つまり、誤った回答が、発注、送信、設定変更へ進む恐れがあります。
そのため、検索、提案、承認、実行を分け、取り消せない操作の前には人の確認を置きます。
RAGへの関わり方を4つに分けて考える
参入:顧客・データ・専門家がそろう
一つの業界、一つの判断業務へ絞って商品化します。
提携:顧客接点か技術の片方が足りない
クラウド、検索、文書管理の企業と責任を分けます。
待機:利用頻度と一回答原価が読めない
有償の小規模利用から継続率と原価を確認します。
見送り:固有資産と責任体制が残らない
汎用チャットの再販売に留め、別の顧客課題を選びます。
自社は参入・提携・待機・見送りのどれか
RAGの機能が広がっても、すべての会社が自社サービスを持つ必要はありません。次の四つに分けて考えます。
| 判断 | 選ぶ条件 | 次の行動 |
|---|---|---|
| 参入 | 特定業界の顧客、データ、専門家、責任体制がある | 一つの業務へ絞り、評価問題と運用を商品化 |
| 提携 | 顧客か専門性はあるが、検索・AI基盤が足りない | クラウド・DB企業と役割、粗利、事故対応を合意 |
| 待機 | 技術はあるが、利用頻度と原価が読めない | 有償の小規模業務で継続率と一件原価を確認 |
| 見送り | 汎用チャット以外の差がなく、誤回答の責任も持てない | 再販売に留めるか、別の顧客課題を選ぶ |
見送り条件は明確です。たとえば、顧客データへ継続してアクセスできない、正解データを作れる専門家がいない、権限を検索へ反映できない、回答の利用範囲を制御できない、顧客ごとの手作業の費用を料金でまかなえない、といった条件です。
安全に提供できない範囲は外し、不足する専門性は提携で補ったうえで、なお採算が合うかを確認します。
イノベーション総研では、RAGの事業性を「顧客の切実さ」「固有データへの接点」「評価資産」「業務への組み込み」「継続運用の粗利」「責任を持てる範囲」で見ます。検索精度のデモより、使われ続ける条件と事故時の設計を重視します。
RAGに詳しい相談先は、評価と運用を説明できるかで選ぶ
相談先を選ぶときは、対応できる生成AIの数だけを見ない方がよいでしょう。次の質問に具体的に答えられるかを確認します。
- 検索の失敗と生成AIの失敗を分けて評価できるか。
- 文書の更新、削除、重複、権限を継続して管理できるか。
- ベクトル検索、キーワード検索、GraphRAGを用途で使い分けられるか。
- 一回答の費用と、利用が増えたときの運用原価を示せるか。
- 誤回答、情報漏えい、障害時の責任分界を設計できるか。
- 生成AIを使わない検索や既存FAQも、中立に比較できるか。
良い相談先は、最初から大きなRAG基盤を勧めません。業務で困っている質問、利用者、正本データ、誤った場合の影響を整理します。
そのうえで、検索だけで十分か、RAGが必要か、GraphRAGまで必要かを判断します。
新規事業の相談でも同じです。「RAG市場が伸びる」ではなく、誰のどの仕事を引き受け、どのデータと評価が自社に残るかを具体化できる相手を選びます。
RAGに関するよくある質問
RAGの定義、回答の限界、更新方法、導入先の選び方を整理します。
本記事のまとめ|RAGは知識運用で差がつく
RAGは、社内外の情報を検索し、その内容を生成AIへ渡して回答を作る仕組みです。最新情報や企業固有の情報を扱い、根拠を示せる点に価値があります。
一方、検索技術だけでは成功しません。文書の更新、閲覧権限、回答評価、費用、業務への組み込みが必要です。
AWS、Microsoft、Google、NVIDIA、Glean、Hebbia、Stockmark、Neo4j、Pineconeの違いも、この4層のどこを担うかで理解できます。
新規事業では、汎用RAG基盤へ正面から参入するより、業界特化RAG、ナレッジ運用、統合・評価基盤が候補です。ただし、固有データ、評価資産、専門家、継続運用の粗利、責任範囲がなければ差は残りません。
RAGで何を答えるかより、誰の知識をどう保ち、どの判断まで安全につなぐか。この問いを、評価方法、担当者、料金、許諾されたデータの利用範囲へ落とし、継続提供できる条件を確かめます。
主な出典
情報確認日:2026年9月27日。各社の公式資料を基に、提供機能とプレビューを区別しています。
4層・参入候補は当研究所の整理であり、評価結果と原価の計算例は架空のものです。
- AWS Amazon Bedrock Knowledge Bases
- Microsoft Azure AI Search agentic retrieval
- Google Cloud Vertex AI RAG Engine
- NVIDIA NeMo Retriever
- Glean Search FAQ
- Hebbia Matrix
- Stockmark SAT
- Stockmark RAG自動評価
- Neo4j GraphRAG
- Pinecone RAG
CONTACT
お問い合わせ
RAGを、検索デモで終わらない事業へ。
市場、主要企業、自社資産、提携先、評価、運用原価、誤回答の責任を整理し、参入・提携・待機・見送りの条件へ落とします。


