
投稿日:2026.09.06 最終更新日:2026.09.20
AI for Scienceが研究開発を変える|国内外8事例と新規事業の勝ち筋
AI for Scienceは、AIが答えを出す話ではない。
予測と実験をつなぎ、次の発見を速くする。
結論は、検証済みの独自データが増える循環を商品にできるかで決まります。国内外8事例と4つの参入方法から、新規事業の入口を整理します。
この記事の結論
AI for Scienceの勝負は、モデルの大きさではなく、予測、実験、独自データの循環を作れるかで決まります。
- AI for Scienceの意味と、予測から実験へつなぐ研究開発サイクルを解説します。
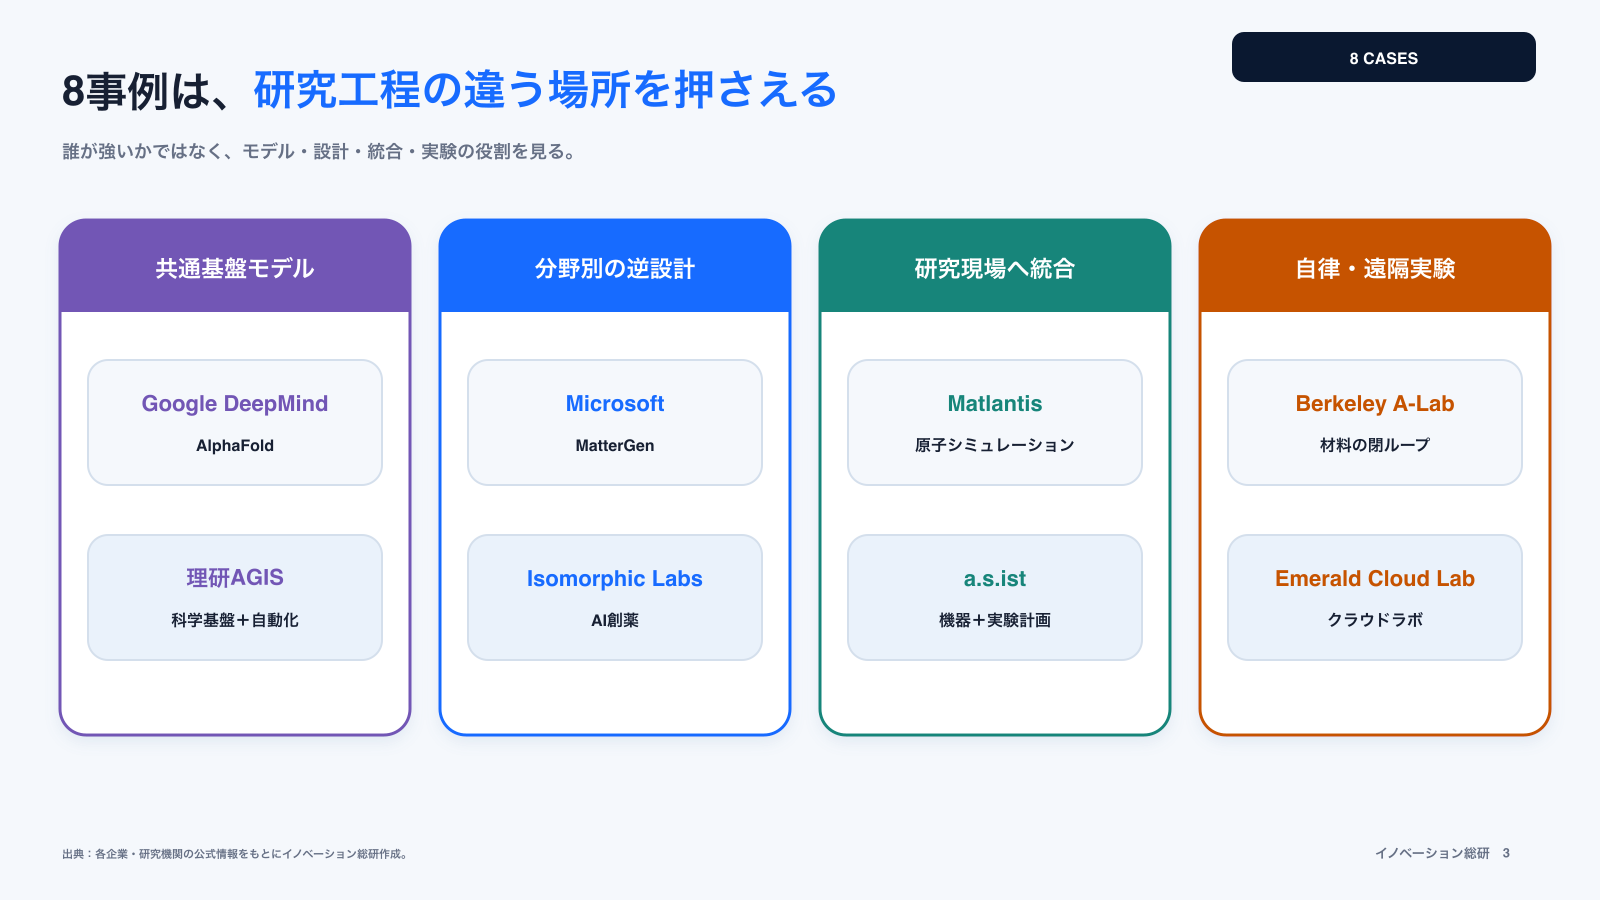
- 国内外8事例を、基盤モデル、分野別設計、現場統合、自律・遠隔実験の役割から読み解きます。
- 4つの参入方法と収益モデル、再現性、データ、知財への懸念を示します。
AI for Scienceは、科学研究の一部にAIを使うだけの取り組みではありません。文献を探し、仮説を立て、候補を設計し、実験し、得られたデータから次の実験を決める。この研究の循環そのものを速く、広く、再現しやすくする考え方です。
注目を集めるきっかけになったのは、タンパク質の立体構造を予測するAlphaFoldです。現在は創薬に加え、新材料、触媒、電池、気象、核融合などへ対象が広がりました。AIが候補を出すだけでなく、ロボットが実験し、その結果をAIへ戻す自律実験も始まっています。
ただし、優れたAIモデルを導入すれば研究開発が変わるわけではありません。研究データの整備、実験機器との接続、予測の検証、知財の帰属までを一つの仕組みにする必要があります。
本記事では、国内外8事例を「研究工程のどこを変えたか」という視点で解説します。そのうえで、事業会社が狙える4つの参入方法と、収益化・データ・安全面の懸念を整理します。
結論は、AIの精度だけでなく、予測と実験を結び、独自データが増える循環を作れるかが勝負です。
目次
AI for Scienceとは何か
AI for Scienceとは、機械学習や生成AIを使い、科学研究の発見速度と探索範囲を広げる取り組みです。日本語では「科学のためのAI」などと表現されます。
対象になるのは、研究者の文章作成だけではありません。科学データを学ぶ専用モデル、シミュレーションの高速化、実験条件の提案、ロボットによる実験、測定結果の解析まで含みます。
| 研究工程 | 従来の進め方 | AI for Scienceで変わること |
|---|---|---|
| 文献・知識探索 | 研究者が論文を読み、整理する | 論文、特許、実験記録を横断して関係を探す |
| 仮説・候補設計 | 経験と既知の理論から候補を絞る | 広い候補空間から有望な分子や材料を提案する |
| 計算・シミュレーション | 高精度だが時間のかかる計算を回す | AIの近似モデルで計算を大幅に速める |
| 実験計画 | 研究者が次の条件を決める | 結果を見ながら、情報量の多い次の実験を選ぶ |
| 実験・測定 | 人が機器を操作し、記録する | ロボットや自動機器が条件を変えながら実行する |
| 評価・再学習 | 結果を個別に解釈する | 成功と失敗を学習し、次の候補へ反映する |
重要なのは、AIが研究者を置き換えるかどうかではありません。研究者が問いを決め、AIが探索を広げ、実験が真偽を確かめるという役割分担です。
生成AIとの違いは、科学の制約と実験にある
一般的な生成AIは、文章、画像、音声など、人が作った大量のデータからパターンを学びます。AI for Scienceも生成技術を使いますが、正しさの基準が異なります。
科学では、もっともらしい答えでは足りません。原子の配置、保存則、生体分子の相互作用など、既知の法則と矛盾しないことが必要です。最後は計算や実験で確かめます。
| 比較点 | 一般的な生成AI | AI for Science |
|---|---|---|
| 主な入力 | 文章、画像、音声 | 分子構造、実験値、測定波形、シミュレーション |
| 正しさの基準 | 人に自然か、目的に合うか | 法則と整合し、実験で再現できるか |
| データ量 | インターネット規模 | 少量で高価、条件がそろわないことが多い |
| 出力 | 文章や画像 | 候補物質、物性、実験条件、予測値 |
| 最終確認 | 人の評価 | 計算、測定、実験、人の専門判断 |
AIエージェントの新規事業で扱う仕組みは、複数のツールを選び、作業を順番に進めます。AI for Scienceでは、そこに科学専用モデル、計算資源、実験機器、安全ルールが加わります。
文章を生成するAIだけを研究者へ配っても、研究開発の中核は変わりません。科学データと実験へ接続して初めて、AI for Scienceと呼べる価値が生まれます。
AI for Scienceが変える研究開発の流れ
AI for Scienceの価値は、単発の予測ではなく、研究の循環にあります。仮説から実験までを一方向に進めるのではなく、結果を次の設計へすぐ戻します。
代表的な流れは、次の五段階です。
- 目的を決める:必要な薬効、耐熱性、触媒性能などを定義する
- 候補を作る:AIが分子、結晶、実験条件を生成する
- 絞り込む:物理計算や既知データで実現性を評価する
- 実験する:研究者または自動設備が合成・測定する
- 学び直す:成功と失敗をモデルへ戻し、次の候補を選ぶ
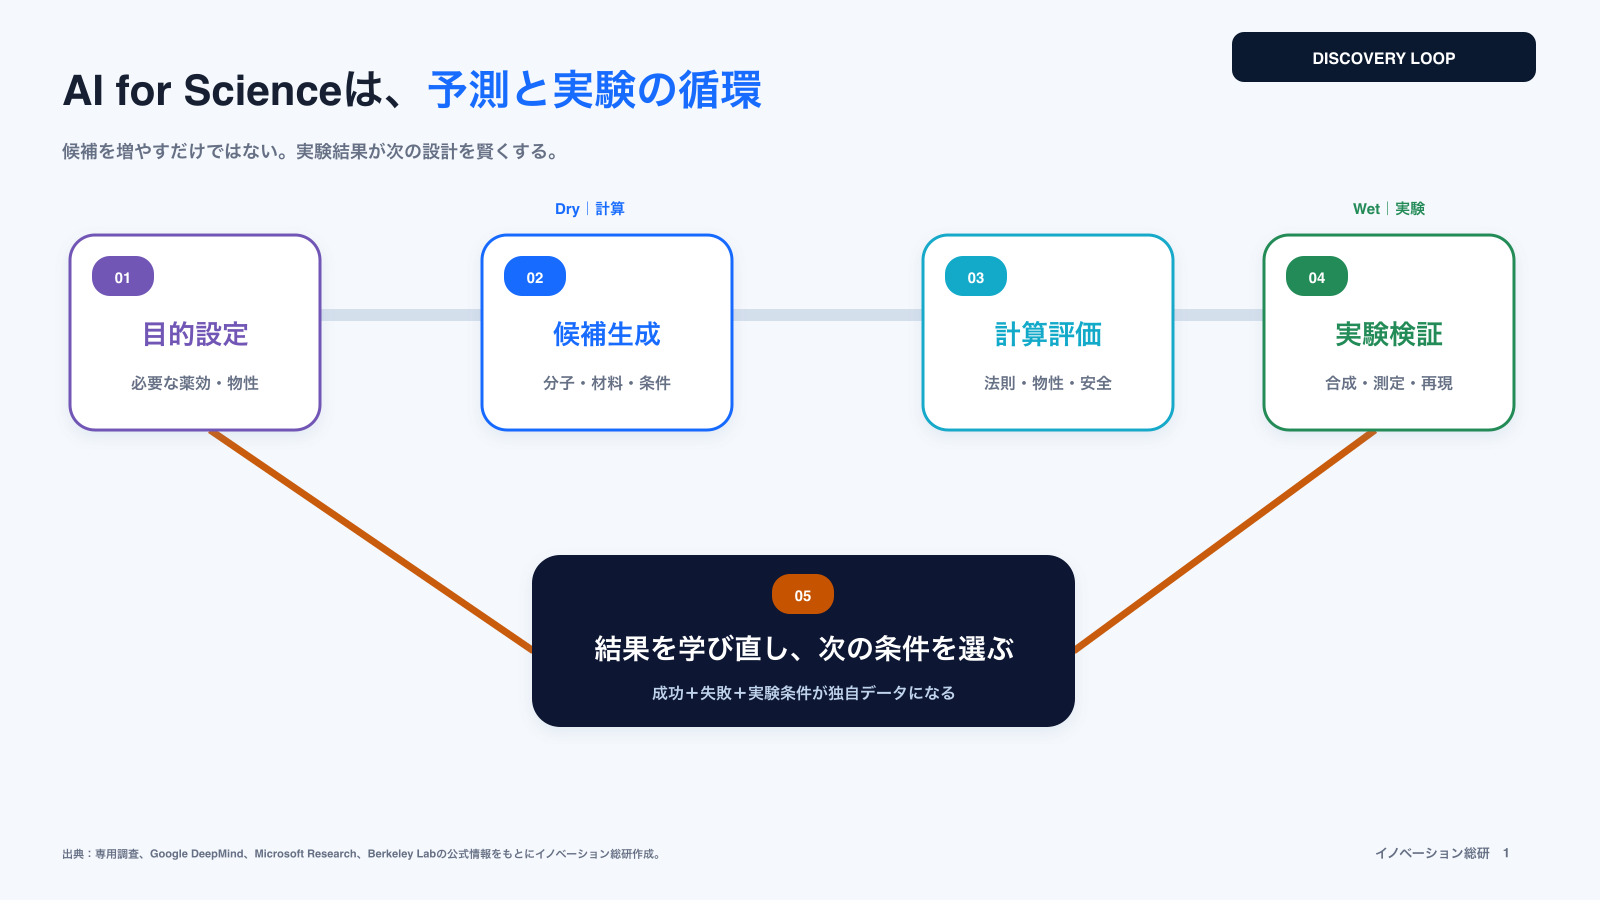
この循環は「Dry-Wet-Dry」とも呼ばれます。Dryは計算機上の設計や予測、Wetは実験室での合成や測定です。計算だけでは作れるか分からず、実験だけでは探索できる範囲が狭い。両者を短い間隔で回すことに意味があります。
自律実験ラボは、フィジカルAIの事業機会とも重なります。ただし、科学実験では速く動くことより、条件、試薬、測定方法、失敗理由を正確に記録し、再現できることが重視されます。
AI for Scienceの市場はどう広がるか
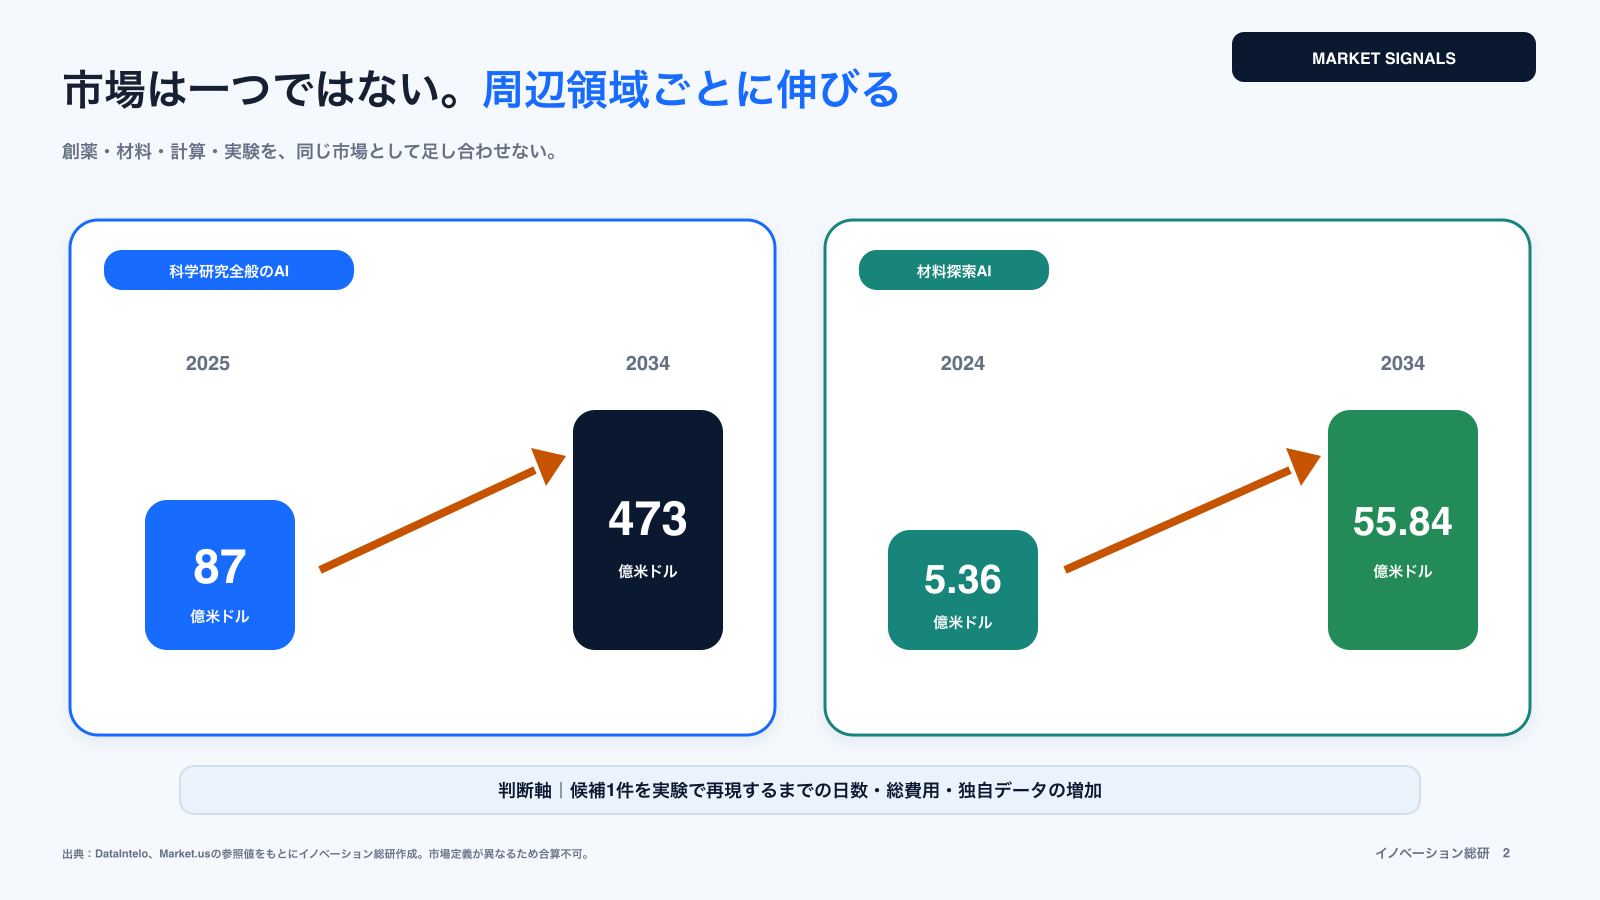
AI for Scienceには、統一された市場定義がまだありません。創薬AI、材料インフォマティクス、科学計算基盤、実験自動化をどこまで含めるかで数字が変わります。そのため、一つの市場規模だけで事業性を判断するのは危険です。
専用調査が参照した民間調査では、科学研究全般のAI市場を2025年87億ドル、2034年473億ドルと予測しています。材料探索向けAIは2024年5.36億ドル、2034年55.84億ドルという推計です。いずれも高い成長を示しますが、対象範囲が異なるため合算はできません。
事業会社は、市場予測より次の四つを見た方が実態をつかめます。
- 顧客の研究開発費のうち、計算・実験・外注へ使われている金額
- 一つの候補を設計し、実験で確かめるまでの日数と費用
- AIが提案した候補のうち、実験へ進み、再現できた割合
- 同じ設備とデータを、複数の研究テーマで使い回せる割合
日本でも政策支援が具体化しています。JSTのARiSEは、重点領域と国際連携へ集中投資する事業です。文部科学省のSPReADは、年間約1,000課題の採択を掲げ、計算資源、データ利用、ロボット設備などを支援対象にしています。研究機関向けの基盤と、企業向けの実装支援が同時に広がる段階に入りました。
AI for Scienceの産業構造を四層で見る
業界は、AIモデルを開発する企業だけで成り立ちません。専用調査をもとに、計算基盤、科学モデル、業務プラットフォーム、実験・検証の四層に分けると分かりやすくなります。
| 層 | 提供するもの | 主なプレーヤー例 | 競争力になるもの |
|---|---|---|---|
| 計算・データ基盤 | GPU、HPC、クラウド、科学データ | NVIDIA、AWS、Microsoft、理研、産総研 | 計算単価、機密性、データへの接続 |
| 科学基盤モデル | 分子、材料、生物、気象の予測・生成 | Google DeepMind、Microsoft Research、Matlantis | 精度、速度、対象範囲、説明可能性 |
| 分野別プラットフォーム | 創薬・材料などの研究工程を管理 | Isomorphic Labs、Recursion、Schrödinger | 顧客業務への統合、独自データ、知財 |
| 実験・検証基盤 | 自動合成、測定、クラウドラボ | Berkeley Lab、Emerald Cloud Lab、a.s.ist | 再現性、稼働率、対応できる実験種類 |
下の層ほど資本力や大規模計算が必要です。上の層ほど、研究現場の知識と設備接続が重要です。新規参入企業が汎用モデルを正面から作ると、巨大IT企業との計算資源競争になります。
一方、特定材料の実験手順、古い分析機器との接続、品質保証文書の作成などには空白があります。顧客の現場に近い企業は、モデルを作らなくても価値を持てます。
量子コンピュータも将来の科学計算基盤として注目されます。ただし、足元の事業では、既存のGPUやHPCで解ける課題と、量子計算が必要な課題を分けることが必要です。
国内で進むAI for Scienceの3事例
国内では、材料科学と研究基盤を中心に実装が進んでいます。日本の強みは、高品質な実験データ、精密な計測機器、材料・化学分野の研究者にあります。
理化学研究所AGIS|基盤モデルと実験自動化を共通基盤にする
理化学研究所の科学研究基盤モデル開発プログラム(AGIS)は、生命・医科学、材料科学、共通基盤、計算基盤を横断する取り組みです。科学データを学習する基盤モデルとAIエージェントを開発し、実験自動化やシミュレーションと組み合わせます。
特徴は、特定の研究室向けツールで終わらせず、理研の計算設備と実験設備をつなぐ点です。開発したモデルと利用技術を産学へ開放する方針も示しています。
企業にとっては、共同研究の相手だけではありません。計算資源、研究データ、実験設備へ接続する共通仕様が育つ可能性があります。装置連携、データ整備、セキュリティ、研究者向け画面など、周辺サービスの需要も生まれます。
Matlantis|原子レベルの計算を高速化し、材料探索を日常業務へ入れる
Matlantisは、Preferred NetworksとENEOSが共同で育てた汎用原子シミュレーターです。中核モデルのPFPは、原子の動きとエネルギーを予測します。
公式説明では、密度汎関数理論と同等水準の精度を目指しながら、計算速度を大幅に高めるとしています。96元素に対応し、触媒、電池、半導体、潤滑剤など、分野をまたいで使えることが特徴です。
従来、原子レベルの高精度計算は時間がかかり、候補を大量に試せませんでした。Matlantisは、実験前に条件を絞り込み、研究者が有望な候補へ時間を使えるようにします。技術をSaaSとして提供し、計算環境の構築を顧客側へ求めない点も事業化の参考になります。
a.s.ist|古い研究設備とAIをつなぐ実装層へ入る
a.s.istは、材料・化学分野で、合成、計測、データ解析、次の実験計画をつなぐ自立型材料開発システムを開発しています。自動スペクトル解析や、ベイズ推論を使った最適実験計画も提供します。
ここで重要なのは、AIモデルだけを売っていないことです。研究室ごとに異なる装置や手順へ合わせ、現場で動くシステムとして実装します。
多くの企業研究所には、ネットワーク接続を前提としていない分析機器や、表計算ファイルに残る実験記録があります。こうした環境を一足飛びに完全自動化するのは難しいため、装置一台、測定工程一つから閉じた循環を作るサービスに現実的な需要があります。
海外で進むAI for Scienceの5事例
海外では、巨大IT企業の科学モデル、創薬企業の垂直統合、自律実験ラボのサービス化が並行して進んでいます。各社が「どの研究工程を押さえているか」に注目します。
Google DeepMind|AlphaFoldを研究の共通基盤にした
Google DeepMindのAlphaFoldは、アミノ酸配列からタンパク質の立体構造を予測します。AlphaFoldの公式ページでは、2億件を超える構造予測をデータベースで公開しています。
AlphaFold 3は、タンパク質だけでなく、DNA、RNA、低分子などの相互作用へ対象を広げました。研究者は、すべてを実験で解く前に、どの構造や相互作用を優先して確かめるか考えやすくなりました。
事業面で注目すべきは、予測モデルを閉じ込めなかった点です。広く使えるデータベースと研究利用を入口にし、Isomorphic Labsが創薬へ事業化しています。共通基盤と高付加価値用途を分ける設計です。
Microsoft Research|MatterGenで欲しい物性から材料を設計する
Microsoft ResearchのMatterGenは、必要な性質を指定し、新しい無機結晶を生成するモデルです。既存の材料一覧から探すのではなく、「硬さ」「磁性」などの条件から候補を作ります。
中国科学院深圳先進技術研究院との検証では、MatterGenが設計した候補を実際に合成し、狙った体積弾性率に近い値を確認しています。モデルの評価を計算だけで終えず、実物を作った点に価値があります。
この事例から分かるのは、逆設計だけでは商品にならず、実験による検証まで必要だということです。合成できるか、測定値が出るか、量産条件で成立するかを確かめます。
Isomorphic Labs|AI創薬を製薬会社との共同開発へつなぐ
Isomorphic Labsは、Google DeepMindの研究成果を使い、医薬品設計へ取り組む企業です。自社のDrug Design Engineを使い、難しい標的に対する低分子や生物製剤の候補を設計します。
同社の提携情報では、Novartis、Eli Lilly、Johnson & Johnsonとの共同研究を示しています。Novartisとの提携では、当初の三つの標的に最大三つの研究プログラムを追加しました。
収益は、一般的な月額ソフト利用料だけではありません。共同研究の契約金、候補の進展に応じた支払い、将来の成果配分を組み合わせられます。高い研究価値を取り込める一方、成果が出るまでの期間と不確実性は大きくなります。
Berkeley LabのA-Lab|AIの提案をロボットが合成し、結果を学び直す
米ローレンス・バークレー国立研究所のA-Labは、無機材料を自動で合成する研究設備です。計算データと論文から合成方法を考え、ロボットが粉末の計量、混合、加熱、X線回折による測定を行います。
Nature掲載研究では、17日間の連続運転で58候補のうち41種類の新材料を合成しました。失敗した場合は、結果を見て次の条件を選びます。
A-Labが示したのは、予測数の多さではありません。「作れるか」という詰まりを自動化したことです。材料開発では、計算上よい候補が現実には合成できない問題が多く、実験の閉ループが競争力になります。
Emerald Cloud Lab|実験設備をクラウドサービスにする
Emerald Cloud Labは、研究者が遠隔から実験を設計し、クラウド上のラボ設備で実行できるサービスです。試料調製、機器操作、測定、解析までをソフトウェアから指示できます。
利用者は自前で高価な機器を持たず、必要なときに実験できます。実験手順がコード化されるため、同じ条件を再実行しやすくなります。AIが提案した多数の候補を、標準化された設備で確かめる受け皿にもなります。
ただし、すべての実験を遠隔化できるわけではありません。特殊な試料、現場の感覚が必要な操作、搬送できない材料には制約があります。対象実験を絞り、標準化率を上げることが採算の鍵です。
8事例から見えるAI for Scienceの勝ち筋
八つの事例は扱う分野も規模も異なります。ただし、事業として強くなる条件には共通点があります。
第一は、モデルの精度だけでなく、実験で確かめた実績を持つことです。MatterGenとA-Labは、候補を生成しただけでなく、合成と測定まで行いました。顧客が買うのは予測そのものではなく、研究判断を前へ進める証拠です。
第二は、独自データが増える循環です。論文や公開データは競合も使えます。実験の成功だけでなく、合成できなかった条件、測定の異常、再現しなかった結果を蓄積できると、次の予測を改善できます。
第三は、研究者の既存業務へ入ることです。Matlantisは複雑な計算環境をSaaS化し、a.s.istは分析機器と実験計画をつなぎます。研究者に新しい画面を増やすより、電子実験ノート、実験機器、計算環境へ自然に接続する方が定着します。
第四は、無料・共通基盤と有料・専用用途を分けることです。AlphaFoldは広い研究利用を支え、Isomorphic Labsは創薬で高い価値を取り込みます。モデルを公開するか閉じるかという二択ではなく、普及させる層と収益化する層を分けます。
第五は、人の判断を残す場所が明確なことです。研究目的、安全性、実験の中止、候補の採否、特許出願は、人が責任を持ちます。すべてを自律化するより、判断の根拠と履歴を残す方が企業導入は進みます。
AI for Science事業を4つの判断に分ける
参入:独自データ、実験設備、産業顧客を持つ
既存資産が生きる研究工程を一つに絞り、検証済みデータが増える循環を作ります。
提携:AIはあるが、科学人材や実験環境がない
大学、研究機関、受託分析会社と組み、評価方法と知財の帰属を決めます。
待機:課題はあるが、性能の評価方法が決まらない
モデル開発を急がず、顧客が採用判断に使う指標とデータを先に定義します。
見送り:汎用モデルだけで差別化しようとしている
独自データ、実験接続、業務責任のいずれも持てない場合は、参入方法を再設計します。
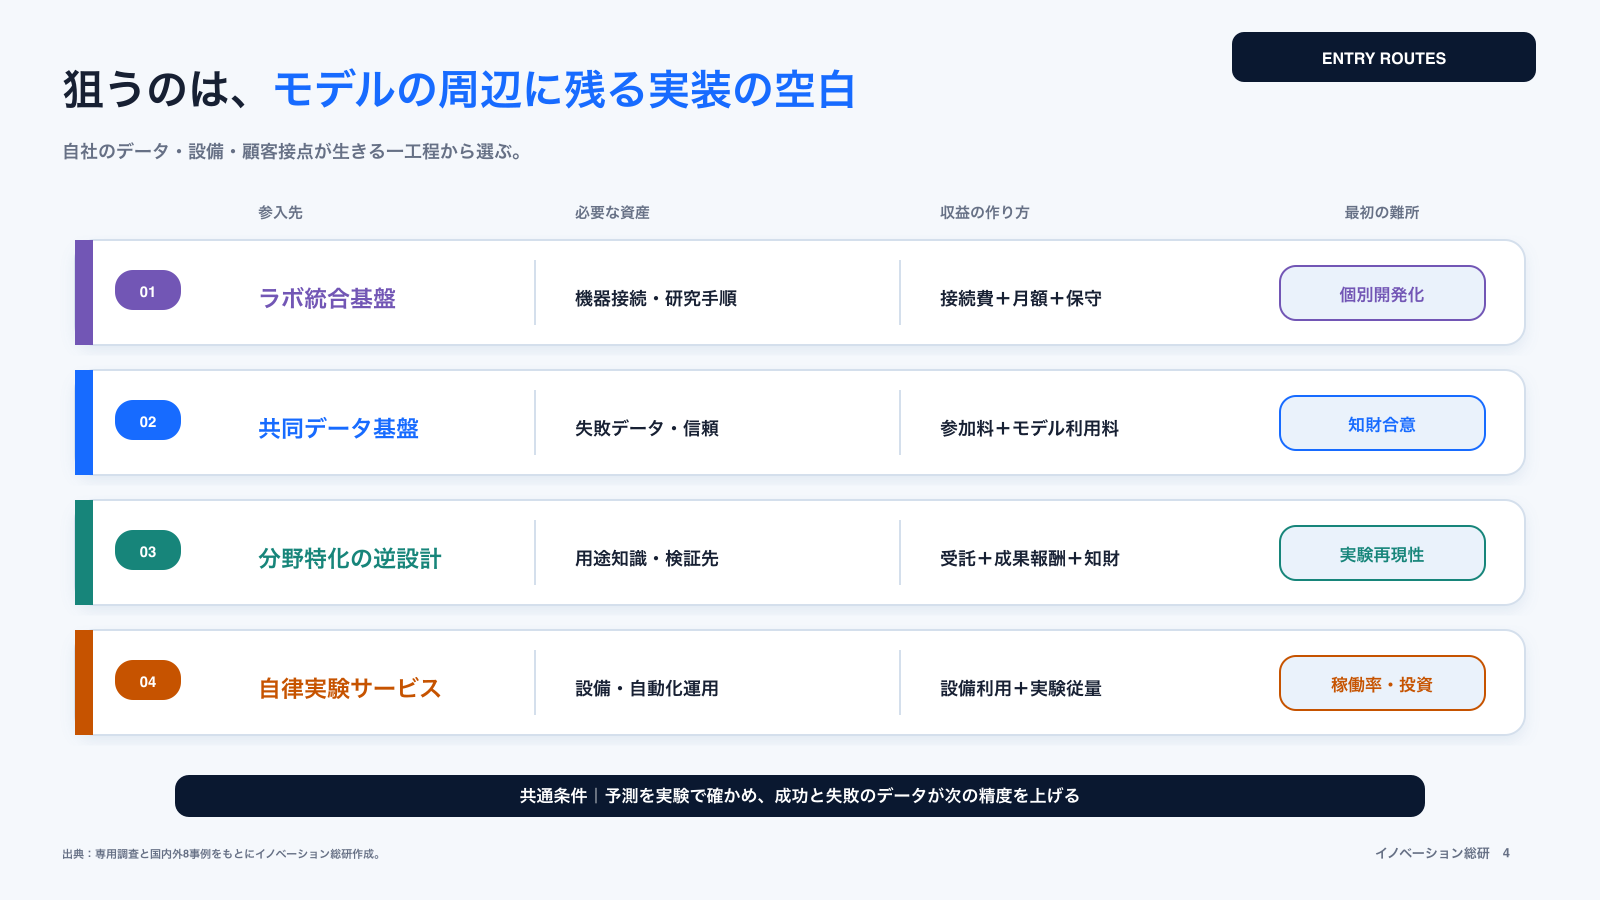
AI for Scienceで狙える4つの新規事業
新規参入では、巨大な科学基盤モデルを一から作る必要はありません。自社が持つ装置、顧客、データ、研究人材が生きる場所から入ります。
1. 研究機器とAIをつなぐラボ統合基盤
古い分析機器、電子実験ノート、表計算ファイル、AIモデルをつなぎます。機器ごとのデータ形式をそろえ、実験条件と結果を自動で記録し、次の実験へ渡すミドルウェアです。
顧客は、製薬、化学、食品、電池、半導体の研究所です。収益は初期接続費、設備ごとの月額料、保守料で作れます。強みになるのは、AI技術より、機器仕様と研究手順を理解して動かす力です。
2. 失敗データを安全に学ぶ共同データ基盤
企業内に眠る「効かなかった化合物」「合成できなかった条件」「測定に失敗した波形」を、社外へ生データを出さずに共同学習へ使います。秘密計算、連合学習、データクリーンルームを組み合わせます。
顧客は、同じ研究課題を持つ複数企業や業界団体です。参加料、モデル利用料、データ整備支援が収益になります。最大の難所は技術ではなく、知財、競争法、データ品質、成果配分の合意です。
3. 特定材料に絞った逆設計・検証サービス
全材料を対象にせず、電池電解質、熱伝導材、触媒、半導体薬液など、一つの用途へ絞ります。必要物性から候補を生成し、計算評価、外部実験、量産条件の初期確認まで提供します。
月額ソフトだけでなく、候補探索の受託料、共同特許、採用時の成功報酬を組み合わせます。材料分野は、全固体電池やペロブスカイト太陽電池のように、材料性能が製品競争力へ直結する領域と相性があります。
4. 自律実験ラボ・アズ・ア・サービス
自動合成、測定、解析を備えた設備を保有し、顧客の依頼を遠隔で実行します。顧客は高価な設備を買わず、実験単位で利用できます。
収益は、設備利用料、実験回数課金、優先枠、共同開発契約で作ります。設備投資が大きいため、最初は扱う試料、容器、測定方法を限定します。夜間稼働や複数顧客で設備を共用し、稼働率を高める必要があります。
AI for Science事業の収益モデルをどう作るか
AI for Scienceは、ソフトウェアの月額課金だけでは採算が合わない場合があります。高価な計算、専門家の支援、実験設備が必要だからです。提供価値と負担するリスクに合わせ、収益源を組み合わせます。
| 収益モデル | 顧客が払う対象 | 向く事業 | 主な懸念 |
|---|---|---|---|
| 月額・年額利用料 | モデル、画面、データ管理 | ラボ統合、計算SaaS | 利用頻度が低いと解約される |
| 計算・実験の従量課金 | GPU時間、実験回数、試料数 | クラウドラボ、解析API | 原価変動が大きい |
| 導入・検証支援 | データ整備、機器接続、評価設計 | 企業研究所への導入 | 人月商売になりやすい |
| 成果報酬 | 候補発見、性能達成、開発進展 | 創薬、材料共同開発 | 売上まで長く、不確実性が高い |
| 知財・ロイヤルティ | 特許持分、製品売上 | 独自材料・医薬品 | 権利関係が複雑になる |
初期は、導入費と利用料で固定収入を作る方が安全です。顧客の成果が測れるようになった段階で、成功報酬や知財持分を加えます。
価格の基準は「AIを何回使ったか」ではありません。候補選定までの期間、削減した実験数、設備の稼働率、再現できた候補数など、研究判断の改善へ置きます。
AI for Science導入で起きやすい6つの懸念
AI for Scienceは期待が大きい分、予測を過信すると研究費を浪費します。導入前に、技術、運用、収益の失敗条件を整理します。
1. 予測精度が高くても、実験で再現しない
学習データと異なる材料、温度、設備では精度が落ちます。論文上の評価値と、自社の試料での再現率を分けます。採用前に、未知条件を含む外部検証を行います。
2. 成功データだけを学び、同じ失敗を繰り返す
論文には成功が残りやすく、失敗条件は記録されにくい傾向があります。失敗を「役に立たないデータ」として捨てず、理由と条件をそろえて残します。
3. データ整備と機器接続の費用が膨らむ
実験記録の名称、単位、測定条件が研究室ごとに違うと、AIへ渡せません。モデル導入より前に、対象工程を絞り、最低限のデータ辞書と接続仕様を決めます。
4. 計算費と実験費を減らせない
AIが候補を大量に出すほど、確認実験が増えることがあります。候補数ではなく、有望候補一件を再現するまでの総費用で評価します。AIが使う計算資源も原価に含めます。
5. 研究者に使われず、PoCで止まる
研究者は、自分の判断根拠を説明できない提案を採用しにくいものです。AIの結論だけでなく、参照データ、信頼度、除外理由を示します。研究者を承認者として最後に置くのではなく、設計段階から参加してもらいます。
6. 安全性と責任主体が曖昧になる
危険な化合物、病原体、反応条件をAIが提案する可能性があります。禁止対象、実行権限、停止条件、人による承認を決めます。自律化の範囲が広いほど、誰が実験を止めるかを明確にします。
研究データと知財をどう守るか
研究データは、AI for Scienceの燃料であると同時に、企業の競争力そのものです。外部サービスへ入力した時点で、秘密情報、共同研究契約、輸出管理、個人情報に触れる可能性があります。
最低限、次の五点を契約と運用で決めます。
- 入力データをサービス提供者が再学習に使えるか
- 生成した候補と、改良モデルの権利を誰が持つか
- 共同研究先のデータを混ぜる場合、誰が許可するか
- 実験ログとモデルの版を、どの期間保存するか
- 危険用途や輸出管理対象を、どこで止めるか
知財では、「AIが作ったから誰のものでもない」とは扱えません。既存特許との関係、発明への人の関与、共同開発契約、営業秘密として守る範囲を整理します。
また、クラウドへ出せない研究データもあります。その場合は、オンプレミス環境、専用クラウド、匿名化、連合学習を使い分けます。安全性を理由にすべて閉じると学習が進まず、共有しすぎると競争力を失います。データごとに公開、共同利用、社内限定を分ける設計が必要です。
NEXT STEP
次のステップ
モデルより先に、研究工程と検証責任を決める。
候補生成、計算評価、実験、データ更新のどこへ入るかを分け、顧客価値と知財の境界を設計します。
AI for Scienceへの参入・提携・待機・見送り
参入判断は、「成長市場だから入る」では決まりません。自社が独自に持つ資産と、予測から実験までのどこを担えるかで四つに分けます。
| 判断 | 向いている状態 | 次に行うこと |
|---|---|---|
| 参入 | 独自データ、実験設備、特定業界の顧客がある | 一つの研究工程を商品化し、再現率と費用を測る |
| 提携 | AIやソフトはあるが、実験・科学人材がない | 大学、研究機関、装置会社と検証責任を分ける |
| 待機 | 顧客課題はあるが、データと評価方法がない | データ整備と評価指標を先に作る |
| 見送り | 汎用モデルを作る以外に差別化がなく、計算資本もない | 顧客に近い統合・検証・運用の領域へ再設計する |
IRIでは、参入可否を「技術が新しいか」だけで評価しません。顧客が現在払っている研究費、代替する工程、実験での検証可能性、独自データの増え方、知財の取り分を分けて考えます。
最初に確認したいのは、AIで出せる候補の数ではありません。顧客が次の意思決定をできる証拠を、誰が、いくらで、何日で作れるかです。
AI for Science事業化を相談したい方へ
AI for Scienceは、創薬、材料、研究設備、クラウド、データ事業で参入条件が異なります。モデル比較から始めると、顧客の研究工程と収益の設計が後回しになりがちです。
イノベーション総合研究所では、次の論点を一緒に整理します。
- 対象とする研究工程と顧客課題
- 国内外プレーヤーと、自社が入る産業レイヤー
- 独自データ、設備、顧客接点の棚卸し
- 予測を実験で確かめる体制と提携先
- 利用料、受託、成果報酬、知財を組み合わせた収益モデル
- データ管理、安全性、知財、責任分担
候補技術が決まっていない段階でも構いません。参入、提携、待機、見送りの条件を整理し、自社が優先して確かめる論点へ落とします。
AI for Scienceに関するよくある質問
AI for Scienceを検討するときに、経営企画、研究開発、新規事業の担当者から出やすい質問を整理します。
AI for Scienceを研究支援から事業へつなぐ
AI for Scienceは、研究者がAIを使うという話から、研究開発の工程を組み替える話へ進んでいます。AlphaFoldは生物学の共通基盤を広げ、MatterGenは必要物性から材料を作り、A-Labは候補を実験で確かめました。国内でもMatlantis、理研AGIS、研究設備の統合企業が動いています。
一方、モデル単体で持続的な事業を作るのは簡単ではありません。計算費、実験費、データ整備、研究者の受容、安全性、知財が収益を左右します。
新規参入では、次の順番が有効です。
- 顧客の研究工程を分解し、時間と費用が詰まる場所を特定する
- 自社のデータ、設備、顧客接点が生きる一工程を選ぶ
- AIの予測を実験で確かめ、意思決定へ使える証拠を作る
- 成功と失敗のデータが増え、次の精度と採算が改善する循環を作る
- 利用料、受託、成果報酬、知財の組み合わせを決める
AI for Scienceの勝者は、もっとも大きなAIを持つ企業とは限りません。科学の問い、計算、実験、事業判断をつなぎ、検証済みの独自データが増え続ける仕組みを持つ企業です。
CONTACT
お問い合わせ
AI for Scienceを、モデル比較で終わらせない。
研究課題、独自データ、実験接続、収益モデル、知財と検証責任を整理し、参入・提携・待機・見送りの条件へ落とします。


