
投稿日:2026.09.04 最終更新日:2026.10.09
デジタルツインは“顧客”まで再現する時代へ|国内外8事例と新規事業
デジタルツインは、工場や都市だけの技術なのか。
顧客の反応まで、事業判断に使えるのか。
結論は、顧客を再現する性能より、どの判断なら任せてよいかを検証する仕組みが重要です。国内外8事例から、実装の差と参入余地を読み解きます。
この記事の結論
生成した回答数よりも、人間の回答との違いを確かめ、使える判断を限定できるかが重要です。
- AIペルソナ、合成ユーザー、顧客デジタルツインを区別します。
- 国内外8事例を、用途と実装段階に分けて解説します。
- 4つの参入ルートと、参入・提携・待機・見送りの条件を示します。
目次
デジタルツインとは?「モノの再現」から「意思決定の再現」へ
デジタルツインとは、現実にあるモノや人、業務の状態をデジタル空間に再現し、観測や予測、シミュレーションに使う仕組みです。工場の設備を仮想空間に写し、故障や生産量を予測する使い方がよく知られています。
いま起きている変化は、再現する対象が設備から顧客へ広がったことです。具体的には、購買履歴や問い合わせ、調査回答、行動ログなどを使い、そのデータから、顧客が商品や価格、広告、サービス変更にどう反応するかを仮想的に試します。
これが顧客デジタルツインです。
提供企業によって呼称には幅があります。IPAのデジタルツインの解説が示す現実データとのつながりを踏まえ、本稿では、人物像との対話、合成回答、実データを更新して予測する仕組みを区別します。
これは用途を比較するための実務上の整理で、統一された業界規格ではありません。
自然な回答が返ることと、商品や価格の判断に使えることは別です。データが少ない段階では質問案を広げる用途にとどめ、実在顧客との比較ができた用途から利用範囲を広げます。
全ての案件で高度なツインを構築する必要はありません。
顧客デジタルツインと合成ユーザーは何が違うか
この領域では、合成ユーザー、AIペルソナ、合成回答者、顧客デジタルツインという言葉が混在しています。比較するのは名称より、使うデータ、更新頻度、任せる判断の重さです。
| 区分 | 主なデータ | 更新 | 得意な用途 | 任せない方がよい判断 |
|---|---|---|---|---|
| 一般的なAIペルソナ | 属性と指示文 | 原則固定 | 仮説出し、質問案の確認 | 需要予測、売上計画 |
| 合成ユーザー | 調査、インタビュー、公開情報 | 調査ごと | コンセプトの初期評価、UXの論点探索 | 最終的な商品採否 |
| 合成回答者 | 実査データ、統計モデル | データ投入時 | 少数セグメントの補完、調査の高速化 | 未知の市場の代表値推定 |
| 顧客デジタルツイン | CRM、CDP、購買、接点ログ | 継続更新 | 施策の事前検証、解約や反応の予測 | 個人への重大な自動決定 |
合成ユーザーは、実在しない仮想参加者です。商品案への反応を聞いたり、インタビューの質問を磨いたりする用途に向きます。
一方、顧客デジタルツインは、実在する顧客や顧客群の状態をデータで更新し、将来の行動を予測する運用基盤を指します。
両者の機能が重なる製品もあります。導入時には「何を再現したか」「どのデータで確かめたか」を確認し、検証のない出力を需要や売上の根拠にしないことが重要です。
なぜ今、顧客の意思決定をシミュレーションするのか
背景には、商品開発の速度と顧客理解の速度が合わなくなったことがあります。生成AIで案を大量に作れても、人へのインタビューや調査には募集、設計、実査、集計の時間が必要です。
そのため、候補を人に見せる前の「0次検証」が詰まりやすくなりました。
想定用途の一つは、この前工程の短縮です。例えば、50案の名称から人へ提示する5案を選ぶ、といった使い方が考えられます。
インタビューで聞くべき反論や、価格変更で不満が出る顧客層も仮説にできます。ここでは正解を決めるのではなく、人へ確かめる問いを良くします。
もう一つの要因は、企業が持つ顧客データの増加です。たとえば、CRM(顧客管理システム)には商談と問い合わせ、CDP(顧客データ基盤)にはWebやアプリの行動が蓄積されています。
さらに、コールセンターには顧客との会話があります。ただし、データが分断されたままでは過去の集計で終わります。
そこで、AIで文脈を読み、仮想顧客との対話に使えれば、施策前のシミュレーションへ進めます。
一方で、技術が進んでも現実の顧客は完全には再現できません。景気、競合、流行、家族の会話、店頭体験など、データにない出来事が意思決定を変えるからです。
したがって価値は「予言」ではなく、仮説を早く広く試し、外れ方を把握することにあります。
市場の現在地は「独立市場」ではなく3市場の交差点
顧客デジタルツインだけを切り出した、信頼できる市場規模はまだ定まっていません。調査会社が示す数字も、合成データ、マーケティングリサーチ、CDP、デジタルツインのどこまでを含むかで大きく変わります。
異なる定義の予測を単純に足すと、重複計上のおそれがあります。自社の売上を見積もる際は、対象部門、利用件数、単価に分け、調査・IT・事業部のどの予算から支払われるかを確認します。
支出元は大きく3つあります。具体的には、第一は、アンケート、インタビュー、コンセプトテストなどの調査予算です。
第二は、CRM、CDP、データ統合、AI基盤などのIT予算です。第三は、商品開発、広告、CX改善など、施策を実行する事業部の予算です。
単発調査の支援と、継続的な顧客データの運用では、費用構造も変わります。前者は調査設計と人による確認費、後者はデータ連携・更新・権限管理の費用まで見積もります。
継続収益を前提にするなら、顧客が定期的に判断する仕事と更新頻度を確認します。
デジタルツインを顧客理解に使う国内外8事例
主要事例を見ると、各社は同じ「AI顧客」を売っているわけではありません。大量の案を絞るもの、調査データを補うもの、生活者と対話するもの、施策結果を予測するものに分かれます。
| 企業・機関 | 取り組み | 実装段階 | 主な価値 |
|---|---|---|---|
| 電通 | People Model/People Research | 社内本格運用、複数案件で活用 | 生活者層の抽出と対話 |
| 電通デジタル | ∞AI Customer Twin | サービス提供 | 企業データによる仮想顧客AI |
| 博報堂 | バーチャル生活者 | サービス開発、活用展開 | 生活者視点の発想と対話 |
| Qualtrics | Synthetic Panels | 製品機能として提供 | 調査回答の高速生成 |
| Fairgen | Fairgen Boost | 商用提供 | 少数セグメントの統計的補完 |
| Synthetic Users | AIによるユーザー調査 | 商用プラットフォーム | 仮想参加者へのインタビュー |
| Aaru/Accenture | 消費者行動のマルチエージェント予測 | 投資・協業、サービス統合計画 | 集団反応のシミュレーション |
| Ipsos/Stanford | デジタルツイン・パネル | 共同研究・検証 | 合成回答の妥当性評価 |
表から分かるのは、仮想顧客への対話と、継続的な顧客予測が同じ段階ではないことです。以下では、8事例の提供内容と、事業として読むべき点を順に解説します。
電通は、1億人規模のPeople Modelを調査の前工程へ入れた
電通の事例から参考にしたいのは、人間調査をなくすことではなく、実査へ進める候補と質問を早く絞り、プランナーの探索量を増やす使い方です。
電通の2025年11月12日の発表によると、独自の大規模調査データを基に「People Model」を開発し、「People Research」の社内本格運用を始めました。1億人規模とは生成・再現する仮想ペルソナの規模であり、1億人へ今回調査したという意味ではありません。
特徴は、任意の質問から生活者セグメントを抽出し、その層を代表するAIペルソナへ追加質問できる点です。電通は、新商品開発で多数のコンセプトや表現案を絞る用途など、複数のプロジェクトで利用したと説明しています。
ただし、公開情報だけでは、個別案件の予測精度や外部提供条件までは分かりません。
電通デジタルは、企業固有データからカスタマーツインを作る
電通デジタルの「∞AI Customer Twin」は、顧客情報を統合する「∞AI Customer Data Hub」を基に、仮想顧客AIとの対話や調査を支援します。企業固有のデータを、企画や施策の仮説づくりへつなぐサービスです。
People Modelが幅広い生活者の基盤であるのに対し、こちらは企業固有の1stパーティデータへ寄せる設計です。「∞AI Customer Data Hub」で顧客カルテを更新し、企画やメディア、CXの支援機能へつなげる構想になっています。
当研究所が着目するのは、人物像との対話だけでなく、元データを更新する仕事もサービスに含めている点です。導入効果を調べる際は、同じ製品群の広告制作などの成果と混ぜず、Customer Twinを使った判断の改善を確かめます。
博報堂は、7,000タイプのバーチャル生活者を発想支援に使う
博報堂が2024年3月に紹介した「バーチャル生活者」は、HABITという生活者調査の約7,000人分のデータを基にしたものです。調査に答えた人のデータと、AIが生成する対話は別です。
実在する本人が新しい商品について回答しているのではなく、価値観や生活行動を踏まえた発想支援に用います。
さらに2025年2月6日には、実在する販売員の個性を反映する「バーチャル販売員」のプロトタイプを発表しました。これは顧客を模倣するだけでなく、接客する側のデジタルツインへ応用した例です。
同社の事例は、合成ユーザーが調査部門だけの道具ではないことを示します。商品開発、企画、接客設計へ広げられますが、サービスプロトタイプと本番導入を分けて評価する必要があります。
Qualtricsは、合成回答者を既存の調査基盤へ組み込んだ
QualtricsのSynthetic Panelsの公式仕様では、対象は米国の一般人口、言語は英語に限られます。重要なのは、画像・動画・ファイル・リンク先の内容を理解しなくても、回答自体は生成されるという制約です。
パッケージ画像を評価させたつもりでも、画像を見ずに答えている場合があります。
重要なのは、独立したAIチャットではなく、質問票、配信、回答、分析を扱う既存基盤の中に合成回答を置いたことです。利用者は、人間の回答と合成回答を区別しながら、同じ業務の中で扱えます。
この形は導入しやすい一方、提供範囲を超えた利用に注意が必要です。米国一般人口向けのモデルで、日本の専門職や高齢者、希少疾患患者を代表できるとは限りません。
Fairgenは、ゼロから人物を作らず、少数回答を補う
Fairgenの「Fairgen Boost」は、企業が集めたアンケート回答を基に、少数セグメントの合成回答を増やすサービスです。対象は閉じた質問の定量データであり、自由な会話型インタビューとは役割が違います。
同社は、入力データの一部でモデルを作り、残りを正解データとして比較するホールドアウト検証を説明しています。評価するのは、回答分布、設問ロジック、データ処理の流れです。
合成回答を増やしても、実際に調査した人の数が増えるわけではありません。元の回答者数と追加した合成回答数を分けて表示し、独立した人間の回答と同じ扱いで精度を説明しないことが必要です。
検証用に残した人の回答を繰り返し調整へ使うと、公平な評価も難しくなります。
新規事業で学ぶべき点は、「何でも答えるAI」より利用範囲を狭くしたことです。未知の人物を作るのではなく、実データが少ない層を補うことで、検証可能性を高めています。
Synthetic Usersは、仮想参加者とのインタビューをAPI化した
Synthetic Usersは、AIで作った仮想参加者へインタビューできるプラットフォームです。利用者は、対象となる属性や課題を設定して使います。
さらに、調査テーマ、提示する解決案、対象者、対話、分析を一つの流れで管理できます。
公式ドキュメントでは、PythonとTypeScriptのSDKも案内されています。これにより、プロダクト開発の工程へ合成ユーザー調査を組み込めます。
つまり、単発のチャットより、調査設計と結果管理を標準化しやすい形です。
ただし、同社の結果はあくまでAIが生成した反応です。自社の顧客インタビューやサポート履歴で根拠づけ、実際の利用者による確認を残すことが前提になります。
AaruとAccentureは、個人回答より集団の反応を予測する
Aaruは、多数のAIエージェントで消費者集団の行動や反応をシミュレーションする企業です。Accentureは2025年3月4日、同社への投資と協業を発表しました。
これは、Aaruの予測基盤を、新商品、マーケティング、顧客戦略などへ組み込む計画です。
公表されているのは、予測基盤「Lumen」をAccenture Songのサービスへ組み込む計画です。多数のエージェントを使う説明だけから、口コミや模倣の広がりまで正確に再現できると判断せず、対象市場と実際の結果との比較を求めます。
一方、発表には提供企業側の評価が含まれます。どの市場で、どの程度の誤差で、実績と一致したかは案件ごとに確認すべきです。
IpsosとStanfordは、実在回答者を基に妥当性を共同検証する
Ipsosの2025年8月6日の発表は、Stanford大学の研究チームと、実在回答者のデジタルツインを共同開発・検証する取り組みです。米国のKnowledgePanelを起点とし、将来は他国への拡大も予定しています。
発表時点の共同研究であり、特定の予測精度や事業成果を達成したという報告ではありません。
性能の読み方は、研究によっても違います。Stanford HAIが紹介した研究では、米国の1,052人への約2時間のインタビューからエージェントを作りました。
社会調査への回答で示された85%は、本人が約2週間後に再回答する際の一致度を基準にした相対値で、人間の行動全般を85%正しく予測したという意味ではありません。
一方、Pengらの比較研究(2026年4月の改訂稿)は、19の事前登録研究・164の指標を検証し、本人とツインの回答の相関係数は平均約0.20と報告しています。実人数は1,784人で、研究への累積参加数とは異なります。
Stanfordの研究情報サイトにも紹介されていますが、同大学が実施した研究という記載は正確ではありません。
85%と相関0.20は、対象・課題・評価指標が異なり、性能が85%から20%へ低下したとは読めません。導入時は、平均精度の数字より、自社が決めたいことと同じ条件での検証結果を求めます。
顧客デジタルツインを業務へ導入する4つの確認条件
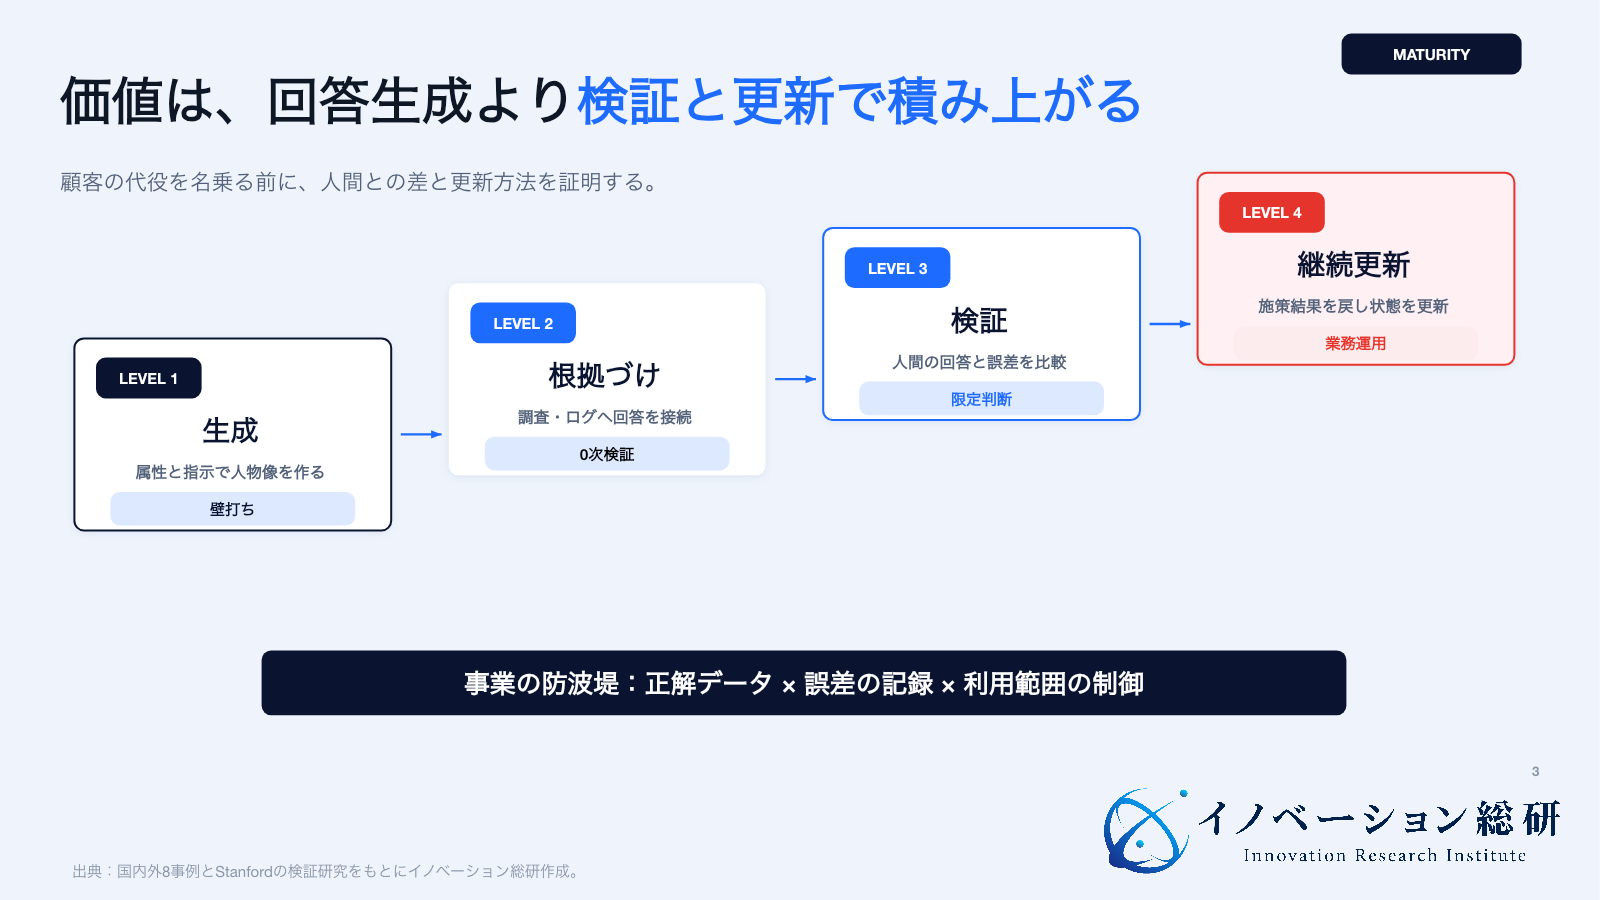
8事例から、導入前に確認する事項を四つに整理します。生成・根拠確認・人との比較・継続更新を分けると、まだ任せられない仕事が見えてきます。
これは各社の優劣を決めるランキングではなく、自社の利用条件を確かめる手順です。
1.発言の根拠をたどれる
AIの回答が、どの調査、購買履歴、問い合わせ、公開統計に基づくかを確認できることです。根拠が分からない回答は、会議の刺激には使えても、投資判断の証拠には使えません。
2.実在顧客との誤差を測れる
合成回答と人間の回答を同じ質問で比べ、どの属性やテーマで外れるかを測ります。全体の一致率に加え、価格、感情、未知の商品、少数派など、重要な場面ごとに誤差を見ます。
3.環境変化に合わせて更新できる
過去の調査から作った人物像は、制度、景気、競合、流行が変わると古くなります。入力データの基準日、更新頻度、再学習の条件を契約に含める必要があります。
4.結果を次の業務へつなげられる
PDFを出すだけでは単発の調査で終わります。商品候補の絞り込み、インタビュー設計、CRMの施策案、広告テストなど、次の工程へ結果を渡せることが継続利用の条件です。
架空例:有望な商品案を落としていないかを確かめる
飲料メーカーが6案から3案へ絞る架空例です。導入前の比較試験として、同じ6案を、合成ユーザーと実在する対象顧客の両方へ提示したとします。
以下の順位は説明用で、特定サービスの実績ではありません。
| 比較項目 | 結果の例 | 判断への影響 |
|---|---|---|
| AIが残す上位3案 | A・B・C | Dを実査前に除外してしまう |
| 人の調査での上位3案 | A・C・D | AIで残った有望案は3案中2案 |
| 次に確認すること | Dを好む顧客層、理由、設問への入力条件 | その層や新規性の高い案を、AIだけで落とさない |
上位3案中2案が重なっても十分かどうかは、有望案を見逃す損失と調査費によって変わります。AIで何案を減らせたかだけでなく、人なら選んだ案を落としていないかを測ります。
AIが低評価を付けた案の一部も人へ確認し、必要な確認費を含めて、従来の調査より時間・費用・判断品質が改善するかを比較します。
顧客デジタルツインの業務分担と参入候補
価値連鎖は、計算基盤、モデル、データ整備、シミュレーション、業務実装、検証・監査に分かれます。生成AIのAPIだけを包む部分は参入しやすい反面、模倣も容易です。
大手クラウドや基盤モデル企業は、計算と汎用AIを押さえます。また、広告会社や調査会社は、長年の生活者データと顧客接点を持ちます。
さらに、CRMやCDPの企業は、企業内データと業務フローを押さえています。そのため、新規参入企業が正面から同じ資産を作るのは難しいでしょう。
当研究所が考える参入候補の第一は、日本語や国内商習慣に合う業界別の評価データです。第二は、人間の調査と合成調査を同じ設計で比べる検証サービスです。
第三は、入力データ、モデル、出力、利用者を記録する監査基盤です。第四は、調査結果を商品開発や営業の判断へ変える導入・運用支援です。
検証と運用を支える仕事も、仮想顧客を作る以外の参入候補です。 未開拓市場と断定せず、既存ベンダーの対応範囲、顧客が困っている作業、支払意思を確認します。
比較用データと評価手順を蓄積できるかが、継続提供を考える材料になります。
NEXT STEP
次のステップ
AI顧客を、判断できる事業へ。
対象顧客、使うデータ、比較する正解、任せる判断、責任分界を整理し、参入位置を具体化します。技術の用途探索や顧客検証、連携先の開拓に関する支援は、TeamPro Technologiesのサービスページで確認できます。
新規事業で狙う4つの参入ルート
新規事業の入口は、本体プラットフォームだけではありません。自社の顧客、データ、調査能力、業務システムへの接続力から選びます。
参入ルート1.商品開発の0次検証サービス
最初の顧客は、消費財、SaaS、金融、モビリティなどの商品企画部門です。多数のコンセプト、名称、訴求案を合成ユーザーで比較し、人間調査へ進める候補を絞ります。
売上は、案件単位の調査設計と利用料から始められます。そして必要な資産は、対象業界の顧客理解、質問設計、実査との比較データです。
なお、AI基盤は外部と組めますが、結果の解釈と採否基準は自社で持つ必要があります。
止める条件は、人間調査との比較で順位が安定しない場合です。新規性が高い商品や、感情、文化、身体感覚が強いテーマは、0次探索に限定します。
参入ルート2.少数セグメントの合成回答補完
最初の顧客は、調査会社、製薬、金融、B2B企業など、対象者を集めにくい組織です。既存の回答を基に、不足する層を統計的に補います。
売上は、データ量や案件数に応じた利用料、調査会社への組み込み提供で作れます。必要なのは、統計モデル、調査票の構造理解、ホールドアウト検証、監査記録です。
特に対象者が少ない分野では、元データの偏りを合成で解消できるとは限りません。実査の人数、合成した数、モデルの作成に使っていないデータでの検証結果を分けて示します。
採算も、生成費だけでなく、データを取得できる権利、統計検証、顧客への説明に要する費用を含めて計算します。
止める条件は、元データが少なすぎる、偏りが大きい、未知の変化を含む場合です。個人を再現するのではなく、集団の傾向を補う用途に限定します。
参入ルート3.業界特化の顧客デジタルツイン運用
最初の顧客は、継続的な顧客接点と1stパーティデータを持つ企業です。小売、通信、金融、サブスクリプション事業などが候補になります。
提供物は、顧客データの統合、仮想顧客群の構築、施策の事前テスト、結果の更新までを含む運用基盤です。売上は初期構築費と年間利用料、運用支援で作ります。
必要な提携先は、CDP、CRM、クラウド、セキュリティ、法務です。データ処理の目的、学習への利用、アクセス権、削除、再学習、誤予測時の責任を契約で分けます。
止める条件は、顧客IDを安全に統合できない、正解データを継続取得できない、施策結果を戻せない場合です。静的な顧客像しか作れないなら、継続課金の根拠が弱くなります。
参入ルート4.評価・監査・ガバナンス基盤
最初の顧客は、顧客デジタルツインを導入する企業と提供ベンダーです。入力データの来歴、モデル版、質問、出力、承認者、実査との差を記録します。
売上は、評価設計、監査、継続モニタリング、業界別ベンチマークから作れます。技術だけでなく、調査、個人情報、AIガバナンス、現場運用を横断する力が必要です。
モデルの性能が上がっても、自社の用途に合うかを確かめる仕事は残ります。ただし、それを外部の有料サービスへ任せる需要があるかは別に検証します。
ただし、独自の正解データを蓄積できない場合は、汎用チェックリストにとどまり、価格競争になりやすいでしょう。なお、参入候補を同じ物差しで比べる方法は、事業性評価の考え方で整理しています。
最大の懸念は「もっともらしい誤差」を経営判断に使うこと
生成AIの回答は、自然な文章であるほど正しく見えます。しかし、顧客デジタルツインでは、文章の自然さと予測の正しさは別です。
主な懸念を、導入前に責任分界へ落とす必要があります。
未知の商品ほど過去データが効かない
学習データに似た商品なら、回答の型を作りやすくなります。反対に、既存カテゴリにない商品は、過去の常識から誤って評価される可能性があります。
革新的な案を平均的な反応だけで落とす使い方は避けます。
少数派と強い感情が薄くなる
AIは典型的で協調的な回答へ寄りやすく、少数派の体験や矛盾した感情を平らにすることがあります。前述のPengらの比較でも、ツインの回答のばらつきは人間より小さくなる傾向が報告されています。
個人情報を外部AIへ渡す責任が残る
CRMや問い合わせには個人データが含まれます。個人情報保護委員会の注意喚起に沿って、利用目的の範囲、サービス提供者による機械学習への利用、必要な同意等を確認します。
「学習に使わない」設定だけで全て解決するとは扱わず、保存先、委託・第三者提供の関係、アクセス権限も個別に確認します。
匿名化したつもりでも、複数の属性を組み合わせると個人を推測できる場合があります。誰のデータを、何の目的で、どこへ送り、いつ消すかを先に決めます。
差別や不利益を自動化する恐れがある
顧客像を使って価格、与信、採用、医療などの重大な判断を自動化すると、過去の偏りを拡大する可能性があります。顧客デジタルツインは、仮説を作る用途と、個人へ処遇を決める用途を分けるべきです。
誰が誤差を説明するか曖昧になりやすい
モデル提供者は「参考情報」と説明し、導入企業は「AIの出力」と説明しがちです。しかし、最終的に施策を決めるのは利用企業です。
モデル、データ、調査設計、業務判断の責任を契約と運用で分けます。
事業判断を4つに分けて考える
参入:業界固有の顧客データと正解データがある
0次検証、合成回答補完、業界特化運用から選びます。
提携:顧客接点はあるがAI・統計基盤が弱い
基盤モデルやCDPは外部と組み、自社はデータ設計と評価を持ちます。
待機:結果を業務へ戻す工程がない
CRMや商品開発工程との接続時期を決めてから投資します。
見送り:誤差を測れない重大判断へ使いたい
人の判断と異議申立てを残せない用途は見送ります。
参入・提携・待機・見送りをどう決めるか
判断は、AI技術を持っているかだけで決まりません。顧客接点、正解データ、結果を戻す業務、リスクを負える範囲を見ます。
| 判断 | 向いている状態 | 最初に確認すること |
|---|---|---|
| 参入 | 特定業界の顧客と実査データを持つ | 誤差を比較できる正解データがあるか |
| 提携 | 顧客接点はあるがAI・統計基盤が弱い | データ利用、モデル更新、知財の分担 |
| 待機 | 用途はあるが結果を業務へ戻せない | CRMや商品開発工程との接続時期 |
| 見送り | 個人への重大判断を自動化したい | 人の判断と異議申立てを残せるか |
参入に向くのは、業界固有の顧客データと、人間による検証機会を持つ企業です。調査会社、広告会社、コールセンター、CRM導入会社、業界団体などは、既存資産を転用できます。
提携に向くのは、顧客と業務を理解している一方、モデル構築や統計検証を単独で持てない企業です。モデルは外部から調達し、自社はデータ設計、評価、運用に集中する選択肢があります。
待機すべきなのは、利用場面が「面白い回答を得る」だけで、誰が何を変えるか決まっていない場合です。一方、見送るべきなのは、誤差を測れないまま売上予測や個人処遇へ使おうとする場合です。
なお、小さく試した結果を本番の判断へつなぐ手順は、PoCから事業化へ進む方法も参考になります。
デジタルツインに詳しい相談先の選び方
相談先は、生成AIのデモが巧みかではなく、事業判断の境界を設計できるかで選びます。少なくとも次の点を確認します。
- AIペルソナ、合成回答者、顧客デジタルツインを区別して説明できる
- 人間の調査や実績データと比較する評価方法を持っている
- 予測が外れやすい用途を先に説明できる
- 個人情報、権限、削除、学習利用を契約に落とせる
- 出力を商品開発、CRM、営業、CXの業務へつなげられる
- 参入だけでなく、提携、待機、見送りを提案できる
イノベーション総研では、技術の選定だけでなく、最初の顧客、提供価値、収益モデル、提携先、責任分界、見送り条件までを一つの事業設計として整理します。顧客デジタルツインの場合は、使いたい判断を先に分解し、必要なデータと検証方法を逆算することが出発点です。
デジタルツインに関するよくある質問
導入や新規事業を検討するときに、よく出る疑問を整理します。
まとめ|デジタルツイン事業は「再現」より「検証」が主戦場
デジタルツインは、設備や都市の再現から、顧客の意思決定をシミュレーションする段階へ広がっています。国内外では、生活者との対話、合成調査、少数セグメントの補完、集団行動の予測、企業データとの連携がそれぞれ商用化または検証されています。
導入前に確かめるのは、業界固有の比較用データ、実在顧客との違い、更新、監査、業務への接続です。生成数や一つの性能指標だけでなく、判断を誤る損失と人による確認費まで含めて事業性を評価します。
したがって、最初に作るべきものは「何でも答える仮想顧客」ではありません。最初に作るべきものは、任せる問いと人へ戻す問いを分ける評価設計です。
この評価設計があれば、生成結果をどこで使い、どこで人へ戻すかを顧客と合意できます。そのうえで、継続利用と支払意思を確かめます。
情報確認日:2026年9月27日。各社の機能・対象国・提供段階は参照資料の公表時点によります。
研究の数値、提供企業の説明、当研究所による判断例を区別して記載しています。
参考文献
本文で確認した事実は、次の一次情報と公式資料を基にしています。
- IPA「デジタルツインとは?」
- 電通「People Research」の本格運用開始
- 電通デジタル「∞AI」
- 博報堂「バーチャル生活者」
- Qualtrics「Synthetic Panels」
- Fairgen「Fairgen Boost」
- Synthetic Users Documentation
- Accenture「Aaruへの投資・協業」
- Ipsos「Stanford大学とのデジタルツイン・パネル共同研究」
- Stanford HAI「Simulating Human Behavior with AI Agents」
- Pengほか「Digital Twins as Funhouse Mirrors」(arXiv:2509.19088、v5)
- NTT DATA「デジタルツイン」
- 個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」
CONTACT
お問い合わせ
使える範囲と参入条件を、具体化しませんか。
企業動向、顧客データ、自社資産、検証方法を整理し、参入・提携・待機・見送りの条件へ落とします。


