
投稿日:2026.09.06 最終更新日:2026.09.20
コンテキスト・エンジニアリングとは?AIエージェントを強くする8社の実践
コンテキスト・エンジニアリングは、AIへ長文を渡す話ではない。
必要な情報だけが循環する、AIの業務環境を作る。
結論は、正しい情報を必要な時点で選び、仕事の結果から更新できるかで決まります。8社の実践と4つの参入方法から、新規事業の入口を整理します。
この記事の結論
コンテキスト・エンジニアリングの勝負は、情報量ではなく、仕事に必要な情報を選び、更新し、評価できるかで決まります。
- プロンプトエンジニアリング、RAG、コンテキスト・エンジニアリングの違いを解説します。
- Anthropic、OpenAI、Google Cloudなど8社の設計を、圧縮、記憶、業務データ、権限、時間管理から読み解きます。
- 4つの参入方法と収益モデル、古い記憶、権限、圧縮、コストへの懸念を示します。
生成AIの性能は、モデルだけでは決まりません。同じモデルを使っても、ある会社のAIエージェントは仕事を完了でき、別の会社では誤回答や手戻りが続きます。この差を生むのが、AIへ何を、いつ、どの順番で渡すかという設計です。
この設計を「コンテキスト・エンジニアリング」と呼びます。対象は指示文だけではありません。社内文書、会話履歴、顧客情報、利用できるツール、アクセス権、途中の作業結果まで含みます。
ただし、情報を多く渡せばよいわけではありません。古い規程、権限外の資料、似ているだけの文書が混ざると、AIはかえって判断を誤ります。長い会話では、必要な決定事項が大量の履歴に埋もれることもあります。
本記事では、コンテキスト・エンジニアリングの意味を、プロンプトエンジニアリングやRAGとの違いから説明します。さらに、国内でも利用できる主要8社の取り組み、産業構造、四つの新規事業、参入時の懸念を整理します。
結論は、AIへ情報を詰め込むのではなく、仕事に必要な情報だけが循環する仕組みを作れるかが勝負です。
目次
コンテキスト・エンジニアリングとは何か
コンテキスト・エンジニアリングとは、AIが仕事を進めるために使う情報全体を設計し、必要に応じて更新する取り組みです。日本語では「文脈設計」と考えると分かりやすいでしょう。
Anthropicの解説では、限られたコンテキストウィンドウへ何を入れるかを選び、維持する技術と位置づけています。目標は、最も長い入力を作ることではありません。望む行動につながる、少量で重要度の高い情報をそろえることです。
AIが一度だけ文章を作るなら、明確な依頼文で足りる場合があります。しかし、AIエージェントが複数の資料を調べ、ツールを使い、途中結果を見て次の行動を決める場合、状況は変わります。作業が進むたびに、必要な情報と不要な情報が入れ替わるからです。
たとえば、顧客対応エージェントには次の情報が必要です。
- どの問い合わせを解決するのか
- 会社として守る回答方針
- 顧客の契約、購入、過去の問い合わせ
- 最新の製品仕様と社内規程
- 注文確認や返金に使えるツール
- 人へ引き継ぐ条件と実行記録
これらを一つの長い指示文に書くのではなく、必要な時点で取得し、権限を確かめ、古い情報を外します。この一連の仕組みがコンテキスト・エンジニアリングです。
プロンプトエンジニアリングやRAGと何が違うのか
三つの言葉は対立するものではありません。プロンプトエンジニアリングとRAGは、コンテキスト・エンジニアリングを構成する部品です。
| 手法 | 主に設計するもの | 得意なこと | 単独では残る課題 |
|---|---|---|---|
| プロンプトエンジニアリング | 指示の言葉、順序、出力形式 | 役割や判断基準を明確にする | データ更新、履歴、権限を管理できない |
| RAG | 質問に近い文書の検索と引用 | 外部知識を回答時に補う | ツール、作業状態、長期記憶までは扱わない |
| コンテキスト・エンジニアリング | 指示、データ、記憶、ツール、状態、権限の全体 | AIが仕事を続けられる環境を作る | 設計・評価・運用を横断する体制が必要 |
プロンプトは「何をしてほしいか」を伝えます。RAGは「答えるためにどの資料を読むか」を助けます。コンテキスト・エンジニアリングは、さらに「今の顧客は誰か」「どこまで作業したか」「どの操作を許すか」「何を記録として残すか」まで扱います。
Salesforceのガイドも、コンテキストを指示、アクションとツール、データ入力、短期・長期記憶に分けています。RAGの仕組みと事業機会を理解したうえで、その外側まで広げた考え方です。
したがって、「RAGを導入済みだから対応できている」とは限りません。検索結果が正しくても、顧客を取り違えたり、利用できないツールを選んだり、前の手順を忘れたりすれば、業務は完了しません。
なぜ今、コンテキスト・エンジニアリングが必要なのか
背景には、生成AIの使い方が「回答」から「実行」へ広がったことがあります。長い仕事を任せるほど、AIが参照する情報は増え、途中で変化します。
第一の理由は、コンテキストウィンドウが大きくなっても、注意力は無限ではないことです。Anthropicは、入力が増えるほど重要情報の再現力が落ちる「context rot」を説明しています。不要な履歴や似た文書を大量に入れると、必要な一文が見つからなくなります。
第二の理由は、AIエージェントがツールを使うことです。AIエージェントの新規事業で説明したように、エージェントは検索、データ更新、予約、決済などを組み合わせます。ツール名や説明が曖昧で、権限も渡し過ぎていれば、誤った操作へつながります。
第三の理由は、仕事が一回の会話で終わらないことです。数時間の調査、数日にわたる開発、継続的な顧客支援では、履歴をそのまま残し続けられません。決定事項を要約し、未解決の課題を残し、重い出力を外部へ退避する必要があります。
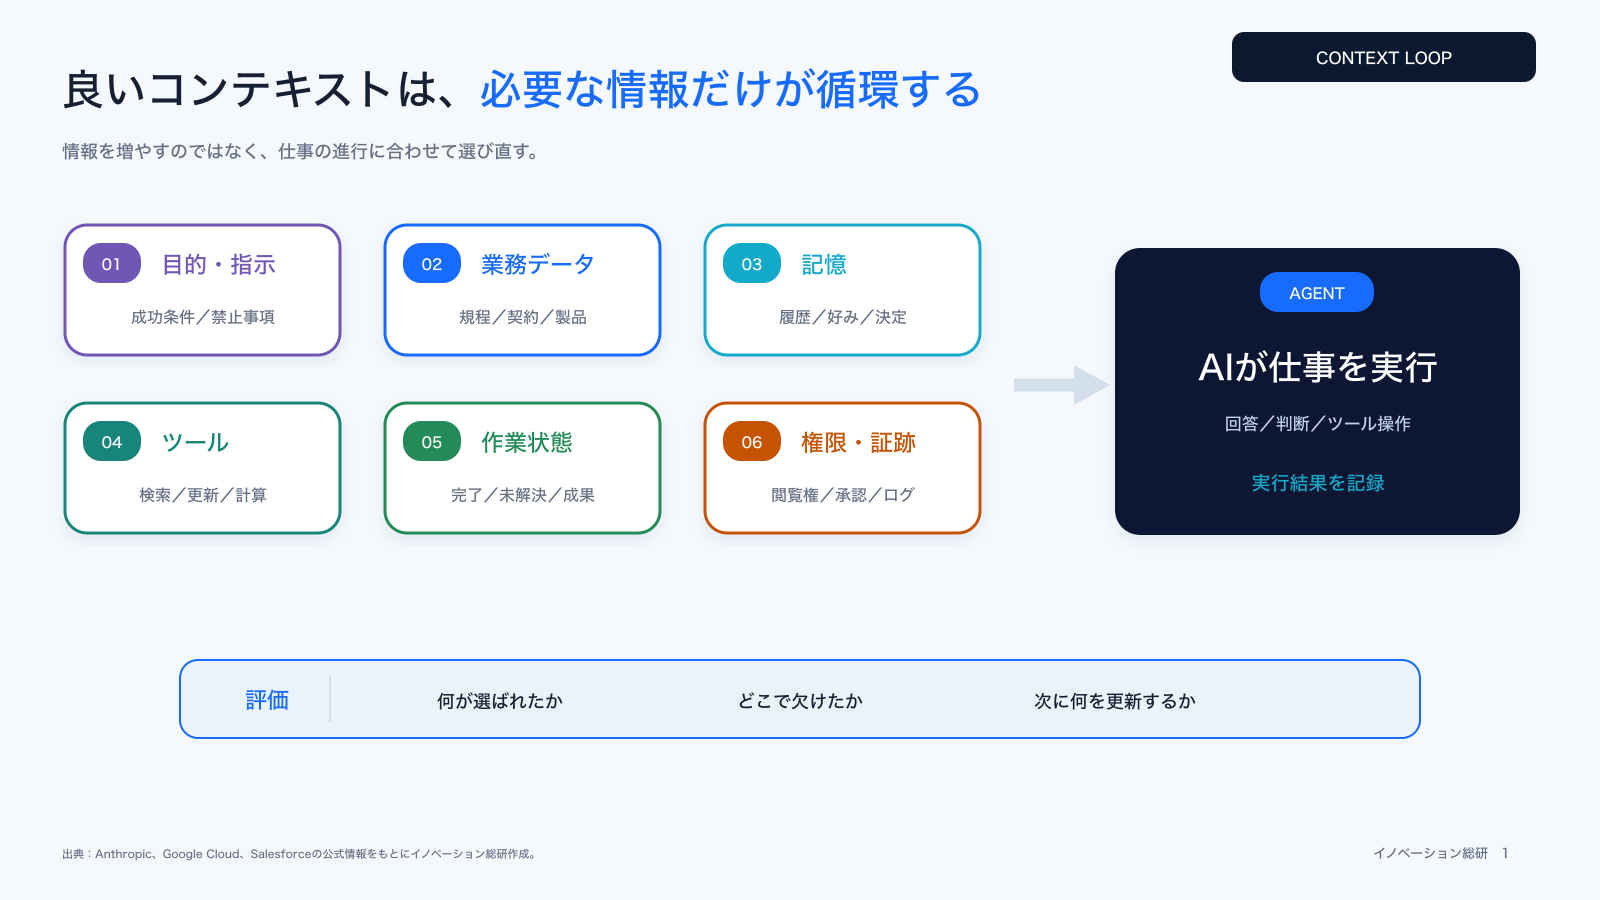
つまり、モデルの上限を広げるだけでは不十分です。必要な情報を選び、古い情報を捨て、結果から更新する運用が必要です。
設計対象は六つの情報に分ける
「コンテキスト」という言葉は広いため、そのままでは設計できません。実務では六つに分けると、抜けと詰め込み過ぎを見つけやすくなります。
| 情報の種類 | 具体例 | 設計時の問い |
|---|---|---|
| 目的・指示 | 役割、成功条件、禁止事項、出力形式 | 何ができれば仕事は完了か |
| 業務データ | CRM、規程、製品情報、契約、文書 | 最新で正しい情報はどこにあるか |
| 記憶 | 会話履歴、顧客の希望、過去の決定 | 何を残し、いつ忘れるべきか |
| ツール | 検索、更新、計算、外部API | どの場面でどのツールを使うか |
| 作業状態 | 完了手順、未解決事項、中間成果 | どこまで終わり、次は何か |
| 権限・証跡 | 閲覧権、承認条件、引用元、操作ログ | 誰が何を見て実行できるか |
六つを同じ方法で保存する必要はありません。変わりにくい方針はシステム指示へ置きます。最新の在庫や契約は、その都度データベースから取得します。長い会話は要約し、元の記録と結びます。
重要なのは、AIへ見せる前の判定です。データが新しいか、利用者に閲覧権があるか、今回の目的に関係するかを確認します。ゼロトラストの考え方と同じく、「社内データだから信頼する」のではなく、問い合わせごとに権限を確かめます。
評価も出力だけで終わりません。どの資料が選ばれ、どの指示が効き、どのツール呼び出しで失敗したかを追います。答えを直すだけでなく、情報を選ぶ仕組みを直すことが改善につながります。
コンテキスト・エンジニアリングの市場はどう立ち上がるか
コンテキスト・エンジニアリングには、統一された市場規模がまだありません。ベクトルデータベース、RAG、エージェント基盤、メモリ、企業内検索などをどこまで含めるかで数字が変わるためです。
専用Deep Researchは、隣接する市場の民間予測を整理しています。ただし、それらを足し合わせて一つの市場規模とすることはできません。事業判断では、金額よりも「製品カテゴリが分かれ始めたか」「顧客が独立予算を持ち始めたか」を見る方が安全です。
現在は、次の三つが立ち上がりの合図です。
- 大手クラウドが、エージェント向け記憶やコンテキスト管理を標準機能にしている
- メモリ専業や時間軸ナレッジグラフの企業へ資金が流れている
- CRM、企業内検索、開発支援など、業務アプリ側が文脈管理を競争軸にしている
たとえば、Mem0は2025年10月にSeedとSeries Aを合わせて2,400万ドルを調達したと公式発表しています。Google CloudはVertex AI Agent EngineにMemory Bankを用意し、SalesforceはAgentforceでIntelligent Contextを提供しています。市場は「単独ソフト」の形ではなく、既存クラウドや業務アプリへ組み込まれながら広がっています。
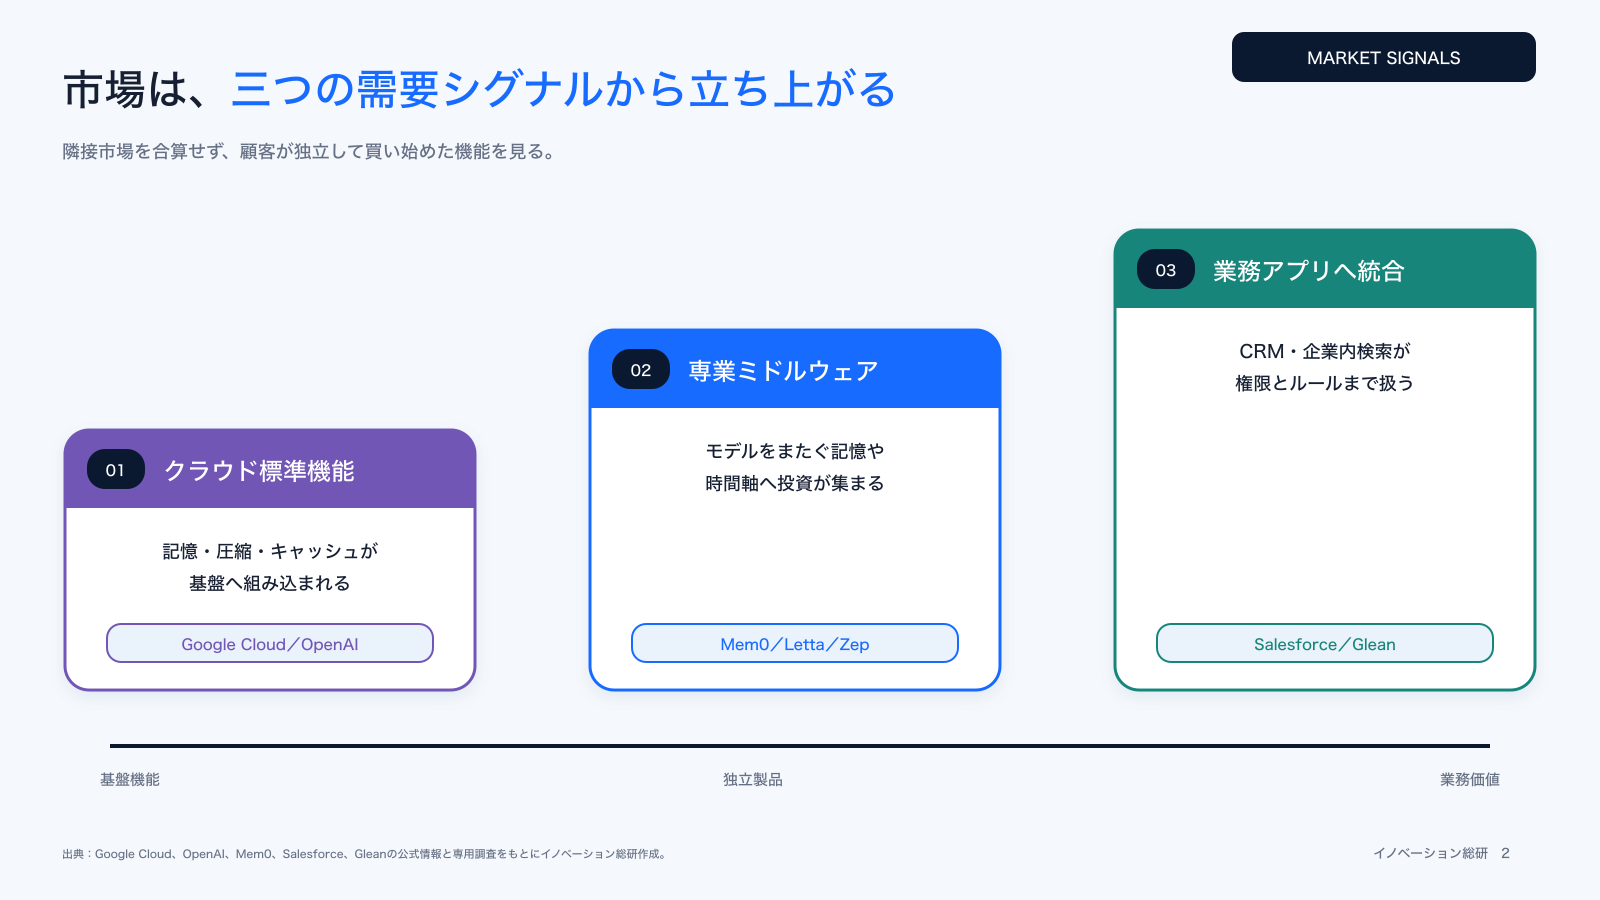
新規参入企業にとっては、大手クラウドと同じ汎用メモリを作ることが目的ではありません。特定業界のデータ、権限、更新頻度、評価方法を知る企業が、足りない実装層を押さえられるかが重要です。
コンテキスト・エンジニアリングを支える四層の産業構造
市場を製品名だけで見ると、競合と提携先を見誤ります。専用調査をもとに、役割を四層へ分けます。
| 層 | 提供価値 | 主な企業・製品例 | 競争力になるもの |
|---|---|---|---|
| データ・検索基盤 | 文書、ベクトル、関係性、更新履歴を保存・検索 | Pinecone、Weaviate、Neo4j、Elastic | 検索精度、速度、データ接続、権限同期 |
| モデル・クラウド機能 | 長い入力、キャッシュ、セッション、記憶を提供 | Anthropic、OpenAI、Google Cloud | モデル性能、推論費、開発者体験、運用範囲 |
| コンテキスト管理 | 記憶の抽出、圧縮、更新、時間管理を担う | Mem0、Letta、Zep | 記憶精度、矛盾解消、移植性、観測性 |
| 業務アプリ・導入 | CRMや社内知識と結び、仕事を完了させる | Salesforce、Glean、業界特化SaaS | 業務理解、権限、既存顧客、導入支援 |
下の層ほど汎用技術と規模が重要です。上の層ほど、顧客業務とデータの意味が重要になります。中堅企業や新規事業チームは、基盤モデルの性能競争より、業界特化の運用へ近い位置で優位性を作りやすいでしょう。
また、各層は代替関係だけではありません。メモリ専業企業がクラウドへ接続し、業務アプリが検索基盤を使い、導入企業が独自評価を重ねます。参入時は「どの層を自社で持ち、どこを提携するか」を決めます。
大手4社はコンテキストをどう設計しているか
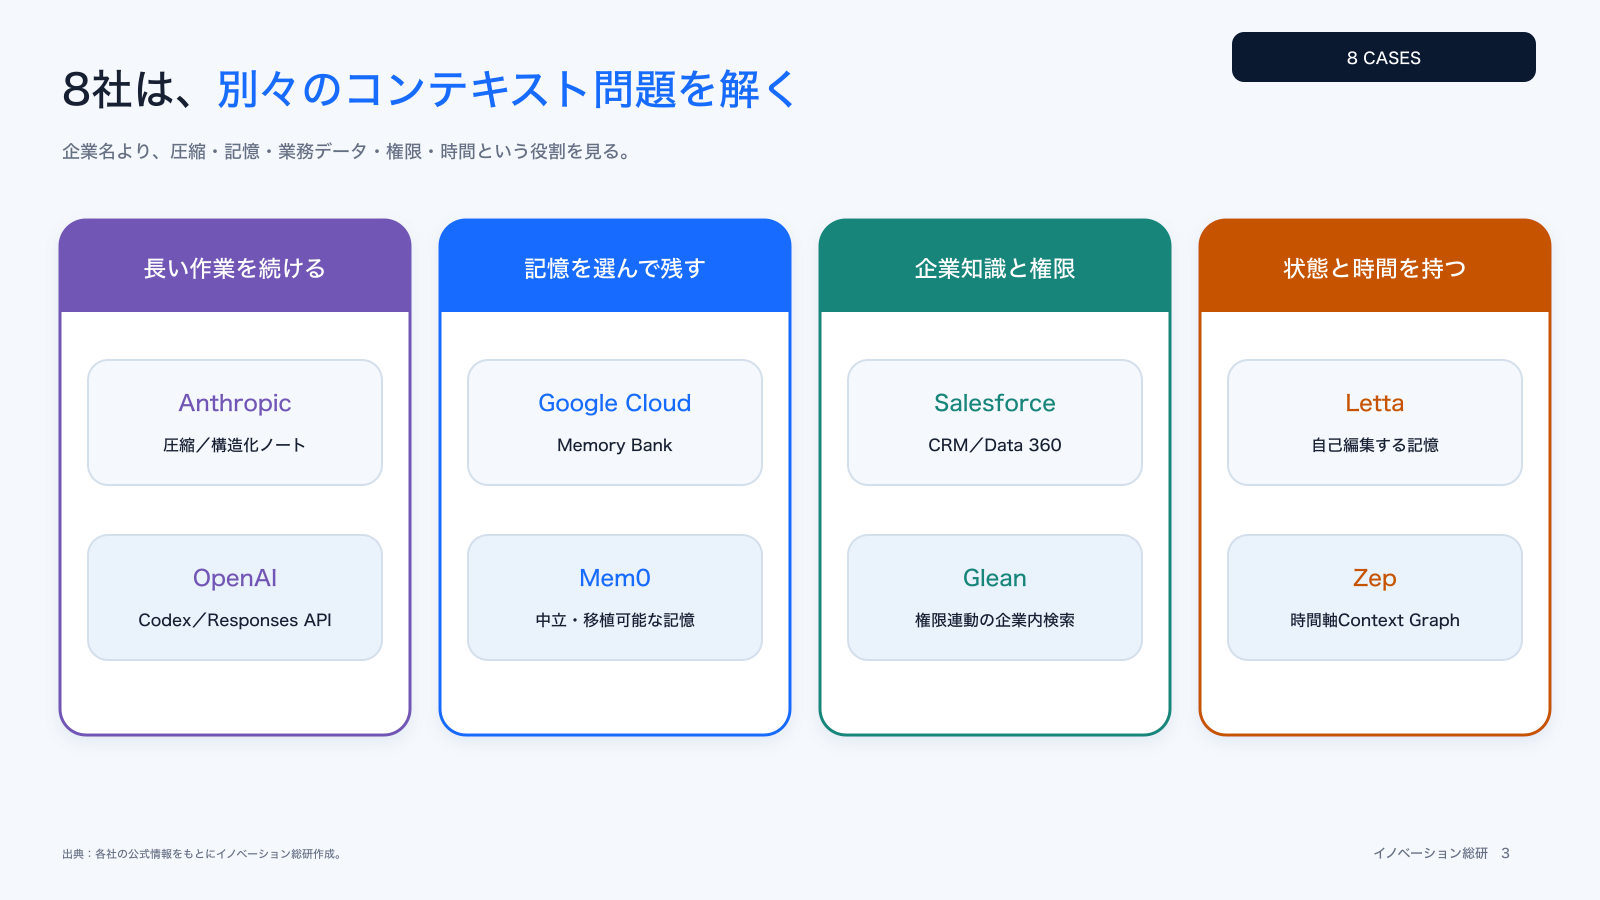
大手企業は、コンテキストを単なる長文入力として扱っていません。長期作業、記憶、業務データ、決定的なルールという異なる課題から設計しています。
Anthropic|少量で重要度の高い情報を選び、長い作業を圧縮する
Anthropicは、コンテキストを有限の注意予算として扱います。公式解説では、指示、ツール、例、外部データ、履歴を必要最小限へ絞る考え方を示しています。
長い作業では、会話を要約して新しいコンテキストへ移す「compaction」、重要な決定を外部ファイルへ残すノート、役割ごとに文脈を分けるサブエージェントを使い分けます。Claude Codeでは、設計判断や未解決の不具合を残し、重複したツール出力を捨てる例が紹介されています。
事業面で参考になるのは、「情報を増やす」より「何を捨てても仕事が続くか」を製品機能にした点です。長期案件を扱う開発支援、調査、法務、運用監視では、圧縮後も判断の根拠が残るかが価値になります。
OpenAI|CodexとResponses APIで長時間の作業状態を引き継ぐ
OpenAIは、長時間動くエージェント向けにコンテキスト圧縮を実装しています。Codexのエージェントループ解説では、会話が一定量を超えると、それまでの入力を小さな項目群へ置き換え、作業を続ける仕組みを説明しています。
さらに、Responses APIには圧縮用の仕組みがあり、Codexは自動で利用します。重要なのは、古いメッセージを単純に削るのではなく、進行中の作業へ必要な状態を引き継ぐことです。
この設計は、ソフトウェア開発以外にも応用できます。数日にわたる監査、調査、顧客案件では、成果物、決定、残課題を構造化して残す必要があります。長い会話ログそのものより、次の担当が仕事を再開できる状態に価値があります。
Google Cloud|Memory Bankで残す記憶の種類と範囲を管理する
Google CloudのVertex AI Agent Engineには、会話をまたぐ記憶を扱うMemory Bankがあります。会話から重要な事実や好みを抽出し、後のやり取りで取得できます。
特徴は、保存する記憶のテーマ、抽出例、保存範囲を設定できる点です。顧客単位、セッション単位など、同じ事実でも共有範囲を分けられます。必要なら有効期限も設定できます。
これは、すべてを記憶する危険を避ける設計です。顧客の希望は残したい一方、古い住所や一時的な相談内容は消す必要があります。企業向けでは、記憶の精度と同時に、削除、範囲、監査を商品要件にする必要があります。
Salesforce|CRM、文書、ツール、業務ルールを一つの設計図にする
SalesforceはAgentforceで、CRMデータ、Data 360、Knowledge記事、文書、Slack、ツール、記憶を組み合わせます。コンテキストエンジニアリングガイドでは、生成AIの柔軟さと、ルールで制御する決定的な処理を組み合わせています。
同社が重視するのは、長い指示文だけで業務を制御しないことです。業務の開始と終了をルールで固定し、中間の対話をAIへ任せます。必要なデータを先に取得し、サブエージェントが使えるアクションも絞ります。
CRMを持つ企業の強みは、顧客データだけではありません。誰がどの情報を見て、どの処理を実行できるかという業務権限を持っています。コンテキスト・エンジニアリングを、既存業務の制御と一体化した例です。
専業4社が作るメモリと企業内コンテキスト
専業企業は、大手クラウドの隙間へ入っています。モデルを作るのではなく、複数モデルへ共通する記憶、時間変化、権限、企業知識を扱う点が特徴です。
Glean|企業内の権限を保ったまま、知識をAIへ渡す
Gleanは、企業内検索とAIエージェントを提供しています。公式サイトでは、社内ツールへ接続し、利用者が閲覧を許可された情報だけを回答やアクションへ使う設計を掲げています。
企業内では、同じ文書でも人によって見える範囲が違います。人事、法務、開発、顧客情報を一つの検索基盤へ集めても、元の権限を壊せません。Gleanは、検索、権限、エージェント作成、問い合わせと操作の観測を一体で扱います。
この例は、企業向けコンテキスト事業の入口が「高精度検索」だけではないことを示します。コネクタの保守、権限同期、監査ログ、管理者の運用まで含めて初めて導入できます。
Mem0|異なるモデルやアプリをまたぐ記憶層を目指す
Mem0は、会話から記憶を抽出し、分類し、時間経過や確信度を踏まえて更新するメモリ基盤です。新しい情報と過去の記憶が矛盾した場合は、その扱いも調整します。
2025年の公式発表によると、同社は41,000件を超えるGitHubスターと1,400万回のPythonパッケージダウンロードを報告しました。2025年第3四半期のAPI呼び出しは1億8,600万回で、AWSの新しいAgent SDKのメモリ提供者にも選ばれたとしています。
同社の戦略は、記憶を特定モデルへ閉じ込めないことです。開発企業がモデルを変更しても、顧客との履歴や好みを持ち運べる中立層を狙います。データ移植性を価値に変える事例です。
Letta|AI自身が記憶を書き換えるステートフルなエージェントを作る
Lettaは、UC Berkeley発のMemGPT研究を土台にしたエージェント基盤です。公式の開発環境紹介では、常に文脈へ置くCore Memoryと、必要なときに探す外部メモリを分けています。
Core MemoryはBlocksと呼ばれる単位で管理され、エージェント自身が追記や置換を行えます。ユーザーの好みや、エージェントの役割など、頻繁に参照する情報を残します。一方、全文書や長い履歴は外へ置きます。
Lettaの示唆は、記憶を後付けの検索機能ではなく、エージェント実行基盤の中核に置くことです。何を記憶し、誰が変更し、変更履歴をどう評価するかまで設計対象になります。
Zep|時間と出典を持つContext Graphで古い事実を無効化する
Zepは、時間軸を持つナレッジグラフGraphitiを中心に、エージェント用の記憶基盤を提供しています。公式ドキュメントでは、会話、業務データ、文書から人物・組織・商品などの関係を抽出し、いつ有効だった事実かを記録します。
たとえば、顧客の契約プランが変更された場合、古い情報を消して終わりにしません。古い契約が有効だった期間と、新しい契約が始まった時点を持ちます。AIは「現在は何か」と「当時は何だったか」を分けて答えられます。
金融、医療、法務、保守など、情報の鮮度と出典が重要な業務では、この時間管理が差になります。似た文書を探すだけのRAGから、変化する業務状態を扱うコンテキストへ広げた例です。
8社の事例から見える勝ち筋
八社の製品は異なりますが、強いコンテキスト基盤には共通点があります。機能の数ではなく、仕事の継続性と改善の仕組みを見ます。
第一は、保存と投入を分けることです。持っているデータをすべてモデルへ渡しません。外部へ保存し、目的に応じて必要な部分だけを読み込みます。長い履歴は要約し、原文へ戻れるようにします。
第二は、時間と出典を持つことです。事実が変わったとき、古い情報と新しい情報を区別します。回答の根拠となった資料と取得時点を残せば、人が確認できます。
第三は、権限を検索後ではなく検索前に適用することです。AIが見てはいけない情報を取得してから隠す設計では、漏えいの危険が残ります。利用者、目的、操作ごとに取得範囲を制御します。
第四は、失敗をコンテキスト改善へ戻すことです。誤回答を見つけたら、プロンプトだけを修正しません。検索の候補、記憶の抽出、ツール説明、圧縮内容のどこで情報が欠けたかを特定します。
第五は、業界固有の型を持つことです。金融の契約、製造の設計変更、医療の診療記録では、正しい情報の単位と更新方法が異なります。汎用基盤へ業界オントロジー、権限、評価セットを重ねると、簡単に置き換えられない資産になります。
コンテキスト・エンジニアリング事業を4つの判断に分ける
参入:特定業務の顧客、データ、評価方法を持つ
一つの仕事へ絞り、記憶、権限、ツール、評価を一体で実装します。
提携:顧客接点はあるが、検索・メモリ技術がない
基盤企業と組み、業界データ定義と導入責任を自社で持ちます。
待機:正解データと更新責任者が決まらない
開発を急がず、失敗分類と評価セットを先に整えます。
見送り:汎用プロンプト集や単純RAGだけで差別化する
顧客固有の更新、権限、実行まで扱えるかを再設計します。
コンテキスト・エンジニアリングで狙える四つの新規事業
新規参入では、汎用のメモリAPIを正面から作るより、自社が持つ業界知識や顧客接点から始める方が現実的です。四つの参入方法を比較します。
| 参入方法 | 主な顧客 | 最初に提供する価値 | 収益モデル | 主な提携先 | 最大の懸念 |
|---|---|---|---|---|---|
| 1. コンテキスト診断・観測基盤 | AIエージェントを運用する企業 | 誤判断時に、使った情報と欠けた情報を追跡 | 月額+評価件数課金 | LLM基盤、監視ツール、SIer | 既存監視製品に吸収される |
| 2. 高規制業界向け記憶・検索基盤 | 金融、製薬、医療、公共、重工 | 時間、出典、権限を保った検索と記憶 | 初期構築+年額利用料 | 業界SaaS、IdP、データ基盤 | 導入が長く個別対応が増える |
| 3. 全社Context Gateway | 複数のAIを使う大企業 | モデルをまたぐ共通ルール、記憶、権限 | 基本料+接続数・利用量課金 | クラウド、SaaS、MCP提供者 | 大手クラウドとの競合 |
| 4. 業界特化エージェント実装 | 特定業務を自動化したい企業 | 対象業務のデータ、ツール、評価を一体化 | 導入費+月額+成果連動 | 業界企業、BPO、専門家 | 受託開発から抜けられない |
自社の強みが「技術」ではなく「顧客業務」にある場合は、四つ目から入り、そこで得た評価データや共通部品を一つ目から三つ目へ広げる順番が現実的です。
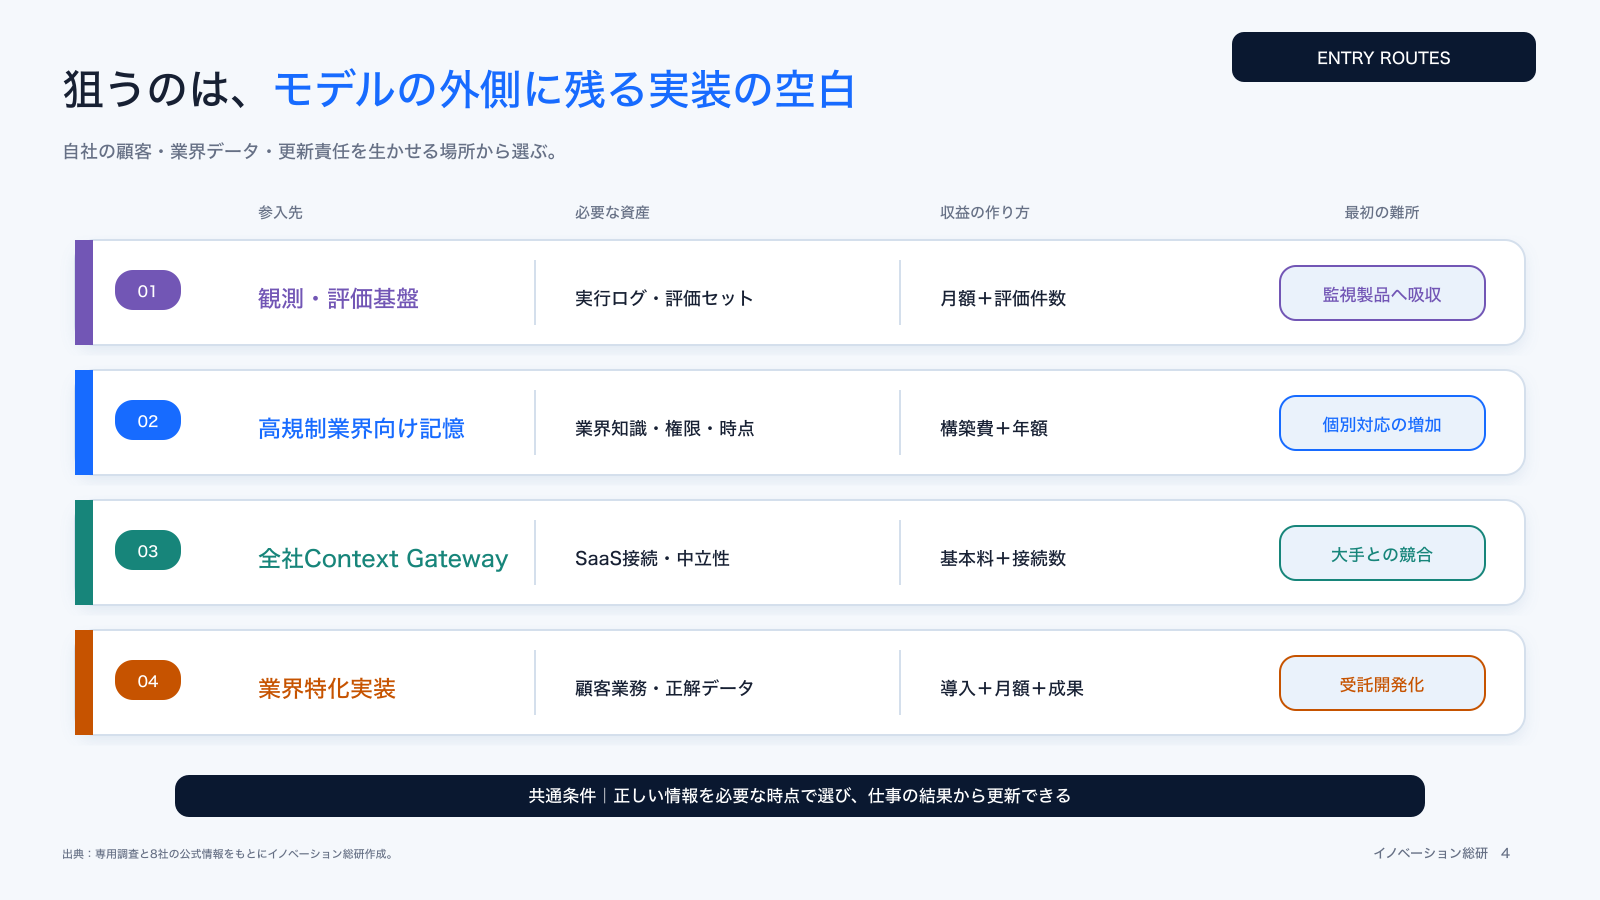
一つ目の観測基盤は、比較的小さく始められます。既存エージェントの実行ログを受け取り、使われた文書、圧縮で消えた情報、選ばれたツールを見える化します。評価データが蓄積すれば、改善提案や自動修正へ広げられます。
二つ目は、参入障壁が高い代わりに、顧客単価を上げやすい事業です。自社が金融、製造、医療などの業務と規制を知っている場合、汎用ツールでは扱いにくい時間・権限・証跡を商品化できます。
三つ目は、社内で増える複数のAIエージェントをつなぐ事業です。顧客情報やプロジェクト状態を共通化しつつ、部署ごとの権限を保ちます。ただし、巨大クラウドが標準機能を広げるため、業界固有の接続や中立性が必要です。
四つ目は、最も顧客価値へ近い入口です。保守受付、見積審査、品質文書作成など、一つの業務を完了させます。受託開発で終わらないよう、共通のデータ定義、評価、コネクタを再利用できる形へ資産化します。
収益モデルは導入費だけにしない
コンテキスト整備は、最初に人手がかかります。文書の棚卸し、権限確認、ツール接続、評価データ作成が必要だからです。導入費だけで売ると、売上が人員数に縛られます。
継続収益へつなぐ単位は、次の四つです。
- 接続するデータ源や業務システムの数
- 管理する利用者、エージェント、記憶の数
- 評価・監査する実行回数
- 削減できた推論費や人の確認工数
ただし、トークン削減額だけの成果報酬は不安定です。モデル提供者が価格を下げれば、顧客価値も下がって見えます。誤回答率、完了率、引き継ぎ率、確認時間など、業務成果と結びます。
また、顧客ごとの個別ルールをそのまま抱えないことが重要です。共通コネクタ、権限テンプレート、評価セット、業界用語辞書へ分け、次の顧客で再利用します。導入作業から、更新され続ける運用資産へ収益源を移せるかが事業性を左右します。
参入前に確認したい六つの懸念
コンテキスト・エンジニアリングは、AIの信頼性を高める一方、新しい事故も生みます。特に次の六つを事業計画へ入れます。
1. 古い記憶が現在の判断を上書きする
顧客の契約や社内規程は変わります。古い情報を単に残すと、AIは過去と現在を混ぜます。有効期間、出典、更新責任者を持ち、矛盾時の優先順位を決めます。
2. 不正な文書が指示として入り込む
外部文書やメールに、AIの指示を変える文章が含まれる場合があります。データと命令を分け、取得した文書から直接ツール実行へ進まない設計が必要です。
3. 検索が権限外の情報を取得する
回答画面で隠しても、モデルへ渡った時点で漏えいリスクが生まれます。元システムの権限を検索前に適用し、記憶へ保存する範囲も分けます。
4. 圧縮で重要な条件が落ちる
長い作業を要約すると、数字、例外、未解決事項が消えることがあります。要約だけでなく、決定ログ、元資料への参照、チェックリストを残します。
5. 推論費と応答時間が膨らむ
コンテキストを増やすほど、入力費と処理時間が増えます。固定情報のキャッシュ、重複文書の除外、段階的な検索、小型モデルとの役割分担で抑えます。
6. 品質責任が複数社へ分散する
モデル、検索、メモリ、業務アプリを別会社から調達すると、障害原因が分かりにくくなります。誰がデータ鮮度、検索精度、ツール実行、最終承認を担うかを契約で分けます。
データと評価を事業の資産にする
コンテキスト事業の競争力は、接続できる文書数ではありません。どの情報を渡せば、どの業務が正しく完了するかを学んだ評価データにあります。
まず、一つの業務について、成功、部分成功、失敗を定義します。顧客対応なら、回答が自然かだけでなく、正しい契約を参照したか、許可された操作か、必要時に人へ引き継いだかを測ります。
次に、失敗を原因別に分けます。指示不足、検索漏れ、古い記憶、ツール選択、権限、圧縮、モデル推論のどこで起きたかを記録します。同じ誤回答でも、直す場所は異なります。
最後に、改善前後を同じ評価セットで比べます。モデルを変更したときも、精度、完了率、費用、時間を比較できます。評価セットが業界固有であるほど、他社が短期間でまねしにくい資産になります。
イノベーション総研がプロジェクト支援で重視しているのも、技術の新しさだけではありません。顧客が採用判断に使う指標と、失敗時に戻る工程を先に決めます。
NEXT STEP
次のステップ
モデルより先に、業務の正解と情報責任を決める。
顧客業務、データ、記憶、権限、ツール、評価のどこを自社で持つかを分け、収益モデルまで設計します。
コンテキスト・エンジニアリングへ参入するかの判断基準
参入判断では、「AIに詳しいか」より「独自の業務文脈を持てるか」を見ます。次の四つに分けると、投資の順番が明確になります。
| 判断 | 当てはまる状態 | 次の行動 |
|---|---|---|
| 参入 | 特定業務の顧客、データ、評価方法を持つ | 一業務へ絞り、記憶・権限・ツールを一体で実装する |
| 提携 | 顧客接点はあるが、検索・メモリ技術がない | 基盤企業と組み、業界データ定義と導入を自社で持つ |
| 待機 | 課題はあるが、正解データと責任者がいない | 業務記録を整え、失敗分類と評価セットを先に作る |
| 見送り | 汎用プロンプト集や単純RAGだけで差別化する | 顧客固有の更新・権限・実行まで扱えるか再設計する |
参入しやすいのは、既存の顧客基盤と業務データを持つ企業です。業界SaaS、BPO、保守会社、SIer、専門情報会社は、現場の例外と責任分担を知っています。モデル企業と同じ土俵へ上がる必要はありません。
一方、独自データを持たず、顧客業務へも入れない場合、汎用ツールの再販売になりやすくなります。提携で顧客接点を作るか、対象業務を狭くする必要があります。
事業構想を相談する前に整理したいこと
相談の前に、技術一覧より業務の失敗場面を整理すると、議論が速くなります。次の五つを一枚にまとめます。
- AIへ任せたい仕事と、人が承認する仕事
- 現在、担当者が探している資料とシステム
- 情報が古い、見つからない、権限が曖昧になる場面
- 正しく完了したと判断できる指標
- 自社で持つ層と、外部へ任せる層
私たちイノベーション総研では、モデル比較だけでなく、顧客課題、データ、業務責任、収益モデルをつなぎます。実装前に、参入、提携、待機、見送りの条件を分けることで、不要な開発を減らします。
顧客や業務を再現するカスタマーデジタルツインを検討している場合も、同じ整理が必要です。どのデータを現在の状態として扱い、誰にどこまで見せるかが、実装の前提になります。
コンテキスト・エンジニアリングのよくある質問
導入や新規事業を検討するときに出やすい五つの疑問へ、要点だけ答えます。
まとめ|コンテキスト・エンジニアリングはAIの業務環境を作る
コンテキスト・エンジニアリングは、AIへ長い資料を渡す技術ではありません。目的に必要な情報を選び、権限を確かめ、仕事の進行に合わせて更新し、失敗から改善する仕組みです。
AnthropicとOpenAIは長い作業の圧縮、Google CloudとLettaは記憶、SalesforceとGleanは業務データと権限、Mem0はモデルをまたぐ記憶、Zepは時間変化を扱っています。八社の違いは、そのまま市場の役割分担を示しています。
新規事業では、汎用基盤を正面から作るより、特定業界のデータ、権限、評価、業務実装へ入る方が勝ち筋を作りやすいでしょう。観測基盤、高規制業界向け記憶、全社Context Gateway、業界特化実装のどこを狙うかを決めます。
大切なのは、AIが知っている量ではありません。必要なときに、正しい情報を、許された範囲で使い、仕事を完了できるかです。
CONTACT
お問い合わせ
コンテキスト・エンジニアリングを、技術導入で終わらせない。
対象業務、独自データ、更新責任、アクセス権、評価方法、収益モデルを整理し、参入・提携・待機・見送りの条件へ落とします。


