
投稿日:2026.09.06 最終更新日:2026.10.09
AI for Scienceが研究開発を変える|国内外8事例と新規事業の勝ち筋
AI for Scienceは、AIが答えを出す話ではない。
予測と実験をつなぎ、次の発見を速くする。
結論は、予測を実験で確かめ、研究判断まで支援できるかを確認することです。国内外8事例と4つの参入方法から、新規事業の入口を整理します。
この記事の結論
AI for Scienceの事業性は、予測の精度だけでなく、実験で確認できた成果と、そのための期間・総費用を合わせて評価します。
- AI for Scienceの意味と、予測から実験へつなぐ研究開発サイクルを解説します。
- 国内外8事例を、基盤モデル、分野別設計、現場統合、自律・遠隔実験の役割から読み解きます。
- 4つの参入方法と収益モデル、再現性、データ、知財への懸念を示します。
AI for Scienceは、科学研究の一部にAIを使うだけの取り組みではありません。むしろ、文献を探し、仮説を立て、候補を設計し、実験し、得られたデータから次の実験を決めるという研究の循環そのものを速く、広く、再現しやすくする考え方です。
注目を集めるきっかけになったのは、タンパク質の立体構造を予測するAlphaFoldです。そして現在は、創薬に加え、新材料、触媒、電池、気象、核融合などへ対象が広がりました。
さらに、AIが候補を出すだけでなく、ロボットが実験し、その結果をAIへ戻す自律実験も始まっています。
ただし、優れたAIモデルを導入すれば研究開発が変わるわけではありません。研究データの整備、実験機器との接続、予測の検証、知財の帰属までを一つの仕組みにする必要があります。
例えば、自律実験設備A-Labの論文は、2026年の訂正を反映すると17日間で57候補のうち36化合物を合成した結果を示しています。ただし、全てが世界初の物質という意味ではありません。
国内外8事例を、予測・実験・契約のどこまで進んだかで読み分け、自社が支援できる工程と採算の確認方法を整理します。
結論は、AIの候補数ではなく、検証できた成果と総費用を比べることです。
目次
AI for Scienceとは何か
AI for Scienceとは、機械学習や生成AIを使い、科学研究の発見速度と探索範囲を広げる取り組みです。日本語では「科学のためのAI」などと表現されます。
対象になるのは、研究者の文章作成だけではありません。科学データを学ぶ専用モデル、シミュレーションの高速化、実験条件の提案、ロボットによる実験、測定結果の解析まで含みます。
| 研究工程 | 従来の進め方 | AI for Scienceで変わること |
|---|---|---|
| 文献・知識探索 | 研究者が論文を読み、整理する | 論文、特許、実験記録を横断して関係を探す |
| 仮説・候補設計 | 経験と既知の理論から候補を絞る | 広い候補空間から有望な分子や材料を提案する |
| 計算・シミュレーション | 高精度だが時間のかかる計算を回す | AIの近似モデルで計算を大幅に速める |
| 実験計画 | 研究者が次の条件を決める | 結果を見ながら、情報量の多い次の実験を選ぶ |
| 実験・測定 | 人が機器を操作し、記録する | ロボットや自動機器が条件を変えながら実行する |
| 評価・再学習 | 結果を個別に解釈する | 成功と失敗を学習し、次の候補へ反映する |
重要なのは、AIが研究者を置き換えるかどうかではありません。研究者が問いを決め、AIが探索を広げ、実験が真偽を確かめるという役割分担です。
生成AIとの違いは、科学の制約と実験にある
一般的な生成AIは、文章、画像、音声など、人が作った大量のデータからパターンを学びます。AI for Scienceも生成技術を使いますが、正しさの基準が異なります。
科学では、もっともらしい答えでは足りません。具体的には、原子の配置、保存則、生体分子の相互作用など、既知の法則と矛盾しないことが必要です。
そのため、最後は計算や実験で確かめます。
| 比較点 | 一般的な生成AI | AI for Science |
|---|---|---|
| 主な入力 | 文章、画像、音声 | 分子構造、実験値、測定波形、シミュレーション |
| 正しさの基準 | 内容が正確で、目的や評価基準に合うか | 法則と整合し、実験で再現できるか |
| データ量 | インターネット規模 | 少量で高価、条件がそろわないことが多い |
| 出力 | 文章や画像 | 候補物質、物性、実験条件、予測値 |
| 最終確認 | 人の評価 | 計算、測定、実験、人の専門判断 |
AIエージェントの新規事業で扱う仕組みは、複数のツールを選び、作業を順番に進めます。AI for Scienceでは、そこに科学専用モデル、計算資源、実験機器、安全ルールが加わります。
文章作成や文献整理も研究支援の一部です。ただし、材料や創薬の候補を評価する場合は、文章の自然さに加えて、科学データと実験で確かめる仕組みが必要です。
生成AIとAI for Scienceは対立する分類ではなく、用途と検証方法が異なります。
AI for Scienceが変える研究開発の流れ
AI for Scienceの価値は、単発の予測ではなく、研究の循環にあります。仮説から実験までを一方向に進めるのではなく、結果を次の設計へすぐ戻します。
代表的な流れは、次の五段階です。
- 目的を決める:必要な薬効、耐熱性、触媒性能などを定義する
- 候補を作る:AIが分子、結晶、実験条件を生成する
- 絞り込む:物理計算や既知データで実現性を評価する
- 実験する:研究者または自動設備が合成・測定する
- 学び直す:成功と失敗をモデルへ戻し、次の候補を選ぶ
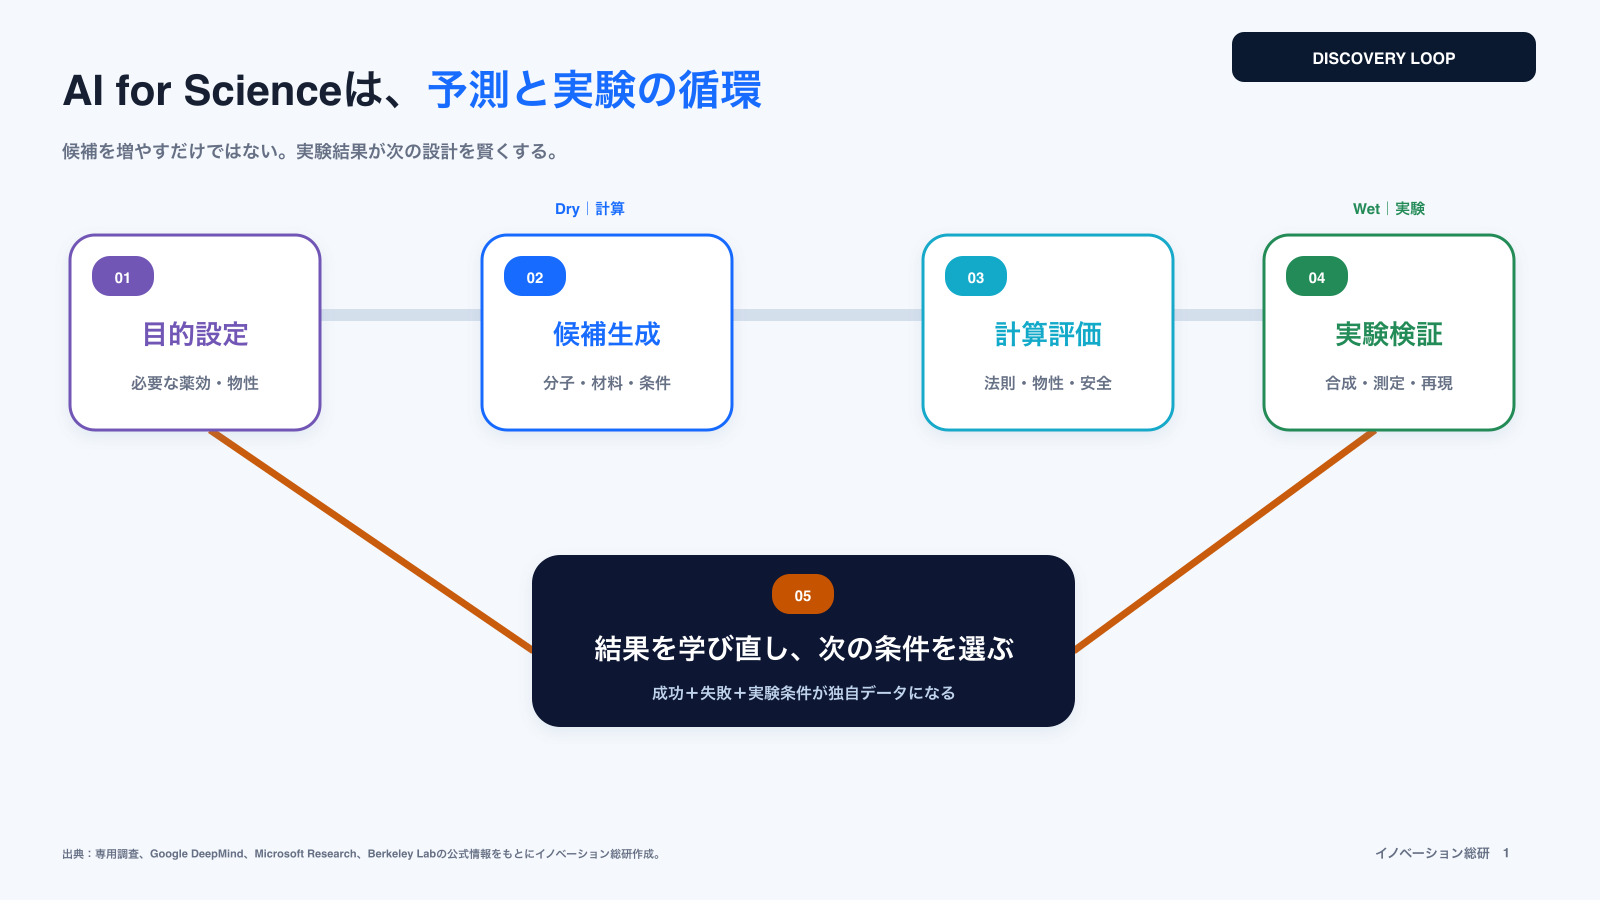
この循環は「Dry-Wet-Dry」とも呼ばれます。ここでいうDryは計算機上の設計や予測、Wetは実験室での合成や測定です。
というのも、計算だけでは作れるか分からず、実験だけでは探索できる範囲が狭いからです。そのため、両者を短い間隔で回すことに意味があります。
自律実験ラボは、フィジカルAIの事業機会とも重なります。ただし、科学実験では速く動くことより、条件、試薬、測定方法、失敗理由を正確に記録し、再現できることが重視されます。
AI for Scienceの市場はどう広がるか
AI for Scienceには、統一された市場定義がまだありません。創薬AI、材料インフォマティクス、科学計算基盤、実験自動化をどこまで含めるかで数字が変わります。
そのため、一つの市場規模だけで事業性を判断するのは危険です。
市場推計は、何への支出を集計したかを確認して使います。Datainteloの2026年9月19日更新の公開概要は、科学研究で使うAIソフトウェア、計算資源、研究・統合サービスを対象としています。
一方、Market.usの2025年11月公開概要は、材料探索へのAI利用を対象にしています。
| 調査対象 | 基準年の推計 | 2034年予測 | 読み方 |
|---|---|---|---|
| 科学研究で使うAI(Dataintelo) | 2025年:85億米ドル | 349億米ドル | 一般企業向けAIや臨床ケアAI等を除く同社の定義 |
| 材料探索向けAI(Market.us) | 2024年:約5.36億米ドル | 約55.84億米ドル | 電池・半導体・ポリマー等の材料探索用途 |
上表は調査会社の公開概要に記載された推計・予測で、全産業に共通する公式統計ではありません。対象の重なりと基準年が異なるため合算せず、将来値を確定した顧客予算として扱わないことが重要です。
事業会社は、市場予測より次の四つを見た方が実態をつかめます。
- 顧客の研究開発費のうち、計算・実験・外注へ使われている金額
- 一つの候補を設計し、実験で確かめるまでの日数と費用
- AIが提案した候補のうち、実験へ進み、再現できた割合
- 同じ設備とデータを、複数の研究テーマで使い回せる割合
政策面では、JSTのARiSEが重点領域への集中投資と国際連携を進めています。文部科学省のSPReADは、2026年の2回の公募を通じて計1,000件程度の採択を予定し、計算資源、データ取得・利用、ロボット設備等を支援対象にしました。
第1回は6月22日、第2回は8月18日に採択課題を公表しています。1,000件は計画上の規模であり、有料サービスの購入件数ではありません。
AI for Scienceの産業構造を四層で見る
業界は、AIモデルを開発する企業だけで成り立ちません。以下は当研究所による役割の整理です。
計算基盤、科学モデル、分野別の業務基盤、実験・検証へ分けます。企業が複数の役割を担う場合もあります。
| 層 | 提供するもの | 主なプレーヤー例 | 競争力になるもの |
|---|---|---|---|
| 計算・データ基盤 | GPU、HPC、クラウド、科学データ | NVIDIA、AWS、Microsoft、理研、産総研 | 計算単価、機密性、データへの接続 |
| 科学基盤モデル | 分子、材料、生物、気象の予測・生成 | Google DeepMind、Microsoft Research、Matlantis | 精度、速度、対象範囲、説明可能性 |
| 分野別プラットフォーム | 創薬・材料などの研究工程を管理 | Isomorphic Labs、Recursion、Schrödinger | 顧客業務への統合、独自データ、知財 |
| 実験・検証基盤 | 自動合成、測定、クラウドラボ | Berkeley Lab、Emerald Cloud Lab、a.s.ist | 再現性、稼働率、対応できる実験種類 |
計算基盤には計算設備への投資、科学モデルには専門データと開発、実験基盤には装置・試料・運用への投資が必要です。表の上下で必要資本を一律に順位付けせず、自社で保有するものと、外部から借りるものを分けます。
例えば、特定材料の実験手順、既存分析機器との接続、品質保証文書の作成は、導入先ごとに確認したい課題です。未参入の市場と決めつけず、既存サービスで解決できない作業と、顧客の支払意思を調べます。
量子コンピュータも将来の科学計算基盤として注目されます。ただし、足元の事業では、既存のGPUやHPCで解ける課題と、量子計算が必要な課題を分けることが必要です。
国内で進むAI for Scienceの3事例
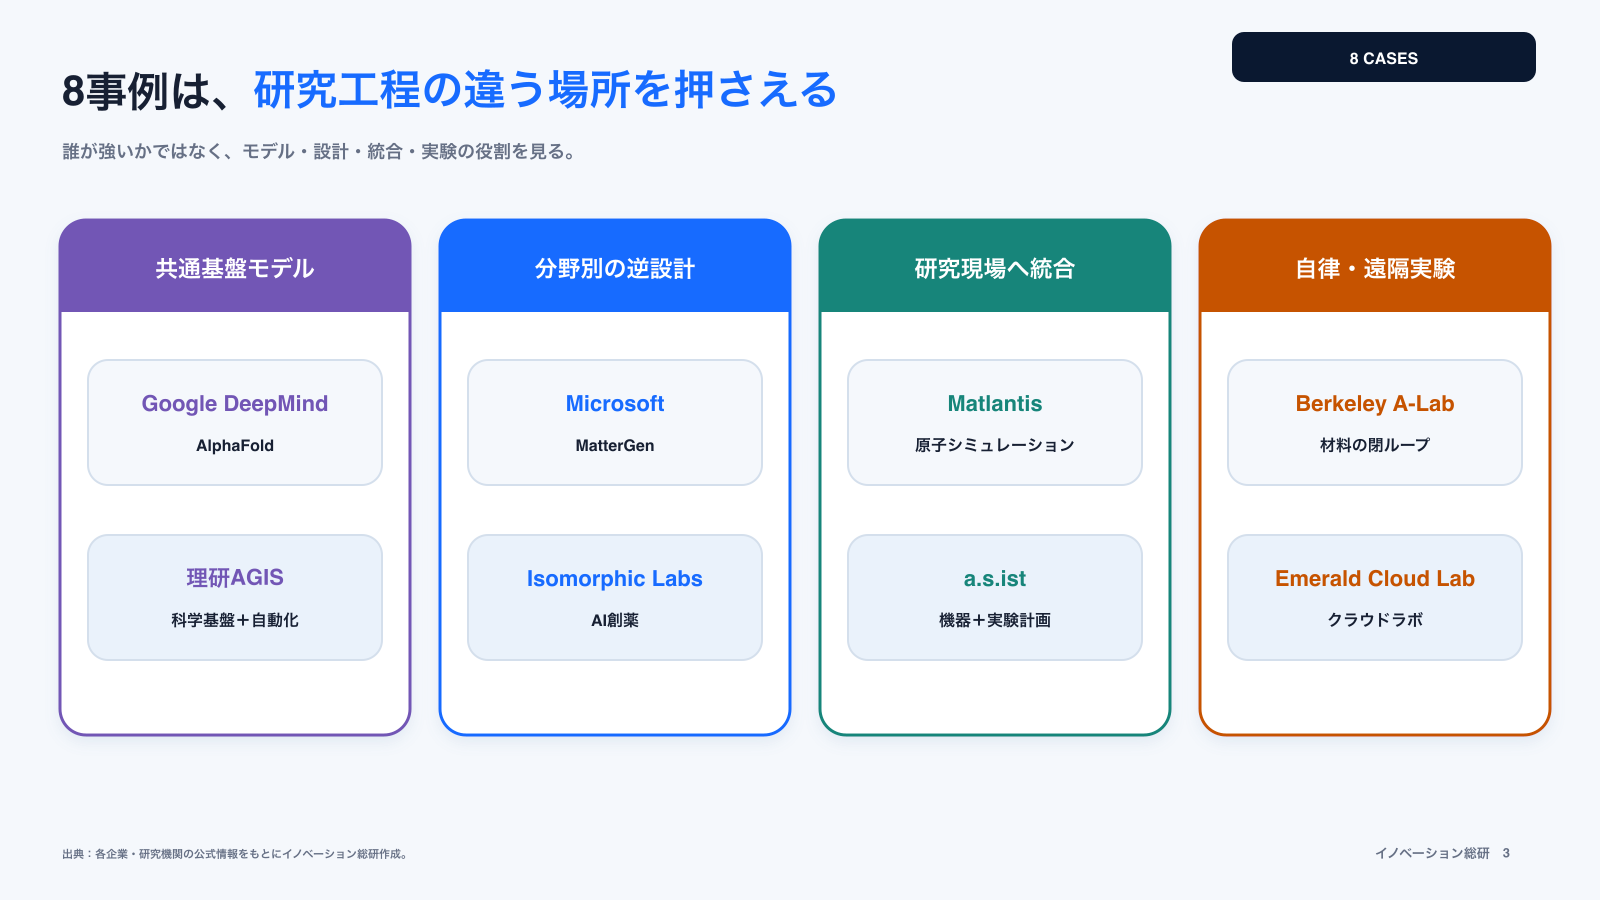
国内では、材料科学と研究基盤を中心に実装が進んでいます。以下では、共通基盤を開発する理研、計算サービスを提供するMatlantis、装置と解析をつなぐa.s.istを取り上げます。
研究計画と提供中のサービスを分けて見ます。
理化学研究所AGIS|基盤モデルと実験自動化を共通基盤にする
理化学研究所の科学研究基盤モデル開発プログラム(AGIS)は、生命・医科学、材料科学、共通基盤、計算基盤を横断する取り組みです。科学データを学習する基盤モデルとAIエージェントを開発し、実験自動化やシミュレーションと組み合わせます。
特徴は、特定の研究室向けツールで終わらせず、理研の計算設備と実験設備をつなぐ点です。開発したモデルと利用技術を産学へ開放する方針も示しています。
企業側が確認したいのは、利用できるモデル・データ・設備と、その開放時期・条件です。装置連携やデータ整備などの周辺サービスは検討できますが、AGISの方針だけで共通仕様が完成したことや商用需要が確定したことまでは判断できません。
Matlantis|原子レベルの計算を高速化し、材料探索を日常業務へ入れる
Matlantisは、Preferred NetworksとENEOSが共同で育てた汎用原子シミュレーターです。中核モデルのPFPは、原子の動きとエネルギーを予測します。
PFPの公式説明は、高精度の量子計算である密度汎関数理論(DFT)の結果をAIで近似して計算を速める仕組みを示しています。2024年9月17日公開のv7では96元素へ対応を広げました。
これは対象元素の数であり、全ての組成・温度・圧力で精度を保証する値ではありません。導入では、自社の材料条件で計算と実測の差を確認します。
従来、原子レベルの高精度計算は時間がかかり、候補を大量に試せませんでした。そこでMatlantisは、実験前に条件を絞り込み、研究者が有望な候補へ時間を使えるようにします。
また、技術をSaaS(インターネット経由で使うソフト)として提供し、計算環境の構築を顧客側へ求めない点も事業化の参考になります。
a.s.ist|研究設備と解析・実験計画をつなぐ
a.s.istは、材料・化学分野で、合成、計測、データ解析、次の実験計画をつなぐ自立型材料開発システムを開発しています。自動スペクトル解析や、ベイズ推論を使った最適実験計画も提供します。
ここで重要なのは、AIモデルだけを売っていないことです。研究室ごとに異なる装置や手順へ合わせ、現場で動くシステムとして実装します。
自社の研究所で、ネットワークにつながらない機器や表計算ファイルに分散した記録がある場合は、まず装置1台・測定工程1つで接続可能性を確認します。これは当研究所からの導入案であり、a.s.istがあらゆる旧式設備へ対応した実績を示すものではありません。
海外で進むAI for Scienceの5事例
海外では、巨大IT企業の科学モデル、創薬企業の垂直統合、自律実験ラボのサービス化が並行して進んでいます。各社が「どの研究工程を押さえているか」に注目します。
Google DeepMind|AlphaFoldを研究の共通基盤にした
Google DeepMindのAlphaFoldは、アミノ酸配列などからタンパク質の立体構造を予測します。公式案内の2億件超は、公開データベースに収めた予測構造の数です。
実験で確定した構造や、薬効を確認した候補の数ではありません。
AlphaFold 3は、タンパク質だけでなく、DNA、RNA、低分子などの相互作用へ対象を広げました。研究者は、すべてを実験で解く前に、どの構造や相互作用を優先して確かめるか考えやすくなりました。
利用を検討する際は、データベース、AlphaFold Server、モデルのコード・重みを分けて条件を確認します。特にAlphaFold Serverの規約は非商用利用を対象とし、営利組織のための研究を含む商用活動への利用を制限しています。
「無料で公開されているから、自社の有料サービスへ自由に使える」とは判断せず、用途ごとに確認します。
Microsoft Research|MatterGenで欲しい物性から材料を設計する
Microsoft ResearchのMatterGenは、必要な性質を指定し、新しい無機結晶を生成するモデルです。既存の材料一覧から探すのではなく、「硬さ」「磁性」などの条件から候補を作ります。
Microsoftの2025年1月16日の説明では、中国科学院深圳先進技術研究院との検証でTaCr2O6を合成し、体積弾性率を測定しました。圧縮されにくさを表すこの値は、設計時の指定が200GPa、実測が169GPaで、相対誤差は20%未満でした。
1物質の実証であり、あらゆる候補が同じ誤差で作れることや量産採用を示す結果ではありません。
この事例から分かるのは、候補生成、実験での検証、量産での検証を分ける必要があるだということです。合成できるか、測定値が出るか、量産条件で成立するかを確かめます。
Isomorphic Labs|AI創薬を製薬会社との共同開発へつなぐ
Isomorphic Labsは、Google DeepMindの研究成果を使い、医薬品設計へ取り組む企業です。自社のDrug Design Engineを使い、難しい標的に対する低分子や生物製剤の候補を設計します。
同社の提携情報では、Novartis、Eli Lilly、Johnson & Johnsonとの共同研究を示しています。Novartisとの提携では、当初の三つの標的に最大三つの研究プログラムを追加しました。
契約の具体例は2024年1月7日の発表です。契約時の支払いとしてLillyは4,500万米ドル、Novartisは3,750万米ドルを示し、開発の進展に応じた支払いを組み合わせています。
二つの提携を合わせた約30億米ドルという潜在的な契約価値は、将来の条件付き支払いを含む金額で、実現売上ではありません。共同研究契約を結んだことと、治験・承認に成功したことも分けます。
Berkeley LabのA-Lab|AIの提案をロボットが合成し、結果を学び直す
米ローレンス・バークレー国立研究所のA-Labは、無機材料を自動で合成する研究設備です。計算データと論文から合成方法を考え、ロボットが粉末の計量、混合、加熱、X線回折による測定を行います。
Nature論文の訂正後の結果は、17日間で57候補のうち36化合物を合成した結果を示しています。2026年1月19日の訂正では、4件の判定を不確定とし、訓練データに混入した1候補を除外しました。
また、新規とは原則として同システムに未学習という意味で、全てが世界初の物質ではないと明確化しています。
参考になるのは、実験結果から次の条件を選ぶ仕組みと、後から判定を見直せる記録です。予測した数、合成を確認した数、製品に採用できる数は分けて数えます。
研究成果を事業へ使う際は、判定方法とデータの版を残し、純度・性能・製造条件の確認へつなげます。
Emerald Cloud Lab|実験設備をクラウドサービスにする
Emerald Cloud Labは、研究者が遠隔から実験を設計し、クラウド上のラボ設備で実行できるサービスです。試料調製、機器操作、測定、解析までをソフトウェアから指示できます。
公式案内では200種類超の機器モデルを共通画面から利用でき、自動化された工程に加え、人が行う手順もソフトウェアで管理するとしています。遠隔操作できることと、現地作業が全て無人であることは別です。
導入側は、自前の設備費と利用料に加え、試料輸送、予約待ち、対応外の手順も比較します。
ただし、すべての実験を遠隔化できるわけではありません。たとえば、特殊な試料、現場の感覚が必要な操作、搬送できない材料には制約があります。
そのため、対象実験を絞り、標準化率を上げることが採算の鍵です。
8事例から整理するAI for Scienceの事業化条件
八つの事例は扱う分野も規模も異なります。以下は事例を参考にした当研究所の確認事項です。
8事例が全て同じ条件で収益化に成功したことを示す比較ではありません。
第一は、モデルの精度だけでなく、実験で確かめた実績を持つことです。実際、MatterGenとA-Labは、候補を生成しただけでなく、合成と測定まで行いました。
予測ツールを売る場合も、顧客が何を判断できるようになるかを確認します。
第二は、独自データが増える循環です。というのも、論文や公開データは競合も使えるからです。
そのため、実験の成功だけでなく、合成できなかった条件、測定の異常、再現しなかった結果を蓄積できると、次の予測を改善するための材料になります。改善したかは、学習に使っていない条件で検証します。
第三は、研究者の既存業務へ入ることです。たとえば、Matlantisは複雑な計算環境をSaaS化し、a.s.istは分析機器と実験計画をつなぎます。
つまり、研究者に新しい画面を増やすより、電子実験ノート、実験機器、計算環境との接続も含め、研究者の作業が増えないかを確認します。
第四は、無料・共通基盤と有料・専用用途を分けることです。たとえば、AlphaFoldには研究利用の基盤があり、Isomorphic Labsは製薬企業と共同研究契約を結んでいます。
つまり、モデルを公開するか閉じるかという二択ではなく、普及させる層と収益化する層を分けます。
第五は、人の判断を残す場所が明確なことです。具体的には、研究目的、安全性、実験の中止、候補の採否、特許出願は、人が責任を持ちます。
そのため、すべてを自律化するより、判断の根拠と履歴を残し、導入先の承認条件に応えます。
AI for Science事業を4つの判断に分ける
参入:独自データ、実験設備、産業顧客を持つ
既存資産が生きる研究工程を一つに絞り、検証済みデータが増える循環を作ります。
提携:AIはあるが、科学人材や実験環境がない
大学、研究機関、受託分析会社と組み、評価方法と知財の帰属を決めます。
待機:課題はあるが、性能の評価方法が決まらない
モデル開発を急がず、顧客が採用判断に使う指標とデータを先に定義します。
見送り:汎用モデルだけで差別化しようとしている
独自データ、実験接続、業務責任のいずれも持てない場合は、参入方法を再設計します。
AI for Scienceで狙える4つの新規事業
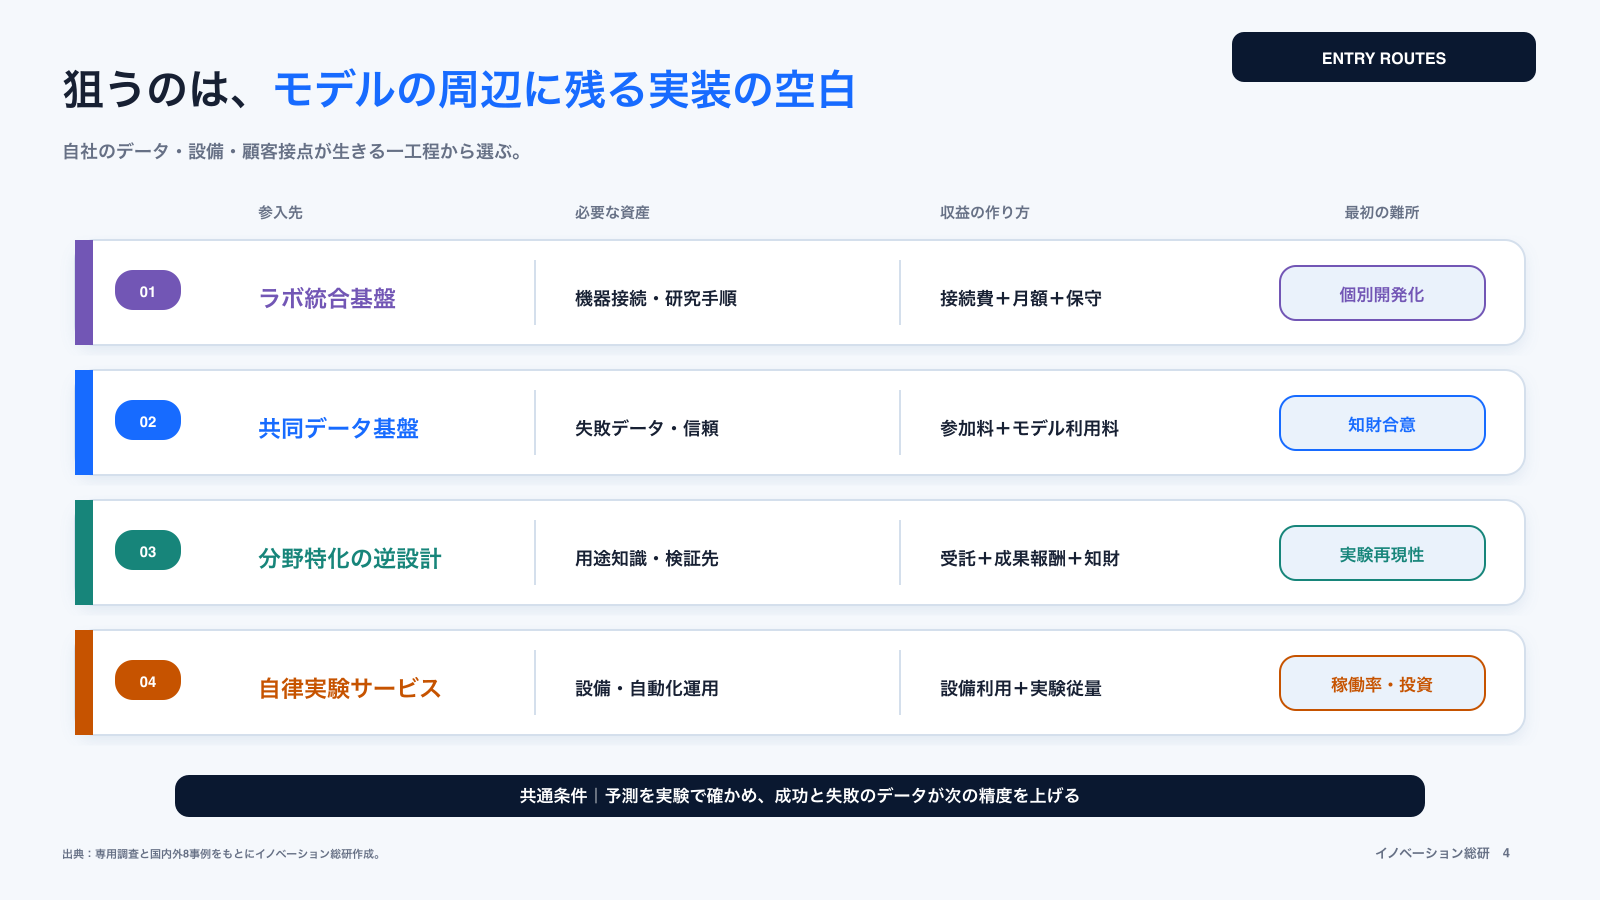
新規参入では、巨大な科学基盤モデルを一から作る必要はありません。以下は当研究所の参入案です。
自社が持つ装置、顧客、データ、研究人材を使える工程から、需要と提供費用を確かめます。
1. 研究機器とAIをつなぐラボ統合基盤
古い分析機器、電子実験ノート、表計算ファイル、AIモデルをつなぎます。機器ごとのデータ形式をそろえ、実験条件と結果を自動で記録し、次の実験へ渡すミドルウェアです。
顧客は、製薬、化学、食品、電池、半導体の研究所です。そして収益は、初期接続費、設備ごとの月額料、保守料で作れます。
強みになるのは、AI技術より、機器仕様と研究手順を理解して動かす力です。
2. 失敗データを安全に学ぶ共同データ基盤
企業内に眠る「効かなかった化合物」「合成できなかった条件」「測定に失敗した波形」を、社外へ生データを出さずに共同学習へ使います。秘密計算、連合学習、データクリーンルームなどを候補にします。
ただし、モデルや集計結果からの情報漏えいリスクは別に評価し、これらの技術だけで秘密保持が完了したとは扱いません。
顧客は、同じ研究課題を持つ複数企業や業界団体です。そして、参加料、モデル利用料、データ整備支援が収益になります。
ただし、最大の難所は技術ではなく、知財、競争法、データ品質、成果配分の合意です。
3. 特定材料に絞った逆設計・検証サービス
全材料を対象にせず、電池電解質、熱伝導材、触媒、半導体薬液など、一つの用途へ絞ります。必要物性から候補を生成し、計算評価、外部実験、量産条件の初期確認まで提供します。
月額ソフトだけでなく、候補探索の受託料、共同特許、採用時の成功報酬を組み合わせます。材料分野は、全固体電池やペロブスカイト太陽電池のように、材料性能が製品競争力へ直結する領域と相性があります。
4. 自律実験ラボ・アズ・ア・サービス
自動合成、測定、解析を備えた設備を保有し、顧客の依頼を遠隔で実行します。顧客は高価な設備を買わず、実験単位で利用できます。
収益は、設備利用料、実験回数課金、優先枠、共同開発契約で作ります。ただし、設備投資が大きいため、最初は扱う試料、容器、測定方法を限定します。
さらに、夜間稼働や複数顧客で設備を共用し、稼働率を高める必要があります。
AI for Science事業の収益モデルをどう作るか
AI for Scienceは、ソフトウェアの月額課金だけでは採算が合わない場合があります。高価な計算、専門家の支援、実験設備が必要だからです。
そのため、提供価値と負担するリスクに合わせ、収益源を組み合わせます。
| 収益モデル | 顧客が払う対象 | 向く事業 | 主な懸念 |
|---|---|---|---|
| 月額・年額利用料 | モデル、画面、データ管理 | ラボ統合、計算SaaS | 利用頻度が低いと解約される |
| 計算・実験の従量課金 | GPU時間、実験回数、試料数 | クラウドラボ、解析API | 原価変動が大きい |
| 導入・検証支援 | データ整備、機器接続、評価設計 | 企業研究所への導入 | 人月商売になりやすい |
| 成果報酬 | 候補発見、性能達成、開発進展 | 創薬、材料共同開発 | 売上まで長く、不確実性が高い |
| 知財・ロイヤルティ | 特許持分、製品売上 | 独自材料・医薬品 | 権利関係が複雑になる |
料金設計では、導入費と利用料で回収する費用、成果が出たときに回収する費用を分けます。契約件数や継続利用がなければ固定収入にはならないため、検証・保守の人件費も含めて見積もります。
価格の基準は「AIを何回使ったか」ではありません。候補選定までの期間、削減した実験数、設備の稼働率、再現できた候補数など、研究判断の改善へ置きます。
架空例:実験を40回から24回へ減らしても、採算は改善するか
次は、同じ期間・性能条件で材料候補を比較する説明用の架空例です。実験1回3万円、従来の準備・評価費60万円とし、AI利用では計算・データ整備・検証を加えて84万円かかると仮定します。
実際の料金相場や導入効果ではありません。
| 項目 | 従来方式 | AIを使う方式 |
|---|---|---|
| 実施する実験 | 40回 | 24回 |
| 実験費 | 120万円 | 72万円 |
| 準備・評価等の費用 | 60万円 | 84万円 |
| 合計費用 | 180万円 | 156万円 |
| 採用可能な候補数 | 4件 | 3件 |
| 採用可能な候補1件当たり | 45万円 | 52万円 |
実験回数が減っても、採用できる候補1件の費用が下がるとは限りません。この例では実験が40%減り総費用も24万円減りますが、採用可能な候補1件の費用は45万円から52万円へ増えます。
判定基準を同じにし、不合格・判定待ちの費用も含めると、追加データの価値や期間短縮を加味して続けるか判断できます。
AI for Science導入で起きやすい6つの懸念
AI for Scienceは期待が大きい分、予測を過信すると研究費を浪費します。導入前に、技術、運用、収益の失敗条件を整理します。
1. 予測精度が高くても、実験で再現しない
たとえば、学習データと異なる材料、温度、設備では精度が落ちます。そのため、論文上の評価値と、自社の試料での再現率を分けます。
そして採用前に、未知条件を含む外部検証を行います。
2. 成功データだけを学び、同じ失敗を繰り返す
論文には成功が残りやすく、失敗条件は記録されにくい傾向があります。失敗を「役に立たないデータ」として捨てず、理由と条件をそろえて残します。
3. データ整備と機器接続の費用が膨らむ
実験記録の名称、単位、測定条件が研究室ごとに違うと、AIへ渡せません。モデル導入より前に、対象工程を絞り、最低限のデータ辞書と接続仕様を決めます。
4. 計算費と実験費を減らせない
AIが候補を大量に出すほど、確認実験が増えることがあります。そのため、候補数ではなく、有望候補一件を再現するまでの総費用で評価します。
また、AIが使う計算資源も原価に含めます。
5. 研究者に使われず、PoCで止まる
研究者は、自分の判断根拠を説明できない提案を採用しにくいものです。そのため、AIの結論だけでなく、参照データ、信頼度、除外理由を示します。
さらに、研究者を承認者として最後に置くのではなく、設計段階から参加してもらいます。
6. 安全性と責任主体が曖昧になる
危険な化合物、病原体、反応条件をAIが提案する可能性があります。そのため、禁止対象、実行権限、停止条件、人による承認を決めます。
特に、自律化の範囲が広いほど、誰が実験を止めるかを明確にします。
研究データと知財をどう守るか
研究データは、AI for Scienceの燃料であると同時に、企業の競争力そのものです。外部サービスへ入力した時点で、秘密情報、共同研究契約、輸出管理、個人情報に触れる可能性があります。
以下は当研究所が提案する確認事項です。適用法令や契約上の判断は、データ・用途に応じて法務や専門家へ確認します。
- 入力データをサービス提供者が再学習に使えるか
- 生成した候補と、改良モデルの権利を誰が持つか
- 共同研究先のデータを混ぜる場合、誰が許可するか
- 実験ログとモデルの版を、どの期間保存するか
- 危険用途や輸出管理対象を、どこで止めるか
知財では、「AIが作ったから誰のものでもない」とは扱えません。既存特許との関係、発明への人の関与、共同開発契約、営業秘密として守る範囲を整理します。
また、クラウドへ出せない研究データもあります。その場合は、オンプレミス環境(自社内に置く設備)、専用クラウド、匿名化、連合学習を使い分けます。
ただし、安全性を理由にすべて閉じると学習が進まず、共有しすぎると競争力を失います。そのため、データごとに公開、共同利用、社内限定を分ける設計が必要です。
NEXT STEP
次のステップ
モデルより先に、研究工程と検証責任を決める。
候補生成、計算評価、実験、データ更新のどこへ入るかを分け、顧客価値と知財の境界を設計します。技術の用途探索や顧客検証、連携先の開拓に関する支援は、TeamPro Technologiesのサービスページで確認できます。
AI for Scienceへの参入・提携・待機・見送り
参入判断は、「成長市場だから入る」では決まりません。自社が独自に持つ資産と、予測から実験までのどこを担えるかで四つに分けます。
| 判断 | 向いている状態 | 次に行うこと |
|---|---|---|
| 参入 | 独自データ、実験設備、特定業界の顧客がある | 一つの研究工程を商品化し、再現率と費用を測る |
| 提携 | AIやソフトはあるが、実験・科学人材がない | 大学、研究機関、装置会社と検証責任を分ける |
| 待機 | 顧客課題はあるが、データと評価方法がない | データ整備と評価指標を先に作る |
| 見送り | 汎用モデルを作る以外に差別化がなく、計算資本もない | 顧客に近い統合・検証・運用の領域へ再設計する |
IRIでは、参入可否を「技術が新しいか」だけで評価しません。顧客が現在払っている研究費、代替する工程、実験での検証可能性、独自データの増え方、知財の取り分を分けて考えます。
最初に確認したいのは、AIで出せる候補の数ではありません。顧客が次の意思決定をできる証拠を、誰が、いくらで、何日で作れるかです。
AI for Science事業化を相談したい方へ
AI for Scienceは、創薬、材料、研究設備、クラウド、データ事業で参入条件が異なります。モデル比較から始めると、顧客の研究工程と収益の設計が後回しになりがちです。
イノベーション総合研究所では、次の論点を一緒に整理します。
- 対象とする研究工程と顧客課題
- 国内外プレーヤーと、自社が入る産業レイヤー
- 独自データ、設備、顧客接点の棚卸し
- 予測を実験で確かめる体制と提携先
- 利用料、受託、成果報酬、知財を組み合わせた収益モデル
- データ管理、安全性、知財、責任分担
候補技術が決まっていない段階でも構いません。参入、提携、待機、見送りの条件を整理し、自社が優先して確かめる論点へ落とします。
AI for Scienceに関するよくある質問
AI for Scienceを検討するときに、経営企画、研究開発、新規事業の担当者から出やすい質問を整理します。
AI for Scienceを研究支援から事業へつなぐ
AI for Scienceは、研究者がAIを使うという話から、研究開発の工程を組み替える話へ進んでいます。AlphaFoldは生物学の共通基盤を広げ、MatterGenは必要物性から材料を作り、A-Labは候補を実験で確かめました。
国内でもMatlantis、理研AGIS、研究設備の統合企業が動いています。
一方、モデル単体で持続的な事業を作るのは簡単ではありません。計算費、実験費、データ整備、研究者の受容、安全性、知財が収益を左右します。
新規参入では、次の順番が有効です。
- 顧客の研究工程を分解し、時間と費用が詰まる場所を特定する
- 自社のデータ、設備、顧客接点が生きる一工程を選ぶ
- AIの予測を実験で確かめ、意思決定へ使える証拠を作る
- 成功と失敗のデータが増え、次の精度と採算が改善する循環を作る
- 利用料、受託、成果報酬、知財の組み合わせを決める
参入の判断では、モデルの大きさだけを比べず、科学の問い、計算、実験、事業判断をつなぐ仕組みを作れるかを確認します。
CONTACT
お問い合わせ
AI for Scienceを、モデル比較で終わらせない。
研究課題、独自データ、実験接続、収益モデル、知財と検証責任を整理し、参入・提携・待機・見送りの条件へ落とします。


