
投稿日:2026.09.06 最終更新日:2026.10.09
コンテキスト・エンジニアリングとは?AIエージェントを強くする8社の実践
コンテキスト・エンジニアリングは、AIへ長文を渡す話ではない。
必要な情報だけが循環する、AIの業務環境を作る。
結論は、必要な情報を時点・権限とともに管理し、業務が正しく完了したかを測ることです。8社の実践と4つの参入方法から、新規事業の入口を整理します。
この記事の結論
コンテキスト・エンジニアリングでは、情報量だけでなく、業務に必要な情報を選び、更新し、利用範囲を管理します。
- プロンプトエンジニアリング、RAG、コンテキスト・エンジニアリングの違いを解説します。
- Anthropic、OpenAI、Google Cloudなど8社の設計を、圧縮、記憶、業務データ、権限、時間管理から読み解きます。
- 4つの参入方法と収益モデル、古い記憶、権限、圧縮、コストへの懸念を示します。
生成AIの性能は、モデルだけでは決まりません。というのも、同じモデルを使っても、ある会社のAIエージェントは仕事を完了でき、別の会社では誤回答や手戻りが続くことがあるからです。
この差に関わる要因の一つが、AIへ何を、いつ、どの順番で渡すかという設計です。
この設計を「コンテキスト・エンジニアリング」と呼びます。その対象は指示文だけではありません。
社内文書、会話履歴、顧客情報、利用できるツール、アクセス権、途中の作業結果まで含みます。
ただし、情報を多く渡せばよいわけではありません。というのも、古い規程、権限外の資料、似ているだけの文書が混ざると、AIはかえって判断を誤るからです。
また、長い会話では、必要な決定事項が大量の履歴に埋もれることもあります。
例えば保守受付では、新しく登録された契約書でも、適用が翌月なら今日の対応には使えません。検索の精度に加え、契約の有効日、担当者の権限、人へ引き継ぐ条件が必要です。
本記事は8社の設計を比較し、このような誤りを防ぐ仕組みと、事業として提供する際の評価方法を整理します。
結論は、AIへ何を渡すかと、AIにどの操作を許すかを分けて設計することです。
目次
コンテキスト・エンジニアリングとは何か
コンテキスト・エンジニアリングとは、AIが仕事を進めるために使う情報全体を設計し、必要に応じて更新する取り組みです。日本語では「文脈設計」と考えると分かりやすいでしょう。
Anthropicの解説では、限られたコンテキストウィンドウへ何を入れるかを選び、維持する技術と位置づけています。つまり、目標は、最も長い入力を作ることではありません。
望む行動につながる、少量で重要度の高い情報をそろえることです。
AIが一度だけ文章を作るなら、明確な依頼文で足りる場合があります。しかし、AIエージェントが複数の資料を調べ、ツールを使い、途中結果を見て次の行動を決める場合、状況は変わります。
作業が進むたびに、必要な情報と不要な情報が入れ替わるからです。
たとえば、顧客対応エージェントには次の情報が必要です。
- どの問い合わせを解決するのか
- 会社として守る回答方針
- 顧客の契約、購入、過去の問い合わせ
- 最新の製品仕様と社内規程
- 注文確認や返金に使えるツール
- 人へ引き継ぐ条件と実行記録
これらを一つの長い指示文に書くのではなく、必要な時点で取得し、権限を確かめ、古い情報を外します。この一連の仕組みがコンテキスト・エンジニアリングです。
プロンプトエンジニアリングやRAGと何が違うのか
三つの言葉は対立するものではありません。プロンプトエンジニアリングとRAGは、コンテキスト・エンジニアリングを構成する部品です。
| 手法 | 主に設計するもの | 得意なこと | 単独では残る課題 |
|---|---|---|---|
| プロンプトエンジニアリング | 指示の言葉、順序、出力形式 | 役割や判断基準を明確にする | 指示文だけではデータ更新やアクセス制御を実行できない |
| RAG | 質問に近い文書の検索と引用 | 外部知識を回答時に補う | 検索と回答生成だけでは、作業状態や操作権限を別途設計する必要がある |
| コンテキスト・エンジニアリング | 指示、データ、記憶、ツール、状態、権限の全体 | AIが仕事を続けられる環境を作る | 設計・評価・運用を横断する体制が必要 |
プロンプトは「何をしてほしいか」を伝えます。また、RAG(関連資料を検索して回答に使う仕組み)は「答えるためにどの資料を読むか」を助けます。
そしてコンテキスト・エンジニアリングは、さらに「今の顧客は誰か」「どこまで作業したか」「どの操作を許すか」「何を記録として残すか」まで扱います。
Salesforceの公式ガイドも、業務データを取得する仕組みと、ルールで必ず実行する処理、AIに判断させる処理を組み合わせています。RAGの仕組みと事業機会を土台に、作業全体へ設計を広げる考え方です。
製品によってはRAGに記憶やツールを組み込むため、名称だけで機能の有無を判断せず、実装範囲を確認します。
したがって、「RAGを導入済みだから対応できている」とは限りません。検索結果が正しくても、顧客を取り違えたり、利用できないツールを選んだり、前の手順を忘れたりすれば、業務は完了しません。
なぜ今、コンテキスト・エンジニアリングが必要なのか
背景には、生成AIの使い方が「回答」から「実行」へ広がったことがあります。長い仕事を任せるほど、AIが参照する情報は増え、途中で変化します。
第一の理由は、コンテキストウィンドウが大きくなっても、注意力は無限ではないことです。Anthropicは、長い入力で必要な情報を取り出す性能が下がる「context rot」を説明しています。
影響はモデル・課題・入力内容で変わるため、短さ自体を目標にせず、判断に必要な例外や根拠を残して評価します。
第二の理由は、AIエージェントがツールを使うことです。AIエージェントの新規事業で説明したように、エージェントは検索、データ更新、予約、決済などを組み合わせます。
そのため、ツール名や説明が曖昧で、権限も渡し過ぎていれば、誤った操作へつながります。
第三の理由は、仕事が一回の会話で終わらないことです。たとえば、数時間の調査、数日にわたる開発、継続的な顧客支援では、履歴をそのまま残し続けられません。
そのため、決定事項を要約し、未解決の課題を残し、重い出力を外部へ退避する必要があります。
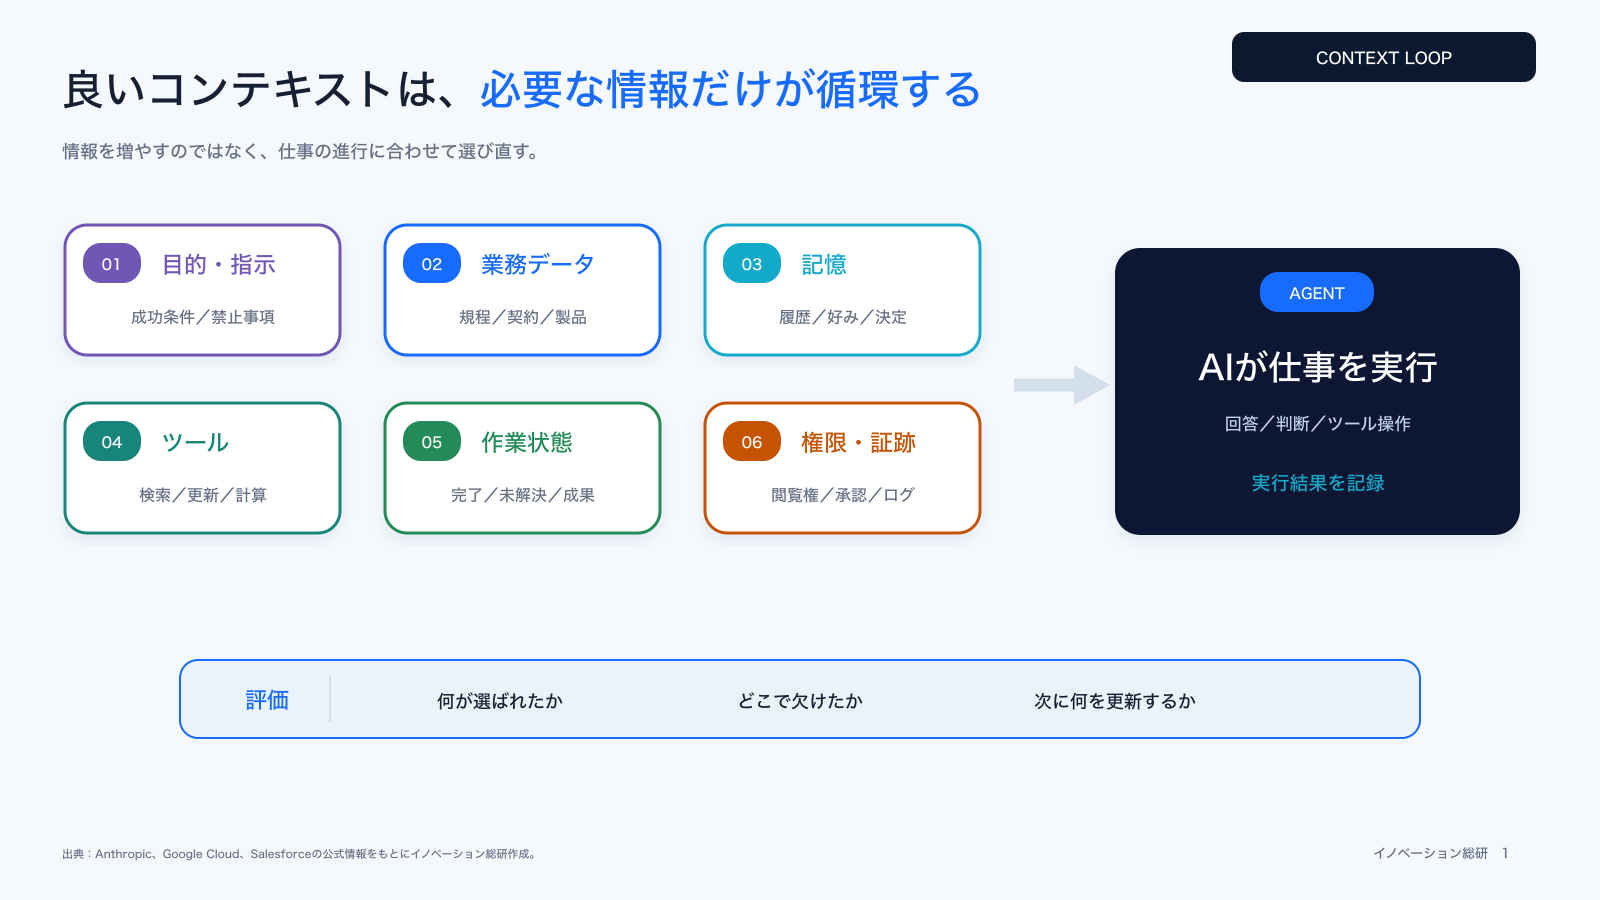
つまり、モデルの上限を広げるだけでは不十分です。必要な情報を選び、古い情報を捨て、結果から更新する運用が必要です。
設計対象は六つの情報に分ける
「コンテキスト」という言葉は広いため、そのままでは設計できません。実務では六つに分けると、抜けと詰め込み過ぎを見つけやすくなります。
| 情報の種類 | 具体例 | 設計時の問い |
|---|---|---|
| 目的・指示 | 役割、成功条件、禁止事項、出力形式 | 何ができれば仕事は完了か |
| 業務データ | CRM、規程、製品情報、契約、文書 | 最新で正しい情報はどこにあるか |
| 記憶 | 会話履歴、顧客の希望、過去の決定 | 何を残し、いつ忘れるべきか |
| ツール | 検索、更新、計算、外部API | どの場面でどのツールを使うか |
| 作業状態 | 完了手順、未解決事項、中間成果 | どこまで終わり、次は何か |
| 権限・証跡 | 閲覧権、承認条件、引用元、操作ログ | 誰が何を見て実行できるか |
六つを同じ方法で保存する必要はありません。たとえば、変わりにくい方針はシステム指示へ置きます。
一方、最新の在庫や契約は、その都度データベースから取得します。そして、長い会話は要約し、元の記録と結びます。
重要なのは、AIへ見せる前の判定です。具体的には、データが新しいか、利用者に閲覧権があるか、今回の目的に関係するかを確認します。
ゼロトラストの考え方と同じく、「社内データだから信頼する」のではなく、問い合わせごとに権限を確かめます。
「この操作は禁止」と指示文に書くだけでは、アクセス制御になりません。データ取得時とツール実行時に、アプリケーション側で利用者の権限を検証します。
外部文書や記憶の内容が、承認条件や実行権限を書き換えないように分離します。
評価も出力だけで終わりません。むしろ、どの資料が選ばれ、どの指示が効き、どのツール呼び出しで失敗したかを追います。
つまり、答えを直すだけでなく、情報を選ぶ仕組みを直すことが改善につながります。
コンテキスト・エンジニアリングの市場はどう立ち上がるか
コンテキスト・エンジニアリングには、統一された市場規模がまだありません。ベクトルデータベース、RAG、エージェント基盤、メモリ、企業内検索などをどこまで含めるかで数字が変わるためです。
本記事では、RAG、メモリ、企業内検索などの隣接市場を合算した規模は示しません。製品が提供されていること、開発資金が集まったこと、有料顧客が継続して使うことを分け、対象業務の予算を顧客へ確認します。
以下の三つは、各社の公開情報から当研究所が整理した供給側の動きです。需要や市場の成熟度を測定した結果ではありません。
- 大手クラウドが、エージェント向け記憶やコンテキスト管理を標準機能にしている
- メモリ専業や時間軸ナレッジグラフの企業へ資金が流れている
- CRM、企業内検索、開発支援など、業務アプリ側が文脈管理を競争軸にしている
Mem0は2025年10月28日の公式発表で、SeedとSeries Aを合わせて2,400万米ドルを調達したと報告しました。これは開発を支える資金調達額であって、売上や市場規模ではありません。
Google CloudのMemory BankやSalesforceのIntelligent Contextなど、既存基盤に組み込まれる機能もあります。独立製品の販売と、既存サービスの追加機能では、顧客が予算を付ける単位も変わります。
新規参入企業にとっては、大手クラウドと同じ汎用メモリを作ることが目的ではありません。特定業界のデータ、権限、更新頻度、評価方法を知る企業が、足りない実装層を押さえられるかが重要です。
コンテキスト・エンジニアリングを支える四層の産業構造
市場を製品名だけで見ると、競合と提携先を見誤ります。以下は当研究所による四つの役割の整理です。
企業や製品が複数の役割を担うこともあり、排他的な業界分類ではありません。
| 層 | 提供価値 | 主な企業・製品例 | 競争力になるもの |
|---|---|---|---|
| データ・検索基盤 | 文書、ベクトル、関係性、更新履歴を保存・検索 | Pinecone、Weaviate、Neo4j、Elastic | 検索精度、速度、データ接続、権限同期 |
| モデル・クラウド機能 | 長い入力、キャッシュ、セッション、記憶を提供 | Anthropic、OpenAI、Google Cloud | モデル性能、推論費、開発者体験、運用範囲 |
| コンテキスト管理 | 記憶の抽出、圧縮、更新、時間管理を担う | Mem0、Letta、Zep | 記憶精度、矛盾解消、移植性、観測性 |
| 業務アプリ・導入 | CRMや社内知識と結び、仕事を完了させる | Salesforce、Glean、業界特化SaaS | 業務理解、権限、既存顧客、導入支援 |
データ・検索基盤では検索性能と接続、コンテキスト管理では情報の選択・更新、業務アプリでは仕事を完了する手順が主な確認点です。表の上下を市場規模や優劣の順序とせず、自社の顧客接点、データ利用権、保守体制と合う役割を探します。
また、各層は代替関係だけではありません。たとえば、メモリ専業企業がクラウドへ接続し、業務アプリが検索基盤を使い、導入企業が独自評価を重ねます。
そのため参入時は、「どの層を自社で持ち、どこを提携するか」を決めます。
大手4社はコンテキストをどう設計しているか
大手企業は、コンテキストを単なる長文入力として扱っていません。長期作業、記憶、業務データ、決定的なルールという異なる課題から設計しています。
Anthropic|少量で重要度の高い情報を選び、長い作業を圧縮する
Anthropicは、コンテキストを有限の注意予算として扱います。公式解説では、指示、ツール、例、外部データ、履歴を必要最小限へ絞る考え方を示しています。
長い作業では、会話を要約して新しいコンテキストへ移す「compaction」、重要な決定を外部ファイルへ残すノート、役割ごとに文脈を分けるサブエージェントを使い分けます。Claude Codeでは、設計判断や未解決の不具合を残し、重複したツール出力を捨てる例が紹介されています。
事業面で参考になるのは、「情報を増やす」より「何を捨てても仕事が続くか」を製品機能にした点です。長期案件を扱う開発支援、調査、法務、運用監視では、圧縮後も判断の根拠が残るかが価値になります。
OpenAI|CodexとResponses APIで長時間の作業状態を引き継ぐ
OpenAIは、長時間動くエージェント向けにコンテキスト圧縮を実装しています。Codexのエージェントループ解説では、会話が一定量を超えると、それまでの入力を小さな項目群へ置き換え、作業を続ける仕組みを説明しています。
この解説では、Responses APIの圧縮機能が、モデルのための暗号化された内部表現を返すと説明しています。これは、人が読める議事録や監査記録とは別のものです。
業務へ応用するときは、契約条件・承認・未解決事項を別途記録し、圧縮後も確認できるようにします。
この設計は、ソフトウェア開発以外にも応用できます。たとえば、数日にわたる監査、調査、顧客案件では、成果物、決定、残課題を構造化して残す必要があります。
つまり、長い会話ログそのものより、次の担当が仕事を再開できる状態に価値があります。
Google Cloud|Memory Bankで残す記憶の種類と範囲を管理する
Google Cloudの現行ドキュメントでは、Gemini Enterprise Agent Platformに、会話をまたぐ記憶を扱うMemory Bankがあります。会話から重要な事実や好みを抽出し、後のやり取りで取得できます。
保存する記憶のテーマや抽出例に加え、scopeという区分で顧客・セッションなどの保存範囲を設定できます。有効期限(TTL)も指定できますが、設定しない場合は自動失効しません。
何を残すかだけでなく、何をいつ消すかも運用者が決めます。
これは、すべてを記憶する危険を避ける設計です。たとえば、顧客の希望は残したい一方、古い住所や一時的な相談内容は消す必要があります。
そのため企業向けでは、記憶の精度と同時に、削除、範囲、監査を商品要件にする必要があります。
また、scopeの設定とアクセス権の制御は別です。Memory BankのIAM条件の説明には、scopeに応じてアクセスを制御する方法と、条件を使えないAPIが示されています。
顧客単位に名前を付けただけで隔離が完了したとせず、使用するAPIと権限設定を確認します。
Salesforce|CRM、文書、ツール、業務ルールを一つの設計図にする
SalesforceはAgentforceで、CRMデータ、Data 360、Knowledge記事、文書、Slack、ツール、記憶を組み合わせます。Agentforceの公式ガイドでは、生成AIの柔軟さと、ルールで制御する決定的な処理を組み合わせています。
同社が重視するのは、長い指示文だけで業務を制御しないことです。例えば、本人確認が完了するまで特定の操作を許さない条件をルールとして実装し、対話の柔軟な進行と組み合わせます。
また、必要なデータを先に取得し、サブエージェントが使えるアクションも絞ります。
CRMを持つ企業の強みは、顧客データだけではありません。むしろ、誰がどの情報を見て、どの処理を実行できるかという業務権限を持っています。
つまり、コンテキスト・エンジニアリングを、既存業務の制御と一体化した例です。
専業4社が作るメモリと企業内コンテキスト
専業企業は、大手クラウドの隙間へ入っています。モデルを作るのではなく、複数モデルへ共通する記憶、時間変化、権限、企業知識を扱う点が特徴です。
Glean|企業内の権限を保ったまま、知識をAIへ渡す
Gleanは、企業内検索とAIエージェントを提供しています。公式サイトでは、社内ツールへ接続し、利用者が閲覧を許可された情報だけを回答やアクションへ使う設計を掲げています。
企業内では、同じ文書でも人によって見える範囲が違います。そのため、人事、法務、開発、顧客情報を一つの検索基盤へ集めても、元の権限を壊せません。
そこでGleanは、検索、権限、エージェント作成、問い合わせと操作の観測を一体で扱います。
この例は、企業向けコンテキスト事業の入口が「高精度検索」だけではないことを示します。コネクタの保守、権限同期、監査ログ、管理者の運用まで含めて初めて導入できます。
Gleanが掲げる権限対応は製品の設計方針です。導入先では、部署異動や退職で元システムの権限を変更した後、検索結果・保存済み記憶・ログの閲覧へいつ反映されるかを試験します。
Mem0|異なるモデルやアプリをまたぐ記憶層を目指す
Mem0は、会話から記憶を抽出し、分類し、時間経過や確信度を踏まえて更新するメモリ基盤です。新しい情報と過去の記憶が矛盾した場合は、その扱いも調整します。
同社の戦略は、記憶を特定モデルへ閉じ込めないことです。つまり、開発企業がモデルを変更しても、顧客との履歴や好みを持ち運べる中立層を狙います。
同じ2025年10月の発表では、GitHubスターが41,000件超、Pythonパッケージのダウンロードが1,400万回、2025年第3四半期のAPI呼び出しが1億8,600万回と報告されています。いずれも同社公表の開発・利用規模の指標です。
ダウンロードには再取得、APIには繰り返し実行が含まれ得るため、有料利用者数や導入企業数へ置き換えません。
このメモリ基盤は、データ移植性を価値にしようとしています。実際の移行では、記憶の形式、利用許諾、削除、別モデルでの再評価まで確認します。
Letta|AI自身が記憶を書き換えるステートフルなエージェントを作る
Lettaは、UC Berkeley発のMemGPT研究を土台にしたエージェント基盤です。2025年1月の公式開発環境紹介では、常に文脈へ置くCore Memoryと、必要なときに探す外部メモリを分けています。
Core MemoryはBlocksと呼ばれる単位で管理され、エージェント自身が追記や置換を行えます。ユーザーの好みや、エージェントの役割など、頻繁に参照する情報を残します。
一方、全文書や長い履歴は外へ置きます。
Lettaの示唆は、記憶を後付けの検索機能ではなく、エージェント実行基盤の中核に置くことです。何を記憶し、誰が変更し、変更履歴をどう評価するかまで設計対象になります。
自己編集できることは、書き換えた内容が正しいことを保証しません。顧客の希望など更新を許す項目と、承認条件・権限のようにアプリケーションが管理する規則を分け、変更履歴を追えるようにします。
Zep|時間と出典を持つContext Graphで古い事実を無効化する
Graphitiは、時間軸を持つナレッジグラフを作るオープンソースの仕組みです。Zepの商用プラットフォームとは、提供・運用の範囲を分けて比較します。
公式概要は、会話や業務データから関係を抽出し、事実の有効時点と更新履歴を扱う設計を説明しています。
たとえば、顧客の契約プランが変更された場合、古い情報を消して終わりにしません。むしろ、古い契約が有効だった期間と、新しい契約が始まった時点を持ちます。
これにより、「現在」と「当時」を分けて検索する設計ができます。ただし、抽出した契約条件や日付が正しいかは原文と照合する必要があります。
金融、医療、法務、保守など、情報の鮮度と出典が重要な業務では、この時間管理が差になります。似た文書を探すだけのRAGから、変化する業務状態を扱うコンテキストへ広げた例です。
8社の事例から整理するコンテキスト管理の確認点
以下は8社の設計を参考にした当研究所の確認事項です。各社の売上や利益を同じ条件で比較し、成功要因を特定したものではありません。
機能の数ではなく、仕事の継続性と改善の仕組みを見ます。
第一は、保存と投入を分けることです。つまり、持っているデータをすべてモデルへ渡しません。
むしろ、外部へ保存し、目的に応じて必要な部分だけを読み込みます。また、長い履歴は要約し、原文へ戻れるようにします。
第二は、時間と出典を持つことです。具体的には、事実が変わったとき、古い情報と新しい情報を区別します。
さらに、回答の根拠となった資料と取得時点を残せば、人が確認できます。
第三は、権限を検索後ではなく検索前に適用することです。というのも、AIが見てはいけない情報を取得してから隠す設計では、漏えいの危険が残るからです。
そのため、利用者、目的、操作ごとに取得範囲を制御します。
第四は、失敗をコンテキスト改善へ戻すことです。たとえば、誤回答を見つけたら、プロンプトだけを修正しません。
むしろ、検索の候補、記憶の抽出、ツール説明、圧縮内容のどこで情報が欠けたかを特定します。
第五は、業界固有の型を持つことです。というのも、金融の契約、製造の設計変更、医療の診療記録では、正しい情報の単位と更新方法が異なるからです。
そのため、汎用基盤へ業界固有の用語・関係の定義、権限、評価セットを重ね、汎用機能だけでは解けない課題が残るかを確かめます。
コンテキスト・エンジニアリング事業を4つの判断に分ける
参入:特定業務の顧客、データ、評価方法を持つ
一つの仕事へ絞り、記憶、権限、ツール、評価を一体で実装します。
提携:顧客接点はあるが、検索・メモリ技術がない
基盤企業と組み、業界データ定義と導入責任を自社で持ちます。
待機:正解データと更新責任者が決まらない
開発を急がず、失敗分類と評価セットを先に整えます。
見送り:汎用プロンプト集や単純RAGだけで差別化する
顧客固有の更新、権限、実行まで扱えるかを再設計します。
コンテキスト・エンジニアリングで狙える四つの新規事業
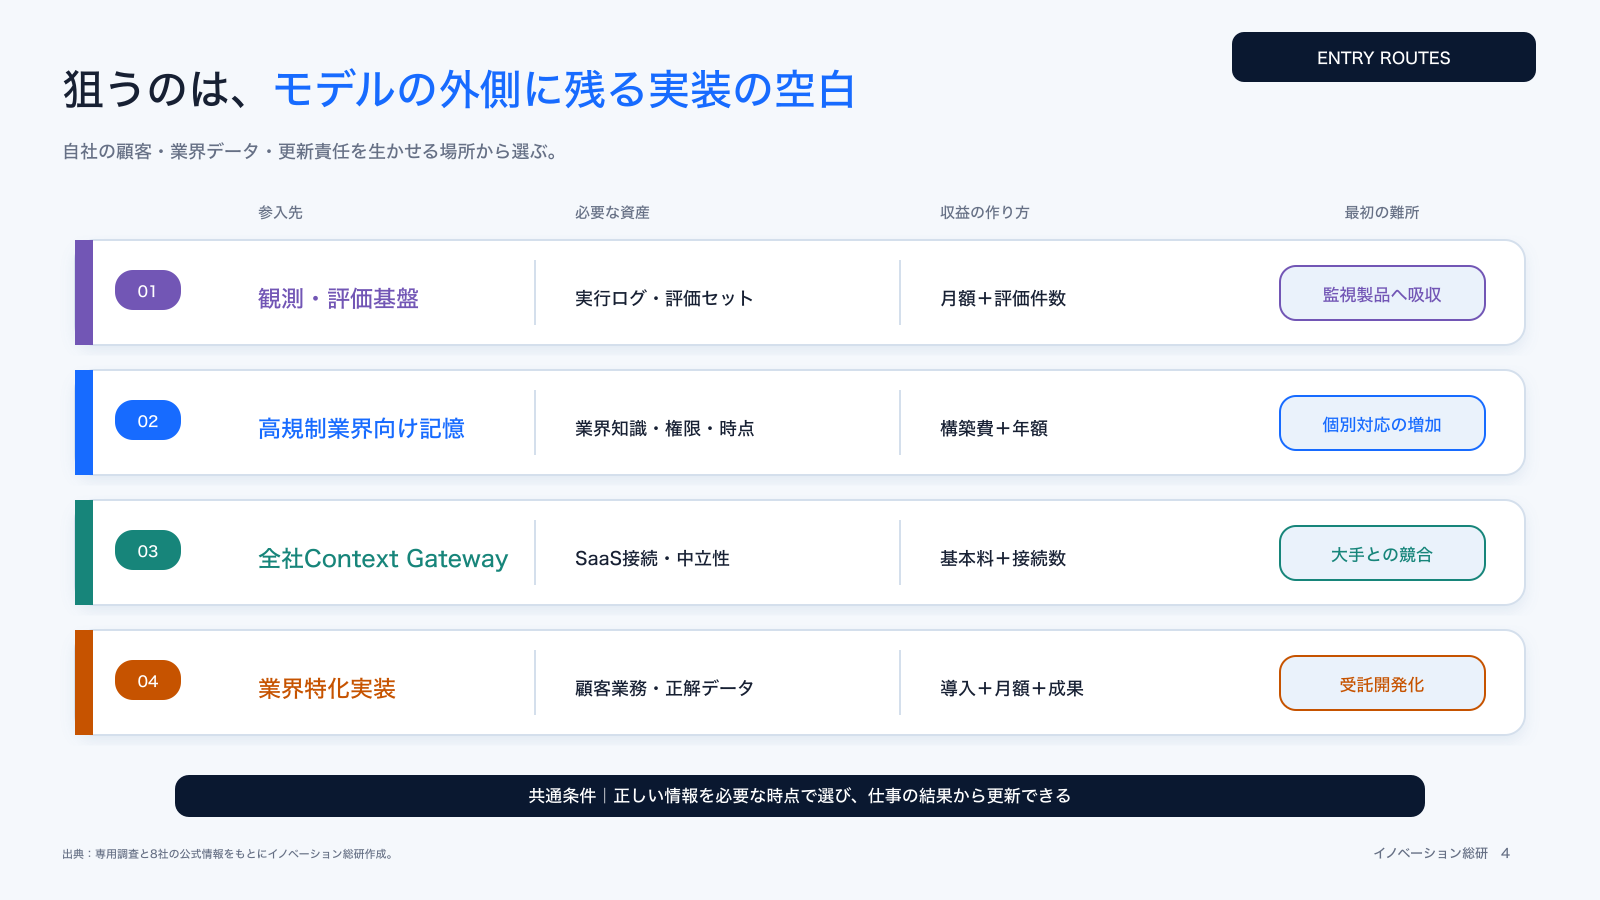
新規参入では、汎用のメモリAPIを正面から作るより、自社が持つ業界知識や顧客接点から始める方が現実的です。以下は当研究所が提案する四つの参入案です。
料金方式は提案であり、各社の公表価格や収益性を表すものではありません。
| 参入方法 | 主な顧客 | 最初に提供する価値 | 収益モデル | 主な提携先 | 最大の懸念 |
|---|---|---|---|---|---|
| 1. コンテキスト診断・観測基盤 | AIエージェントを運用する企業 | 誤判断時に、使った情報と欠けた情報を追跡 | 月額+評価件数課金 | LLM基盤、監視ツール、SIer | 既存監視製品に吸収される |
| 2. 高規制業界向け記憶・検索基盤 | 金融、製薬、医療、公共、重工 | 時間、出典、権限を保った検索と記憶 | 初期構築+年額利用料 | 業界SaaS、IdP、データ基盤 | 導入が長く個別対応が増える |
| 3. 全社Context Gateway | 複数のAIを使う大企業 | モデルをまたぐ共通ルール、記憶、権限 | 基本料+接続数・利用量課金 | クラウド、SaaS、MCP提供者 | 大手クラウドとの競合 |
| 4. 業界特化エージェント実装 | 特定業務を自動化したい企業 | 対象業務のデータ、ツール、評価を一体化 | 導入費+月額+成果連動 | 業界企業、BPO、専門家 | 受託開発から抜けられない |
自社の強みが「技術」ではなく「顧客業務」にある場合は、四つ目から入り、そこで得た評価データや共通部品を一つ目から三つ目へ広げる順番が現実的です。
一つ目の観測基盤は、比較的小さく始められます。具体的には、既存エージェントの実行ログを受け取り、使われた文書、圧縮で消えた情報、選ばれたツールを見える化します。
そして、評価データが蓄積すれば、改善提案や自動修正へ広げられます。
二つ目では、厳しい要件に対応する価値と、審査・個別接続・保守にかかる費用を比べます。高い要件が、そのまま高単価や利益につながるとは限りません。
自社が金融、製造、医療などの業務と規制を知っている場合、汎用ツールでは扱いにくい時間・権限・証跡を商品化できます。
三つ目は、社内で増える複数のAIエージェントをつなぐ事業です。顧客情報やプロジェクト状態を共通化しつつ、部署ごとの権限を保ちます。
ただし、巨大クラウドが標準機能を広げるため、業界固有の接続や中立性が必要です。
四つ目は、最も顧客価値へ近い入口です。具体的には、保守受付、見積審査、品質文書作成など、一つの業務を完了させます。
ただし、受託開発で終わらないよう、共通のデータ定義、評価、コネクタを再利用できる形へ資産化します。
収益モデルは導入費だけにしない
コンテキスト整備は、最初に人手がかかります。文書の棚卸し、権限確認、ツール接続、評価データ作成が必要だからです。
そのため、導入費だけで売ると、売上が人員数に縛られます。
継続収益へつなぐ単位は、次の四つです。
- 接続するデータ源や業務システムの数
- 管理する利用者、エージェント、記憶の数
- 評価・監査する実行回数
- 削減できた推論費や人の確認工数
ただし、トークン削減額だけの成果報酬は不安定です。というのも、モデル提供者が価格を下げれば、顧客価値も下がって見えるからです。
そのため、誤回答率、完了率、引き継ぎ率、確認時間など、業務成果と結びます。
また、顧客ごとの個別ルールをそのまま抱えないことが重要です。そこで、共通コネクタ、権限テンプレート、評価セット、業界用語辞書へ分け、再利用の権利と秘密保持を確認できる部分を次の顧客へ展開します。
顧客の機密や個人情報を、許可なく別の顧客の検索・学習・評価へ回しません。導入作業から、更新され続ける運用資産へ収益源を移せるかが事業性を左右します。
参入前に確認したい六つの懸念
コンテキスト・エンジニアリングは、AIの信頼性を高める一方、新しい事故も生みます。特に次の六つを事業計画へ入れます。
1. 古い記憶が現在の判断を上書きする
顧客の契約や社内規程は変わります。というのも、古い情報を単に残すと、AIは過去と現在を混ぜてしまうからです。
そのため、有効期間、出典、更新責任者を持ち、矛盾時の優先順位を決めます。
2. 不正な文書が指示として入り込む
外部文書やメールに、AIの指示を変える文章が含まれる場合があります。データと命令を分け、取得した文書から直接ツール実行へ進まない設計が必要です。
3. 検索が権限外の情報を取得する
回答画面で隠しても、モデルへ渡った時点で漏えいリスクが生まれます。元システムの権限を検索前に適用し、記憶へ保存する範囲も分けます。
4. 圧縮で重要な条件が落ちる
長い作業を要約すると、数字、例外、未解決事項が消えることがあります。要約だけでなく、決定ログ、元資料への参照、チェックリストを残します。
5. 推論費と応答時間が膨らむ
入力が増えると費用や待ち時間が増える場合がありますが、キャッシュ、検索、記憶の更新・圧縮などを含む総量で測ります。固定情報を減らした後に検索回数や人の確認が増えれば、総費用は下がらないこともあります。
料金とキャッシュの条件をそろえ、処理1件の費用と応答時間を比較します。
6. 品質責任が複数社へ分散する
モデル、検索、メモリ、業務アプリを別会社から調達すると、障害原因が分かりにくくなります。誰がデータ鮮度、検索精度、ツール実行、最終承認を担うかを契約で分けます。
データと評価を事業の資産にする
コンテキスト事業の競争力は、接続できる文書数ではありません。どの情報を渡せば、どの業務が正しく完了するかを学んだ評価データにあります。
まず、一つの業務について、成功、部分成功、失敗を定義します。顧客対応なら、回答が自然かだけでなく、正しい契約を参照したか、許可された操作か、必要時に人へ引き継いだかを測ります。
次に、失敗を原因別に分けます。具体的には、指示不足、検索漏れ、古い記憶、ツール選択、権限、圧縮、モデル推論のどこで起きたかを記録します。
というのも、同じ誤回答でも、直す場所は異なるからです。
改善前後は、同じモデル・入力条件と固定した評価セットで比べます。調整に使った問題だけへ最適化しないよう、調整に使わない問題も分けて確認します。
モデル更新時には再評価し、平均の正答率に加え、権限外操作、古い条件の利用、必要な引き継ぎの漏れを別に数えます。
架空例:保守契約を正しく参照し、必要な案件を人へ渡す
以下は説明用の架空例で、特定製品の導入実績ではありません。9月20日に設備の保守依頼を受け、登録済みの新契約は10月1日から有効とします。
AIが参照すべきなのは、9月20日に有効な旧契約です。「最も新しいファイル」を取るだけでは判断を誤ります。
顧客Aの資料はAを担当する利用者だけに取得させ、契約にない作業は承認担当へ渡す、と事前に決めます。評価問題100件は、自動で完了してよい70件と、人へ引き継ぐべき30件に分けます。
| 評価項目 | 改善前 | 改善後 |
|---|---|---|
| 正しい自動完了 | 50件 | 60件 |
| 正しい引き継ぎ | 24件 | 28件 |
| 正しい処理の合計 | 74件 | 88件 |
| 権限外操作 | 2件 | 1件 |
正しい処理が88%へ増えても、権限外操作が残るなら公開しません。この例では、人へ渡すべき案件を無理に自動完了させても加点しません。
権限外操作の行は誤処理の内数で、上の件数へ加算しません。重大な誤りを修正して再試験し、未知の入力でも安全に止まることを確認します。
試験で0件になっただけで、将来の事故ゼロを保証するものではありません。
当研究所では、このような検証から始めることを提案します。顧客が採用判断に使う指標と、失敗時に戻る工程を先に決めます。
NEXT STEP
次のステップ
モデルより先に、業務の正解と情報責任を決める。
顧客業務、データ、記憶、権限、ツール、評価のどこを自社で持つかを分け、収益モデルまで設計します。技術の用途探索や顧客検証、連携先の開拓に関する支援は、TeamPro Technologiesのサービスページで確認できます。
コンテキスト・エンジニアリングへ参入するかの判断基準
参入判断では、「AIに詳しいか」より「独自の業務文脈を持てるか」を見ます。次の四つに分けると、投資の順番が明確になります。
| 判断 | 当てはまる状態 | 次の行動 |
|---|---|---|
| 参入 | 特定業務の顧客、データ、評価方法を持つ | 一業務へ絞り、記憶・権限・ツールを一体で実装する |
| 提携 | 顧客接点はあるが、検索・メモリ技術がない | 基盤企業と組み、業界データ定義と導入を自社で持つ |
| 待機 | 課題はあるが、正解データと責任者がいない | 業務記録を整え、失敗分類と評価セットを先に作る |
| 見送り | 汎用プロンプト集や単純RAGだけで差別化する | 顧客固有の更新・権限・実行まで扱えるか再設計する |
参入しやすいのは、既存の顧客基盤と業務データを持つ企業です。というのも、業界SaaS、BPO、保守会社、SIer、専門情報会社は、現場の例外と責任分担を知っているからです。
そのため、モデル企業と同じ土俵へ上がる必要はありません。
一方、独自データを持たず、顧客業務へも入れない場合、汎用ツールの再販売になりやすくなります。提携で顧客接点を作るか、対象業務を狭くする必要があります。
事業構想を相談する前に整理したいこと
相談の前に、技術一覧より業務の失敗場面を整理すると、議論が速くなります。次の五つを一枚にまとめます。
- AIへ任せたい仕事と、人が承認する仕事
- 現在、担当者が探している資料とシステム
- 情報が古い、見つからない、権限が曖昧になる場面
- 正しく完了したと判断できる指標
- 自社で持つ層と、外部へ任せる層
私たちイノベーション総研では、モデル比較だけでなく、顧客課題、データ、業務責任、収益モデルをつなぎます。実装前に、参入、提携、待機、見送りの条件を分けることで、不要な開発を減らします。
顧客や業務を再現するカスタマーデジタルツインを検討している場合も、同じ整理が必要です。どのデータを現在の状態として扱い、誰にどこまで見せるかが、実装の前提になります。
コンテキスト・エンジニアリングのよくある質問
導入や新規事業を検討するときに出やすい五つの疑問へ、要点だけ答えます。
まとめ|コンテキスト・エンジニアリングはAIの業務環境を作る
コンテキスト・エンジニアリングは、AIへ長い資料を渡す技術ではありません。目的に必要な情報を選び、権限を確かめ、仕事の進行に合わせて更新し、失敗から改善する仕組みです。
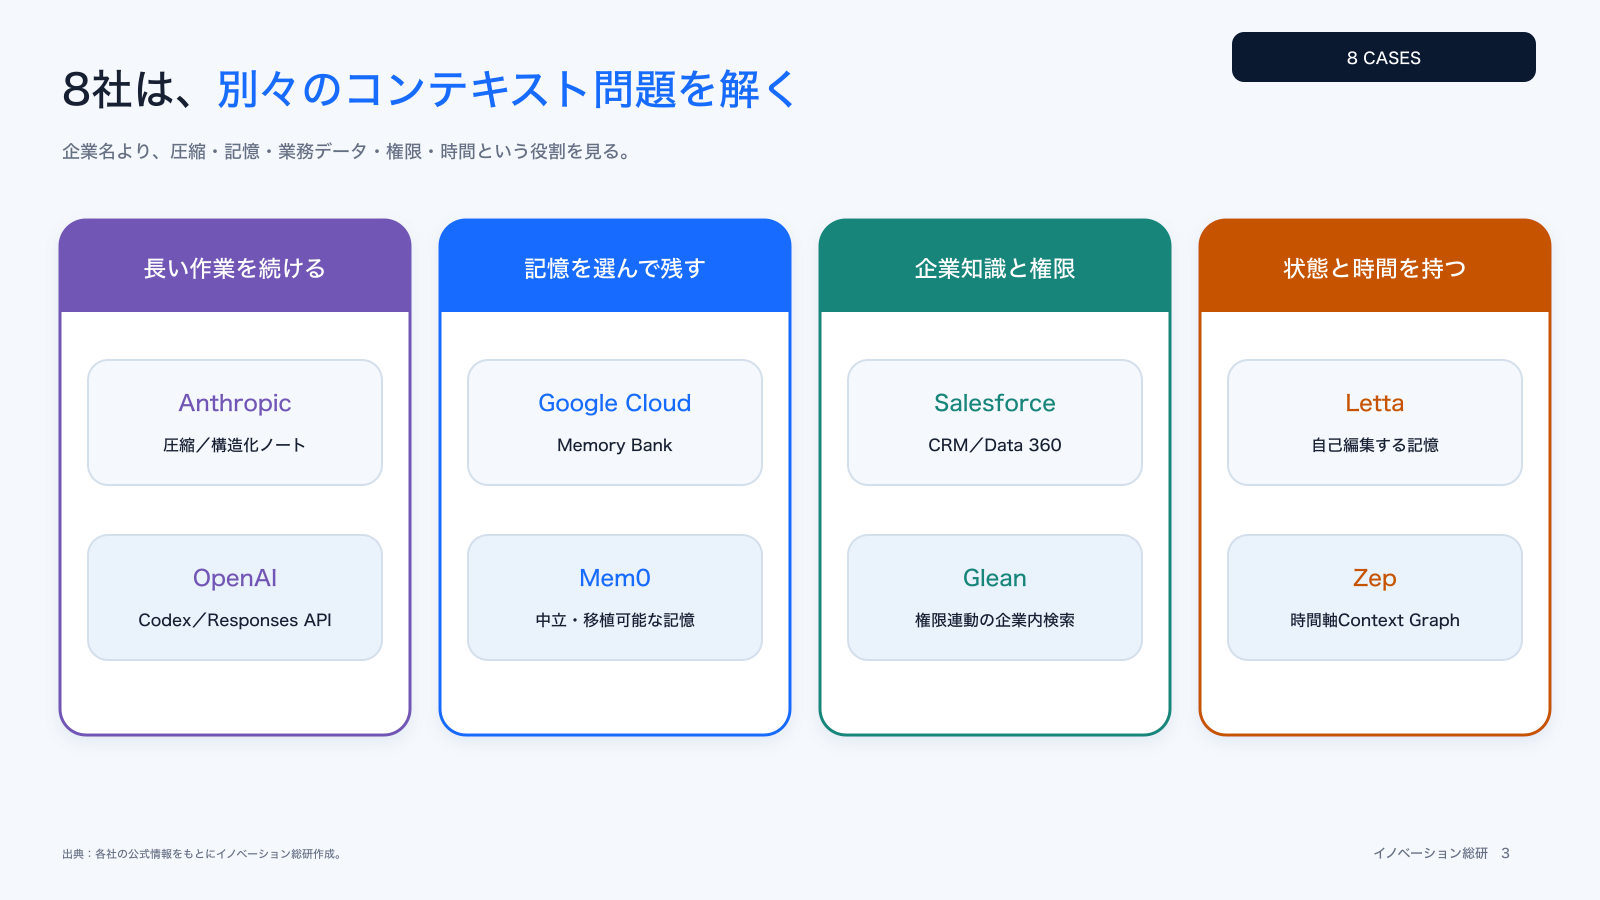
AnthropicとOpenAIは長い作業の圧縮、Google CloudとLettaは記憶、SalesforceとGleanは業務データと権限、Mem0はモデルをまたぐ記憶、Zepは時間変化を扱っています。これらは主な機能による整理で、各社の領域は重なります。
新規事業では、汎用基盤を正面から作るより、特定業界のデータ、権限、評価、業務実装へ入る方が勝ち筋を作りやすいでしょう。観測基盤、高規制業界向け記憶、全社Context Gateway、業界特化実装のどこを狙うかを決めます。
大切なのは、AIが知っている量ではありません。必要なときに、正しい情報を、許された範囲で使い、仕事を完了できるかです。
CONTACT
お問い合わせ
コンテキスト・エンジニアリングを、技術導入で終わらせない。
対象業務、独自データ、更新責任、アクセス権、評価方法、収益モデルを整理し、参入・提携・待機・見送りの条件へ落とします。


