
投稿日:2026.09.08 最終更新日:2026.09.30
小規模言語モデル(SLM)はどこで使う?8社のモデルと3つの業務事例
小規模言語モデルは、LLMより小さいだけなのか。
どの仕事を、どこで動かすと価値が出るのか。
小規模言語モデルは、対象業務の品質を保ち、人の確認まで含む費用を下げられるかで選びます。8社のモデル・基盤と三つの業務事例から、端末内・社内・クラウドの使い分けと、新規事業の候補を整理します。
この記事の結論
小規模言語モデルは、狭く定義した仕事を端末や社内環境で動かすときに力を発揮します。
- SLMとLLMは優劣ではなく、仕事の難しさに応じて役割を分けます。
- 国内外の企業は、モデルだけでなくOS、端末、実行基盤、業務評価を組み合わせています。
- 参入余地は、業界特化、端末組み込み、振り分け・監視、閉域運用にあります。
生成AIを導入するとき、最も高性能なモデルを選べばよいとは限りません。たとえば、定型文書の分類、端末内での要約、決まった形式への情報抽出まで、毎回大きなモデルへ送ると、費用と待ち時間が積み上がります。
また、機密情報を外部へ送れない業務や、通信が止まる現場では、そもそもクラウド型の大規模言語モデルを使えないこともあります。
小規模言語モデルはSmall Language Model、略してSLMと呼ばれます。言語モデルのうち比較的小さな計算資源で扱えるモデルを指す呼び方で、端末や社内サーバーだけでなくクラウドでも利用されます。
導入では、モデルの精度、端末性能、更新、監視、人が確認する範囲を合わせて設計します。本稿は2026年9月28日に公式情報を確認し、製品の仕様と、実証の結果、本番運用への計画を分けて解説しています。
各モデルは参入方法を理解するための例で、最新版の性能ランキングではありません。
目次
小規模言語モデル(SLM)とは?「小さい」の基準は固定ではない
SLMは小型の言語モデルを指す呼び方です。名前やパラメータ数だけでなく、必要資源と業務品質で比べます。
小規模言語モデルは、文章の分類、抽出、生成などを行う言語モデルのうち、比較的小さなものを指します。SLMも広い意味ではLLMの一種として説明されるため、本稿では便宜上、小型モデルと大規模モデルを比較します。
パラメータは、学習で調整する重みなどの数値です。モデルを小さくする方法には、構造の工夫、知識蒸留、重みの数値表現を軽くする量子化などがあります。
量子化で保存容量は減っても、パラメータの個数自体は変わらない場合があります。
「何個以下ならSLM」という統一基準はありません。また、全パラメータ数と一回の処理で使う数が異なるMoE型モデルもあります。
例えばGemma 3nの実効サイズやGranite 4.0の稼働パラメータ数を、モデル全体の数や必要メモリーと同一視せずに比較します。
そのため、SLMかどうかを名前だけで判断しないことが大切です。見るべきなのは、対象の仕事、必要なメモリー、応答時間、端末、データの置き場所です。
LLMとの違いは、性能より仕事と実行場所で見る
モデルの規模と実行場所は別の選択です。対象業務を分け、品質・通信・費用を合わせます。
大規模モデルは幅広い知識や複雑な推論を必要とする処理の候補になり、小型モデルは範囲を定めた分類・抽出・要約などで検討しやすくなります。ただし、精度は規模だけで決まらず、学習内容や業務データ、使う道具、評価条件にも左右されます。
次の表は導入時の比較項目です。SLMは端末専用、LLMはクラウド専用という区分ではなく、必要な計算資源を確保できれば、どちらも社内環境やクラウドで運用できます。
| 比較軸 | 小規模言語モデル | 大規模言語モデル |
|---|---|---|
| 得意な仕事 | 狭く定義した反復業務 | 幅広い対話、複雑な推論、未知の質問 |
| 実行場所 | PC・機器、社内サーバー、クラウド | 必要な計算資源を備えた社内・クラウド環境 |
| 応答 | 端末内処理では通信往復を減らせる | モデル規模と実行環境で変わる |
| データ | ローカルに置く場合もログ・ツール通信を確認 | 社内運用か外部APIかで管理方法が変わる |
| 費用 | 高頻度の定型処理で下げやすい | 低頻度の高度処理では合理的なこともある |
| 更新 | 自社配布かマネージド提供かで変わる | 自社配布かマネージド提供かで変わる |
| 主な弱点 | 広い知識や複雑な推論が不足しやすい | 計算費、遅延、データ管理が重くなりやすい |
簡単な分類は小型モデル、複雑な質問は大規模モデル、重要な承認は人というように、業務を分ける方法があります。AIエージェントの新規事業でも、各処理の品質と費用を合わせて検討します。
NVIDIA Researchに掲載された論考も、反復的な処理と汎用対話でモデルを使い分ける考え方を示しています。これは研究者の提案で、すべての業務で費用削減を実証した結果ではありません。
結論として、モデルの大小は優劣ではなく役割分担です。業務を分解せず、「全部を安いSLMへ置き換える」と考えると失敗しやすくなります。
小規模言語モデル市場:調査の対象年と推計方法を確認する
市場予測は対象年と推計方法を確認し、自社の売上は顧客数・台数・契約単価から見積もります。 市場調査会社の公表値には大きな差があります。
Grand View Researchの公開概要では、2023年を約78億米ドル、2030年を約207億米ドル、2024〜2030年の年平均成長率を15.1%としています。将来分は同社による予測です。
一方、MarketsandMarketsの2025年3月公表レポートは、2025年を9.3億米ドル、2032年を54.5億米ドル、年平均成長率を28.7%としています。対象年、区分、算出方法が異なるため、この二つを足したり、連続する市場成長として結んだりしないようにします。
公開概要だけから、差の全額をサービス範囲の違いで説明することもできません。
事業計画では、単一の市場規模を売上目標へ掛けない方が安全です。対象を「モデル提供」「導入支援」「端末組み込み」「業務アプリ」に分けます。
そのうえで、顧客数、1社当たりの端末数、更新料、運用料から積み上げます。
MarketsandMarketsは、学習・調整、独自モデル開発、統合・導入などのサービスも区分しています。自社の売上計画では、市場全体の一定割合を獲得すると置くより、顧客の業務、導入台数、契約単価、更新・保守費から見積もるほうが、営業先と必要体制を具体化できます。
SLMが伸びる理由は、費用・遅延・データ管理の三つ
SLMを検討する理由は、費用、待ち時間、データの置き場所です。三つとも実際の構成で確かめます。
一つ目は費用です。というのも、AIエージェントは、一つの業務で分類、検索、情報抽出、確認、ツール実行を何度も繰り返すからです。
そのため、すべてを高価なモデルへ送ると、利用量が増えるほど費用も増えます。逆に、狭い仕事をSLMへ移せれば、上位モデルを使う回数を減らせます。
二つ目は遅延です。たとえば、製造装置、車両、店舗、スマートフォンでは、通信往復の待ち時間が使い勝手を左右します。
その点、端末内で処理すれば、通信品質に左右されにくくなります。エッジAIの実装と同じく、モデルだけでなく端末性能と通信条件を一緒に見ます。
実際、GoogleのGemma 3nやMetaのLlama 3.2は、端末やエッジで動かす用途を明確に打ち出しています。
三つ目はデータ管理です。たとえば、顧客情報、契約、設計、医療、災害対応などでは、入力を外部へ送れる範囲が限られます。
その点、端末や社内サーバーで処理できれば、送信範囲を小さくできます。
ただし、端末内だから安全とは限りません。むしろ、端末の紛失、モデルの持ち出し、古いモデルの残存、入力ログの保管といった新しい管理が増えます。
つまり、「外へ送らない」と「安全に運用できる」は別の条件です。
小規模言語モデルの業界構造は5層に分かれる
モデル開発以外にも、業務特化、実行基盤、振り分け・監視、業務アプリが事業の候補です。 SLMの事業は、モデルを作る会社だけでは完結しません。
業界を五つの層に分けると、自社が入れる場所を見つけやすくなります。
第一層はモデル開発です。Microsoft、Google、Meta、IBM、Mistral、NTT、楽天などが、軽量なモデルを作り、公開または商用提供します。
第二層は軽量化と特化です。具体的には、量子化、蒸留(大きなモデルの知識を小さなモデルへ移す手法)、追加学習によって、モデルを端末や業務へ合わせます。
そして、どのデータを学ばせ、元の能力を壊さないかが技術の中心です。
第三層は実行基盤です。具体的には、CPU、GPU、NPUへモデルを合わせ、速さ、メモリー、電力を調整します。
そして、llama.cpp、Ollama、vLLM、端末向けの開発基盤がこの層を支えます。
第四層は振り分けと監視です。具体的には、入力の難しさを判定し、SLM、LLM、人へ処理を振り分けます。
そのうえで、精度、費用、応答時間を継続して測ります。
第五層は業務アプリです。たとえば、保険文書、客室乗務員のレポート、災害対応、設備保全など、顧客が実際に使う仕事へ組み込みます。
RAGで社内文書を参照させる場合も、検索の正しさと回答の合否を別々に測る必要があります。
後発企業が第一層で汎用モデルをゼロから作ると、大きな資金と学習データが必要です。一方、第二層から第五層には、顧客の業務データ、端末、現場、販売網を持つ会社の機会があります。
Microsoft・Google・Meta・AppleはAIを端末へ移す
各社のモデルは、端末・入力条件・版・利用条件をそろえて評価します。 主要企業の戦い方を見ると、パラメータ数だけでなく、端末、開発基盤、配布方法が競争軸になっています。
| 企業 | 主なモデル・基盤 | 何を狙っているか | 導入側が見る点 |
|---|---|---|---|
| Microsoft | Phi-4-mini、Phi Silica | 小型モデルの推論、Windows端末、業務特化 | モデル配布、ライセンス、Windowsとの統合 |
| Gemma 3、Gemma 3n、Google AI Edge | 画像・音声を含む端末内AI | 対応端末、必要メモリー、開発ツール | |
| Meta | Llama 3.2 1B・3B、量子化モデル | モバイルとエッジへ開いたモデルを展開 | ライセンス、安全モデル、端末最適化 |
| Apple | Foundation Models、Core AI | 端末内とサーバー側モデルを共通APIで扱う | 対応OS・端末、用途制限、モデル更新 |
表のモデル名だけで優劣を決めず、対応するOS・端末と実際の入力条件をそろえて比較します。以下で各社の公表内容と、その数値を読む際の条件を確認します。
MicrosoftはPhiを小さな推論役へ置く
Microsoft ResearchのPhi-4-Mini技術レポートでは、38億パラメータのモデルを紹介しています。数学やコードなど質を重視したデータで学習したモデルの例であり、業務導入では日本語の入力や実際の書式を使って評価します。
Windows向けのPhi Silicaの透明性ノート(2026年6月更新)は、Copilot+ PCのNPUに加え、条件を満たす非Copilot+ PCではGPUで動く構成を説明しています。GPUでの速度、電力、発熱、必要メモリーは機種や同時実行アプリの影響を受けるため、実機での試験が必要です。
GoogleはGemma 3nで画像・音声も端末内へ運ぶ
GoogleのGemma 3n(2025年6月公開)は、文章・画像・音声・動画を入力し、文章を出力するモデルです。E2BとE4Bの総パラメータ数はそれぞれ5Bと8Bですが、実効サイズは2B・4B相当と説明しています。
実効サイズだけをメモリー容量へ換算せず、実行環境、入力の長さ、量子化条件と合わせて確認します。
端末向けの実行にはGoogle AI Edgeなどの環境を使えますが、使える入力形式や機能は実装によって異なります。業務でRAGやツール呼び出しを組み合わせる場合も、検索先や呼び出すサービスまで端末内にあるかを確認します。
MetaはLlama 3.2の1B・3Bを広い端末へ対応させる
Metaは2024年10月、Llama 3.2の1B・3B量子化モデルについて、BF16形式の元モデルに対し、モデルサイズを平均56%、メモリー使用量を平均41%減らしたと報告しました。AndroidのOnePlus 12を使う同社の検証値で、あらゆる端末で同じ効果が出る数値ではありません。
この発表では、Arm CPU上での実行を中心に最適化し、量子化モデルでは8Kまでの短い入力を優先しています。導入側も、日本語精度、入力の長さ、実行環境、利用条件を合わせ、容量削減と品質の両方を測ります。
Appleは端末内モデルをアプリ機能として開放する
AppleのFoundation Modelsは、アプリからモデルを利用するための開発基盤です。2025年の技術紹介は約3Bの端末内モデルへのアクセスを説明し、2026年のモデル発表では端末向けとサーバー向けの複数モデルを紹介しています。
さらに2026年6月の開発者向け更新では、共通の仕組みから端末内モデル、Private Cloud Compute、対応する他社モデルを扱う方法が追加されています。「Foundation Modelsを使う=すべて端末内」とは限らないため、実際に選ぶモデルと送信先を確認します。
OS更新でモデルが変わる際には、同じ業務テストで再評価します。
IBM・Mistral・NTT・楽天は企業運用と業務特化を狙う
総パラメータ数と稼働数を分け、日本語業務、同時利用数、必要メモリーを実機で確認します。 次の四社は、企業の仕事、端末、社内環境、日本語への適合を前面に出しています。
IBMはGranite 4.0で長い入力と同時処理を軽くする
IBMの2025年10月のGranite 4.0発表では、MambaとTransformerを組み合わせるHシリーズを紹介しています。H-Tinyは総数7B・稼働1B、H-Smallは総数32B・稼働9Bです。
3BのH-Microに加え、通常のTransformer構造を使う3BのMicroもあり、シリーズ全体が同じ構造ではありません。
同社は長い入力や同時処理時のメモリー効率を重視しています。比較では重みを読み込む容量だけでなく、入力の長さ、同時利用数、実行方式をそろえます。
また、モデルの署名は配布物の真正性を確認する手段であり、業務回答の正確さは別途検証が必要です。
Mistralは端末とAIエージェントの両方へ軽量モデルを置く
Mistral AIの公式モデル一覧には、Ministral 3の3B・8B・14Bがあり、文章と画像を扱うローカル展開向けモデルとして紹介されています。端末の容量と用途に合わせて選び、モデル名だけで実機の速度や対応機能を決めつけないようにします。
同社は、小型モデルを単独の対話AIとしてだけでなく、大きなモデルの間で実務を処理する役として位置付けています。翻訳、ローカル分析、通信なしの支援、ロボットなど、応答の速さと情報の置き場所が重要な仕事が対象です。
NTTはtsuzumi 2を社内運用と日本語業務へ合わせる
NTTのtsuzumi 2(2025年10月公開)は、1GPUでの動作を想定したモデルです。公式説明では40GB以下のメモリーを持つGPUでの運用を想定し、文書への質問応答、情報抽出・要約、金融・自治体・医療の知識を強化しています。
どのGPUでも同じ速度で動くという意味ではありません。
自社運用が費用面で有利になるかは、処理量、機器の稼働率、保守、人の確認時間によります。機微な情報を扱う業務では、日本語での品質に加えて、情報の置き場所と運用費を合わせて比較します。
楽天は1.5Bの日本語SLMを開いたモデルとして提供する
Rakuten AI 2.0 mini(2025年2月公開)は15億パラメータのモデルで、日本語・英語のデータを使い一から学習しています。同時発表された大規模なRakuten AI 2.0とは別のモデルです。
Apache 2.0ライセンスで公開されており、要約、質問応答、文章理解、対話システムの基盤に利用できます。日本企業にとっては、日本語モデルを作るだけでなく、公開して開発者を増やすことが競争軸になる例です。
JALのSLM実証事例:4名の検証でレポート作成時間を最大3分の1に
JALの最大3分の1は、4名・丸1日の実証で得た効果です。自社でも確認・修正まで測って対象を広げます。
通信が不安定な機内で、客室乗務員から地上スタッフへの引き継ぎレポートを作ることが、この事例の対象です。JAL、富士通、ヘッドウォータースは、端末内で動く業務特化型生成AIを実証しました。
2025年3月の共同発表では、MicrosoftのPhiをJALの過去レポートで業務特化し、タブレットでチャット形式の入力からレポートを作る試作アプリを検証しています。富士通がモデルの調整、ヘッドウォータースがアプリと量子化による軽量化などを担いました。
2025年10月の富士通の事例紹介によると、リーダークラスの客室乗務員4名を対象に丸1日の実証を行い、作成時間を最大3分の1に短縮しました。これは限られた実証条件での最大効果で、全乗務員の平均や、飛行中の本番業務全体で確定した削減率ではありません。
同紹介時点では、対象レポートと利用者を広げる次の段階に進んでいます。
参入検討への示唆は、モデル単体ではなく、通信条件、入力手順、業務用語、書式、人の修正を一組で試すことです。自社で効果を測る際は、作成時間だけでなく、確認・修正、誤記、対象外のケースも含め、実際の利用者と件数を増やして再評価します。
災害対応と保険業務でも、外へ出せない情報を扱う
閉域とオフラインは別の条件です。実証の環境と品質指標を確認し、本番の判断手順を設計します。
三井不動産と日立は、2026年4月15日にオフライン型災害対策支援システムの開発・検証開始を発表しました。対象は約200棟のオフィスビルを統括する危機管理センターです。
「200棟へAIを本番導入済み」という意味ではなく、センターの管轄規模を示す数字です。
三井不動産がマニュアルや現場知識、要件定義・評価を担い、日立が業務特化モデルとシステムを実装します。AIは被災状況に応じた対応案と参照元を示し、センター員の判断を支援する構成です。
通信障害に備える目的の実証で、災害時の効果が確定した本番実績とは分けて読みます。
NTTデータの2025年3月の保険業務検証では、当時のtsuzumiを使い、参照文書に基づく質問応答、営業情報の抽出、社内知識への回答を評価しました。実験はAzure上の閉じた環境で実施しています。
閉域運用は必ずしも社内設置や完全オフラインを意味しません。
同検証の質問応答では、タスクに合わせた学習によって評価スコアが改善しました。一方、継続事前学習を追加した効果は、評価指標によって異なります。
結果を次の表に示します。
| 指標 | 追加学習なし | タスク特化学習のみ | 継続事前学習+タスク特化 |
|---|---|---|---|
| 参照情報への忠実さ | 0.32 ± 0.033 | 0.79 ± 0.031 | 0.85 ± 0.025 |
| 正解との一致度 | 0.32 ± 0.014 | 0.65 ± 0.020 | 0.63 ± 0.020 |
出典:NTTデータ(2025年3月18日)。RAGAS v0.1によるFaithfulnessとAnswer Correctnessのスコアで、±は標準誤差です。利用者の正答率や保険業務全体の成功率ではありません。二つの指標を分け、追加学習がどの品質へ効いたかを見ます。
この結果からは、文書を追加で学習させることと、業務の回答が改善することを分けて測る必要性が分かります。正答例だけでなく、根拠のない質問や回答を控えるべき入力も評価へ入れます。
JAL・災害対応・保険の三事例を参考にする際も、実証条件と本番で必要な品質を別々に確認します。
自社はSLMのどこへ入れるか
データ、端末、AI運用、閉域保守から近い入口を確認します。
NEXT STEP
次のステップ
AI技術を、現場で使い続けられる事業へ。
対象業務、実行場所、評価、端末、更新、例外処理、提携先を整理し、自社の参入余地を設計します。
SLMで考えられる4つの新規事業
業務特化、端末組み込み、振り分け、閉域運用から、顧客が継続して費用を払う機能を選びます。 新規参入の候補には、業務特化と評価、端末への組み込み、モデルの振り分け、閉域運用があります。
顧客の仕事と制約に合う領域を選び、モデル提供だけでは不足する機能を事業として検討します。
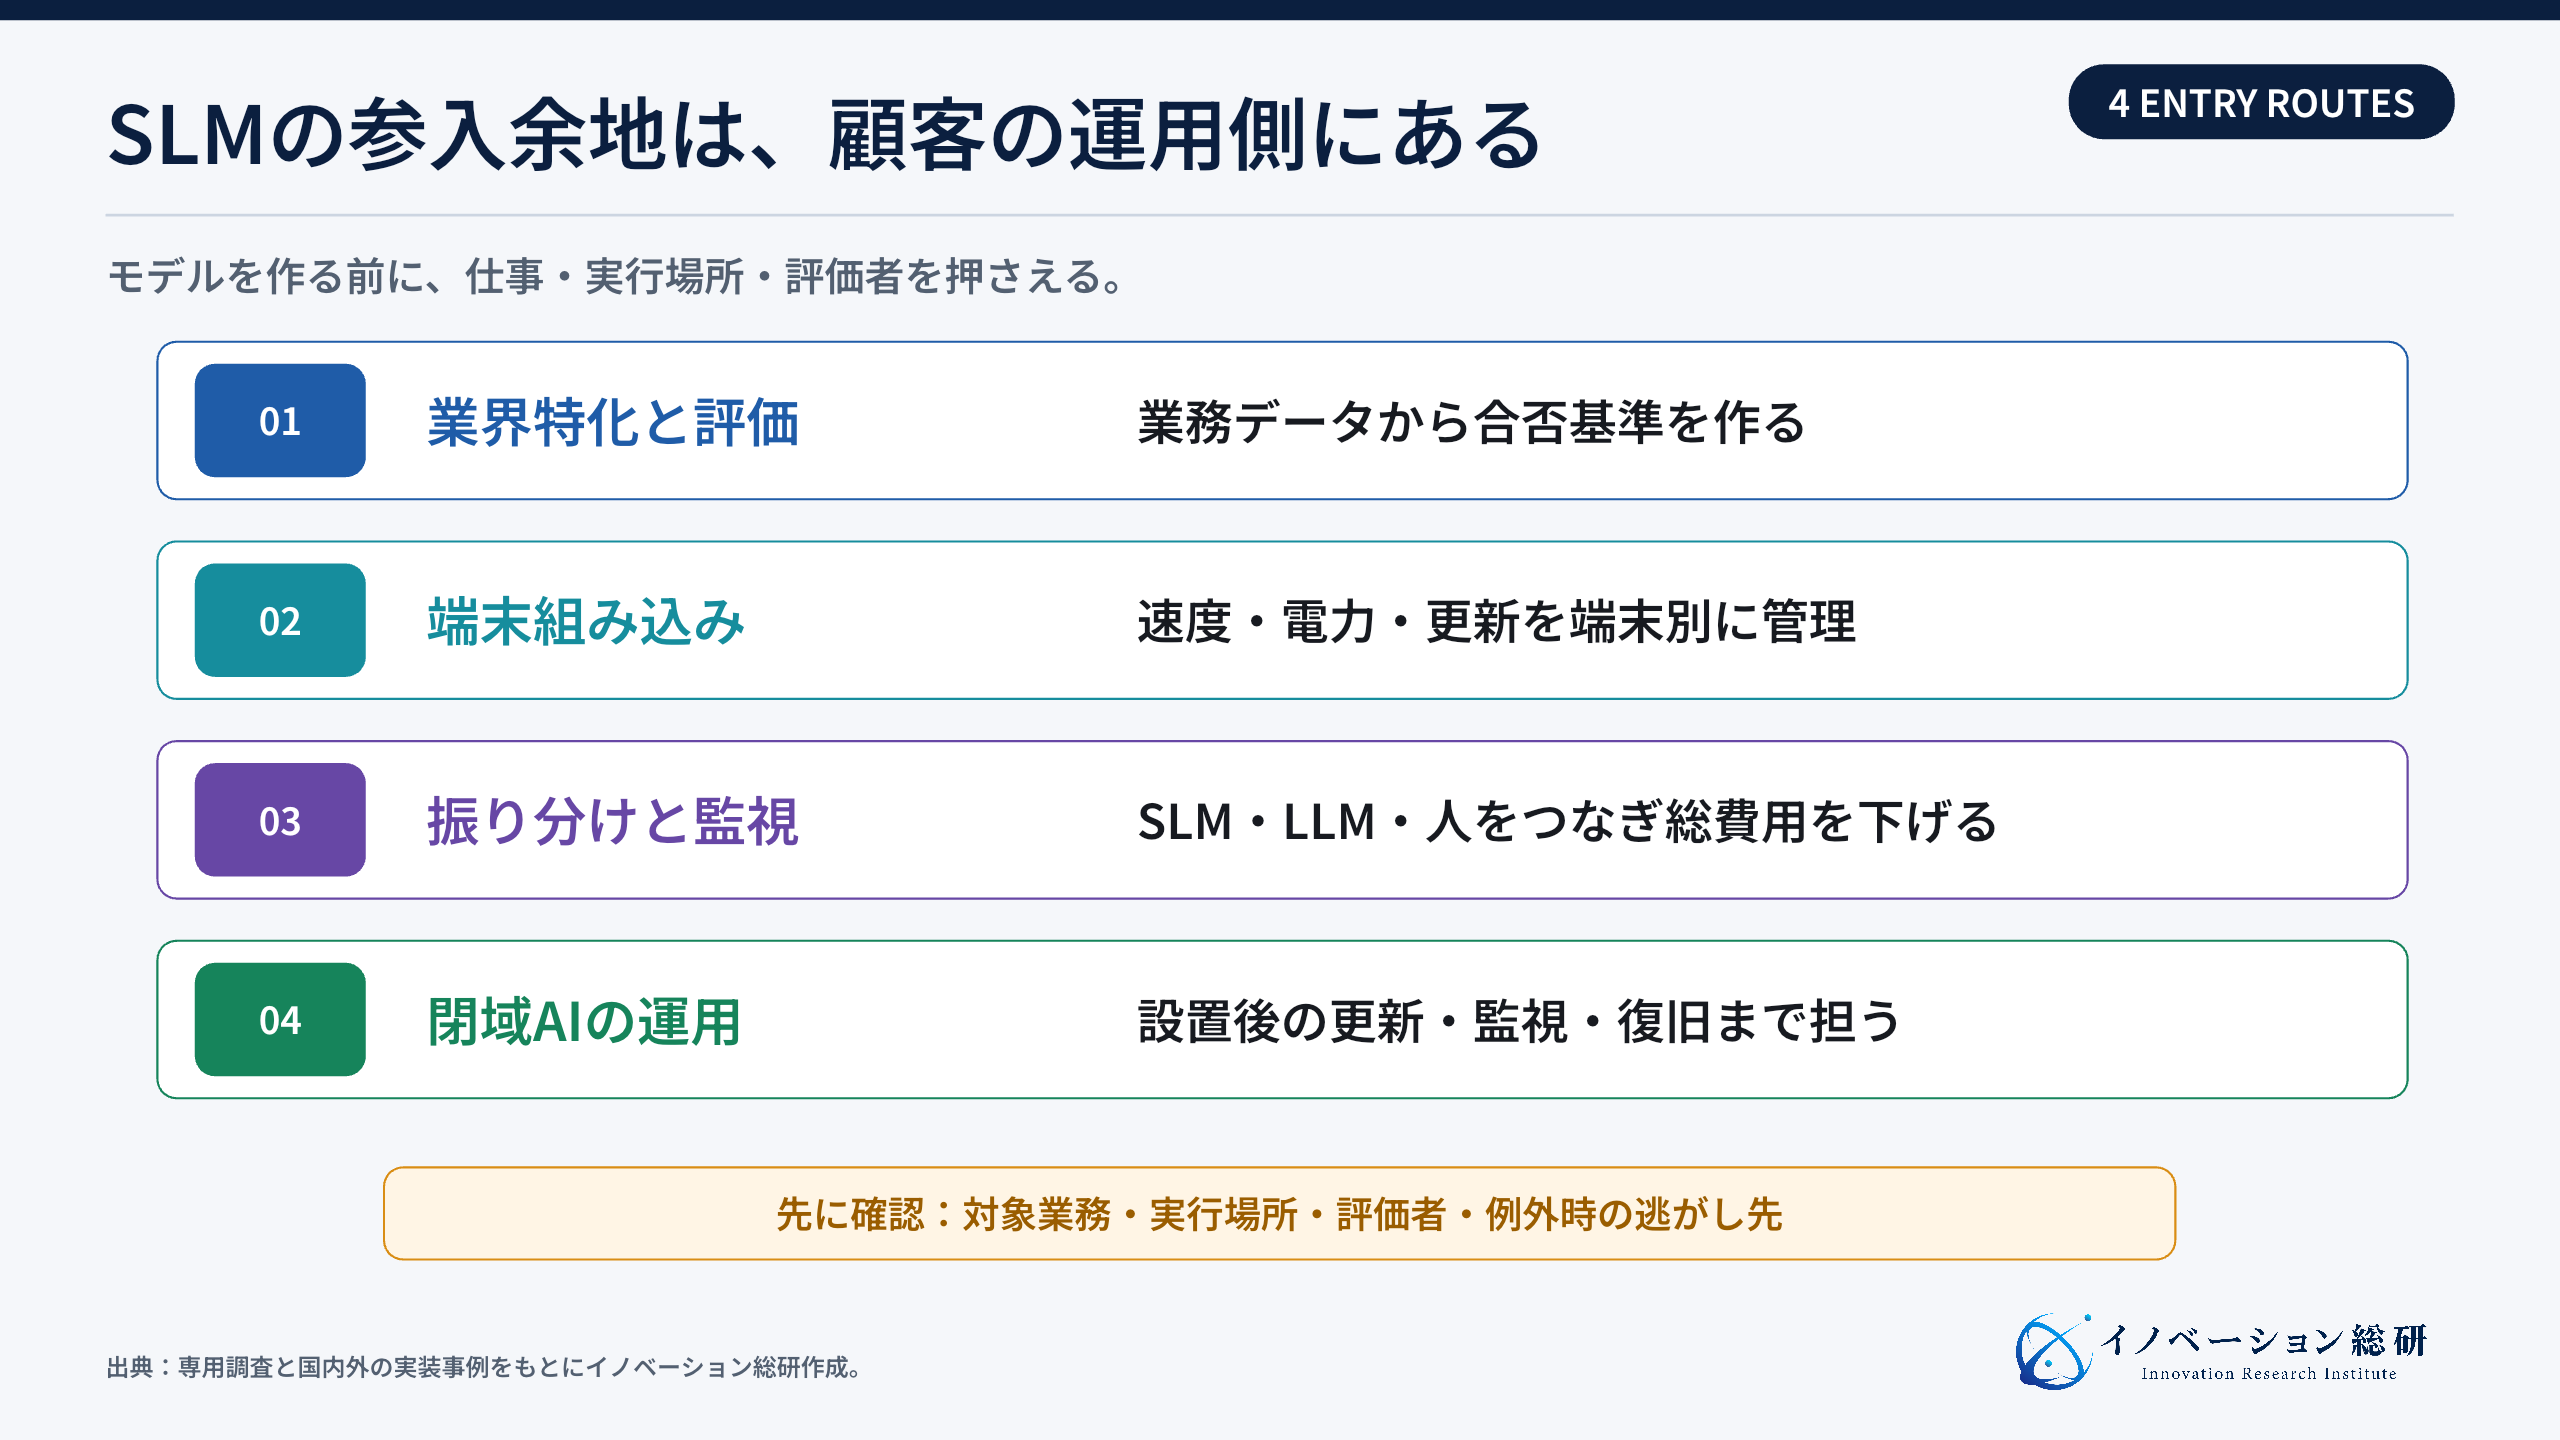
次の表では、最初に接点を持てる顧客と、自社の資産に近い行を選びます。最後の列は、参入前の検証項目です。
| 参入方法 | 最初の顧客 | 提供する価値 | 必要な資産・提携先 | 最初に確かめる証拠 |
|---|---|---|---|---|
| 業界特化モデルと評価 | 金融、保険、法務、製造、公共 | 用語と書式に合う抽出・分類・回答 | 顧客データ、専門家、評価設計、モデル提供企業 | 現場データでの正答率、修正率、例外率 |
| オンデバイス組み込み | 端末、機器、車両、アプリの会社 | 通信なしで速く処理し、データを端末に残す | 半導体、OS、端末メーカー、実行基盤 | 対象端末での速度、電力、メモリー、発熱 |
| モデル振り分けと監視 | AIエージェントや大量処理を運用する会社 | 簡単な処理をSLMへ移し、総費用を下げる | LLM接続、ログ、評価器、運用監視 | 品質を保ったまま減らせる上位モデル呼び出し数 |
| 閉域AIの導入・運用 | 外部送信を制限する企業・自治体 | 社内や施設内で生成AIを継続運用する | サーバー、認証、更新、保守、セキュリティ | データ境界、更新方法、障害時の復旧時間 |
入口を選んだら、現場の評価データと運用担当を確保します。モデルの動作だけでなく、顧客が費用を払う品質を示せるかが、事業化に進む判断材料になります。
業界特化モデルは、データ量より評価の質が壁になる
業界特化では、過去文書を集めるだけでなく、正しい回答、誤りやすい入力、回答してはいけない条件を整理します。専門家が合否を判定し、学習に使うデータと、効果を測る未使用の評価データを分けます。
NTTデータの事例では、参照情報への忠実さと、正解との一致で結果が異なりました。業務で何を改善したいかを決め、回答形式、根拠、抽出漏れ、人が直す時間を別々に測ることが、追加学習への投資判断に役立ちます。
端末組み込みでは、配布・更新・保守まで事業範囲を決める
端末へ組み込むと、通信費と遅延を減らせます。一方、端末の種類、OS、メモリー、電池、発熱へ合わせる必要があります。
AIスマホのように端末上でAIを動かす製品では、モデルの能力だけでなく、電池消費と更新方法が利用体験を左右します。販売後は、モデル、安全ルール、業務知識を更新します。
収益モデルとしては、初期開発に加え、端末台数に応じた利用料、更新、監視、保守を検討できます。ただし、継続課金が成立するには、その期間に必要な更新と障害対応を顧客が評価し、提供費用を上回る対価を払うことが条件です。
振り分け事業は、費用削減と品質維持を同時に証明する
AIエージェントでは、情報抽出、JSONへの変換、問い合わせ分類など、狭い処理が何度も発生します。そこをSLMへ移し、難しい入力だけをLLMや人へ送ります。
振り分けの効果は、同じ業務品質を保ったときの費用、応答時間、人の確認量で測ります。モデル自身の自信だけを基準にせず、書式チェック、検索根拠、過去の評価結果などを組み合わせ、判断できない入力を人へ回す条件を決めます。
閉域運用は、設置後の保守責任まで商品にする
社内や専用のクラウド環境で運用する場合は、モデルの置き場所に加え、検索先、ログ、外部ツール、保守通信の経路を確認します。閉域を求める顧客には、利用データが通る範囲を構成図と契約で合わせます。
参入企業は、モデルを設置して終わりにせず、脆弱性への対応、モデルの更新、品質の再評価、障害復旧をサービスへ含めます。閉域性そのものより、閉じた環境でも古くならない運用を売ることが重要です。
導入費用は、API料金だけで比べない
API単価ではなく、運用・例外処理・人の確認を含む一件当たり費用で比べます。 SLMの自社運用では、API料金の代わりに、端末・サーバー、開発、評価、更新、監視の費用を負担します。
さらに、人が出力を確認・修正する時間と、例外時に大規模モデルを使う費用を加えて比較します。
比較するときは、一件当たりの総費用を出します。たとえば、年間の処理回数が少なく、質問の種類が広いなら、クラウドLLMを使う方が安い場合があります。
逆に、処理回数が多く、仕事が定型で、端末や社内に置く理由が強いほど、SLMが合いやすくなります。
費用表には、次の項目を入れます。
- 初期のモデル選定、業務設計、端末最適化
- 学習データと評価データの作成
- サーバー、端末、電力、保守
- モデルとアプリの更新・再評価
- 誤りを人が直す時間と、業務停止の損失
- LLMや人へ切り替える例外処理
モデルの単価が下がっても、確認時間が増えれば総費用は上がります。現行方式とSLM方式に同じ業務データを使い、合格率、確認時間、例外率、月額固定費をそろえて比較します。
人の確認時間で費用が逆転する架空例
例えば月10万件を処理する業務で、外部APIの追加処理費を1件10円と仮定すると月100万円です。SLMへ移し、固定の運用費が月40万円、例外1万件だけに同じAPIを使えば追加10万円で、モデル運用部分は月50万円になります。
これは説明用の仮定で、特定サービスの料金や導入実績ではありません。
ところが、現行方式に比べて1件当たり平均12秒の確認・修正が増えるなら、月約333時間が追加で必要です。作業時間の費用を3,000円/時と仮定すると月100万円が加わり、合計は月150万円になります。
同じ業務品質を保つための追加作業まで含めると、API利用を減らしても月50万円高くなります。
削減した時間を別業務へ回せることと、支出が減ることも分けて見積もります。実際の比較では、既存の確認作業、初期開発、端末購入、再学習、障害対応などを同じ範囲で計上し、処理量と例外率が変わった場合も確認します。
小規模言語モデル導入で決める責任分界と見送り条件
更新、データ権限、誤回答への対応を分担し、処理できない場合は人へ回すか停止します。 SLMは、端末や社内に置きやすい一方、顧客側の責任も増やします。
導入前に、モデル会社、開発会社、端末会社、利用企業、人の役割を分けます。
役割分担は契約と構成で決まります。モデル提供者には利用条件・既知の制約、開発会社には接続・テスト・監視、端末の担当には対応機種・更新・故障対応を確認します。
利用企業はデータ権限、業務ルール、最終承認、人へ切り替える手順を決めます。
次の条件に当てはまる場合は、SLMを主役にしない方がよいでしょう。
- 質問の範囲を狭く定義できず、広い世界知識が必要
- 間違いの影響が大きいのに、人の確認や停止機能を置けない
- 端末ごとの更新と回収を管理できない
- 現場データで精度を測る担当者と評価基準がない
- 処理量が少なく、自社運用の固定費を回収できない
- 処理できない入力を人へ回すか、安全に停止する手順がない
導入の判断では、対象業務を定め、現場の品質を測り、処理できない入力を人へ回すか安全に停止できることを確かめます。外部送信を禁止する業務では、例外処理だけを無断でクラウドへ送らない構成にします。
小規模言語モデルに関するよくある質問
モデルの規模、精度、データ管理、導入条件について、よくある疑問を整理します。
本記事のまとめ|SLMは小ささより使う場所で選ぶ
SLMの価値は、小ささだけでなく、対象業務の品質を保ち、実行場所と総費用を最適化できるかで決まります。 小規模言語モデルは、比較的小さな計算資源で言語処理を担うモデルです。
端末、社内、クラウドのどこで動かすかは別の選択であり、業務の品質とデータの経路を合わせて設計します。
Microsoft、Google、Meta、Appleは、モデルとOS・端末・開発環境を結び付けています。IBM、Mistral、NTT、楽天は、企業運用、エッジ、業務特化、日本語といった条件に応えています。
JALの最大3分の1は少人数の実証結果、三井不動産・日立は開発・検証の発表、NTTデータは業務データを使ったモデル評価です。各事例の条件を自社へ置き換え、確認・修正を含む効果を測ってから対象を広げます。
新規事業の入口は、汎用モデルの開発だけではありません。業界特化、端末組み込み、モデル振り分け、閉域運用に機会があります。
自社が持つデータ、端末、顧客接点、保守網を起点に、どの仕事をどこで動かすかから設計してください。
参照した主な情報
仕様と事例は以下の公式情報、市場予測は調査会社の公開概要に基づいています。事業上の示唆と架空例は当研究所による整理です。
- Microsoft:Phi-4-Mini技術レポート
- Microsoft:Phi Silicaの仕様・制約(2026年6月)
- Google:Gemma 3n開発者向け説明
- Meta:量子化Llama 3.2の検証(2024年10月)
- Apple:2025年のモデル技術紹介
- Apple:2026年のモデル構成
- Apple:Foundation Modelsの更新
- IBM:Granite 4.0
- Mistral AI:公式モデル一覧
- NTT:tsuzumi 2
- 楽天:Rakuten AI 2.0 mini
- NVIDIA Research掲載論考:SLMとエージェント
- 富士通・ヘッドウォータース:JALとの共同実証(2025年3月)
- 富士通:JALの実証と展開計画(2025年10月)
- 三井不動産・日立:災害対策支援の開発・検証(2026年4月)
- NTTデータ:保険業務に特化したモデル検証(2025年3月)
- Grand View Research:SLM市場の公開概要
- MarketsandMarkets:SLM市場の公開概要
CONTACT
お問い合わせ
SLMの技術シーズを、運用で成立する事業へ。
対象業務、データ、端末、評価、更新、責任分界を一つの事業構造にし、参入・提携・待機・見送りを判断します。


