
投稿日:2026.09.08 最終更新日:2026.09.20
小規模言語モデル(SLM)はどこで使う?国内外10事例と参入余地
小規模言語モデルは、LLMより小さいだけなのか。
どの仕事を、どこで動かすと価値が出るのか。
結論は、狭い仕事と実行場所を合わせられるかです。国内外10事例と4つの参入方法から、SLMの導入・事業機会を整理します。
この記事の結論
小規模言語モデルは、狭く定義した仕事を端末や社内環境で動かすときに力を発揮します。
- SLMとLLMは優劣ではなく、仕事の難しさに応じて役割を分けます。
- 国内外の企業は、モデルだけでなくOS、端末、実行基盤、業務評価を組み合わせています。
- 参入余地は、業界特化、端末組み込み、振り分け・監視、閉域運用にあります。
生成AIを導入するとき、最も高性能なモデルを選べばよいとは限りません。定型文書の分類、端末内での要約、決まった形式への情報抽出まで、毎回大きなモデルへ送ると、費用と待ち時間が積み上がります。機密情報を外部へ送れない業務や、通信が止まる現場では、そもそもクラウド型の大規模言語モデルを使えないこともあります。
そこで注目されるのが、小規模言語モデルです。英語ではSmall Language Modelと呼び、SLMと略します。小さなモデルを端末や社内環境で動かし、狭い仕事へ合わせる考え方です。
ただし、SLMへ置き換えれば自動的に安く、安全になるわけではありません。モデルの精度、端末の性能、更新、監視、人が確認する範囲まで含めて設計する必要があります。この記事では、国内外のモデル8社と実装事例を読み解き、導入の選び方と4つの新規事業を整理します。
目次
小規模言語モデル(SLM)とは?「小さい」の基準は固定ではない
小規模言語モデルとは、文章を読み、理解し、生成する言語モデルのうち、大規模言語モデルより必要な計算資源を抑えたものです。Microsoftは、クラウド規模のLLMよりパラメータ数が少なく、端末内での実行へ最適化したモデルをSLMと説明しています。
パラメータは、モデルが学習で得た判断の重みです。数が多いほど必ず賢くなるわけではありません。しかし一般には、パラメータが増えると必要なメモリーと計算量も増えます。SLMは、扱う仕事を絞り、学習データを選び、量子化などでモデルを軽くします。
「何個以下ならSLM」という共通の境界はありません。数億から数十億パラメータのモデルが多いものの、会社や用途によって呼び方が違います。Appleは3Bの端末内モデルを「device-scale model」と説明します。IBMのGranite 4.0は、全パラメータ数と実際に動くパラメータ数が異なるモデルも含みます。
そのため、SLMかどうかを名前だけで判断しないことが大切です。見るべきなのは、対象の仕事、必要なメモリー、応答時間、端末、データの置き場所です。
LLMとの違いは、性能より仕事と実行場所で見る
LLMは、幅広い知識、複雑な推論、自由な対話を得意とします。SLMは、分類、抽出、要約、書式変換、決まった道具の呼び出しなど、範囲を狭く定めた仕事で使いやすいモデルです。
次の表は、一般的な違いです。すべてのモデルに当てはまる絶対的な区分ではありません。
| 比較軸 | 小規模言語モデル | 大規模言語モデル |
|---|---|---|
| 得意な仕事 | 狭く定義した反復業務 | 幅広い対話、複雑な推論、未知の質問 |
| 実行場所 | PC、スマートフォン、機器、社内サーバー | 主にクラウドや大規模な計算環境 |
| 応答 | 通信往復を減らしやすい | ネットワークと混雑の影響を受ける |
| データ | 端末や閉じた環境に残しやすい | 外部APIの契約と送信範囲を確認する |
| 費用 | 高頻度の定型処理で下げやすい | 低頻度の高度処理では合理的なこともある |
| 更新 | 配布先ごとの更新管理が必要 | 提供会社がモデルを更新することが多い |
| 主な弱点 | 広い知識や複雑な推論が不足しやすい | 計算費、遅延、データ管理が重くなりやすい |
実務では、どちらか一つに決める必要はありません。簡単な分類と情報抽出はSLMへ任せ、判断が難しい入力だけをLLMへ送る構成があります。AIエージェントの新規事業でも、この役割分担が費用と品質を左右します。NVIDIA Researchも、反復的で専門的な仕事にはSLMを使い、汎用的な対話が必要な場合は複数モデルを組み合わせる考え方を示しています。
結論として、モデルの大小は優劣ではなく役割分担です。業務を分解せず、「全部を安いSLMへ置き換える」と考えると失敗しやすくなります。
小規模言語モデル市場は、定義によって予測が大きく変わる
SLM市場は成長が予測されています。ただし、金額を読むときは注意が必要です。Grand View Researchは、2023年の世界市場を78億ドル、2030年を207億ドルと予測しています。2024年から2030年の年平均成長率は15.1%です。
一方、MarketsandMarketsは、2025年を9.3億ドル、2032年を54.5億ドルと予測しています。年平均成長率は28.7%です。二つの数字には大きな差があります。モデル本体だけを見るか、学習、導入、周辺サービスをどこまで含めるかが違うためです。
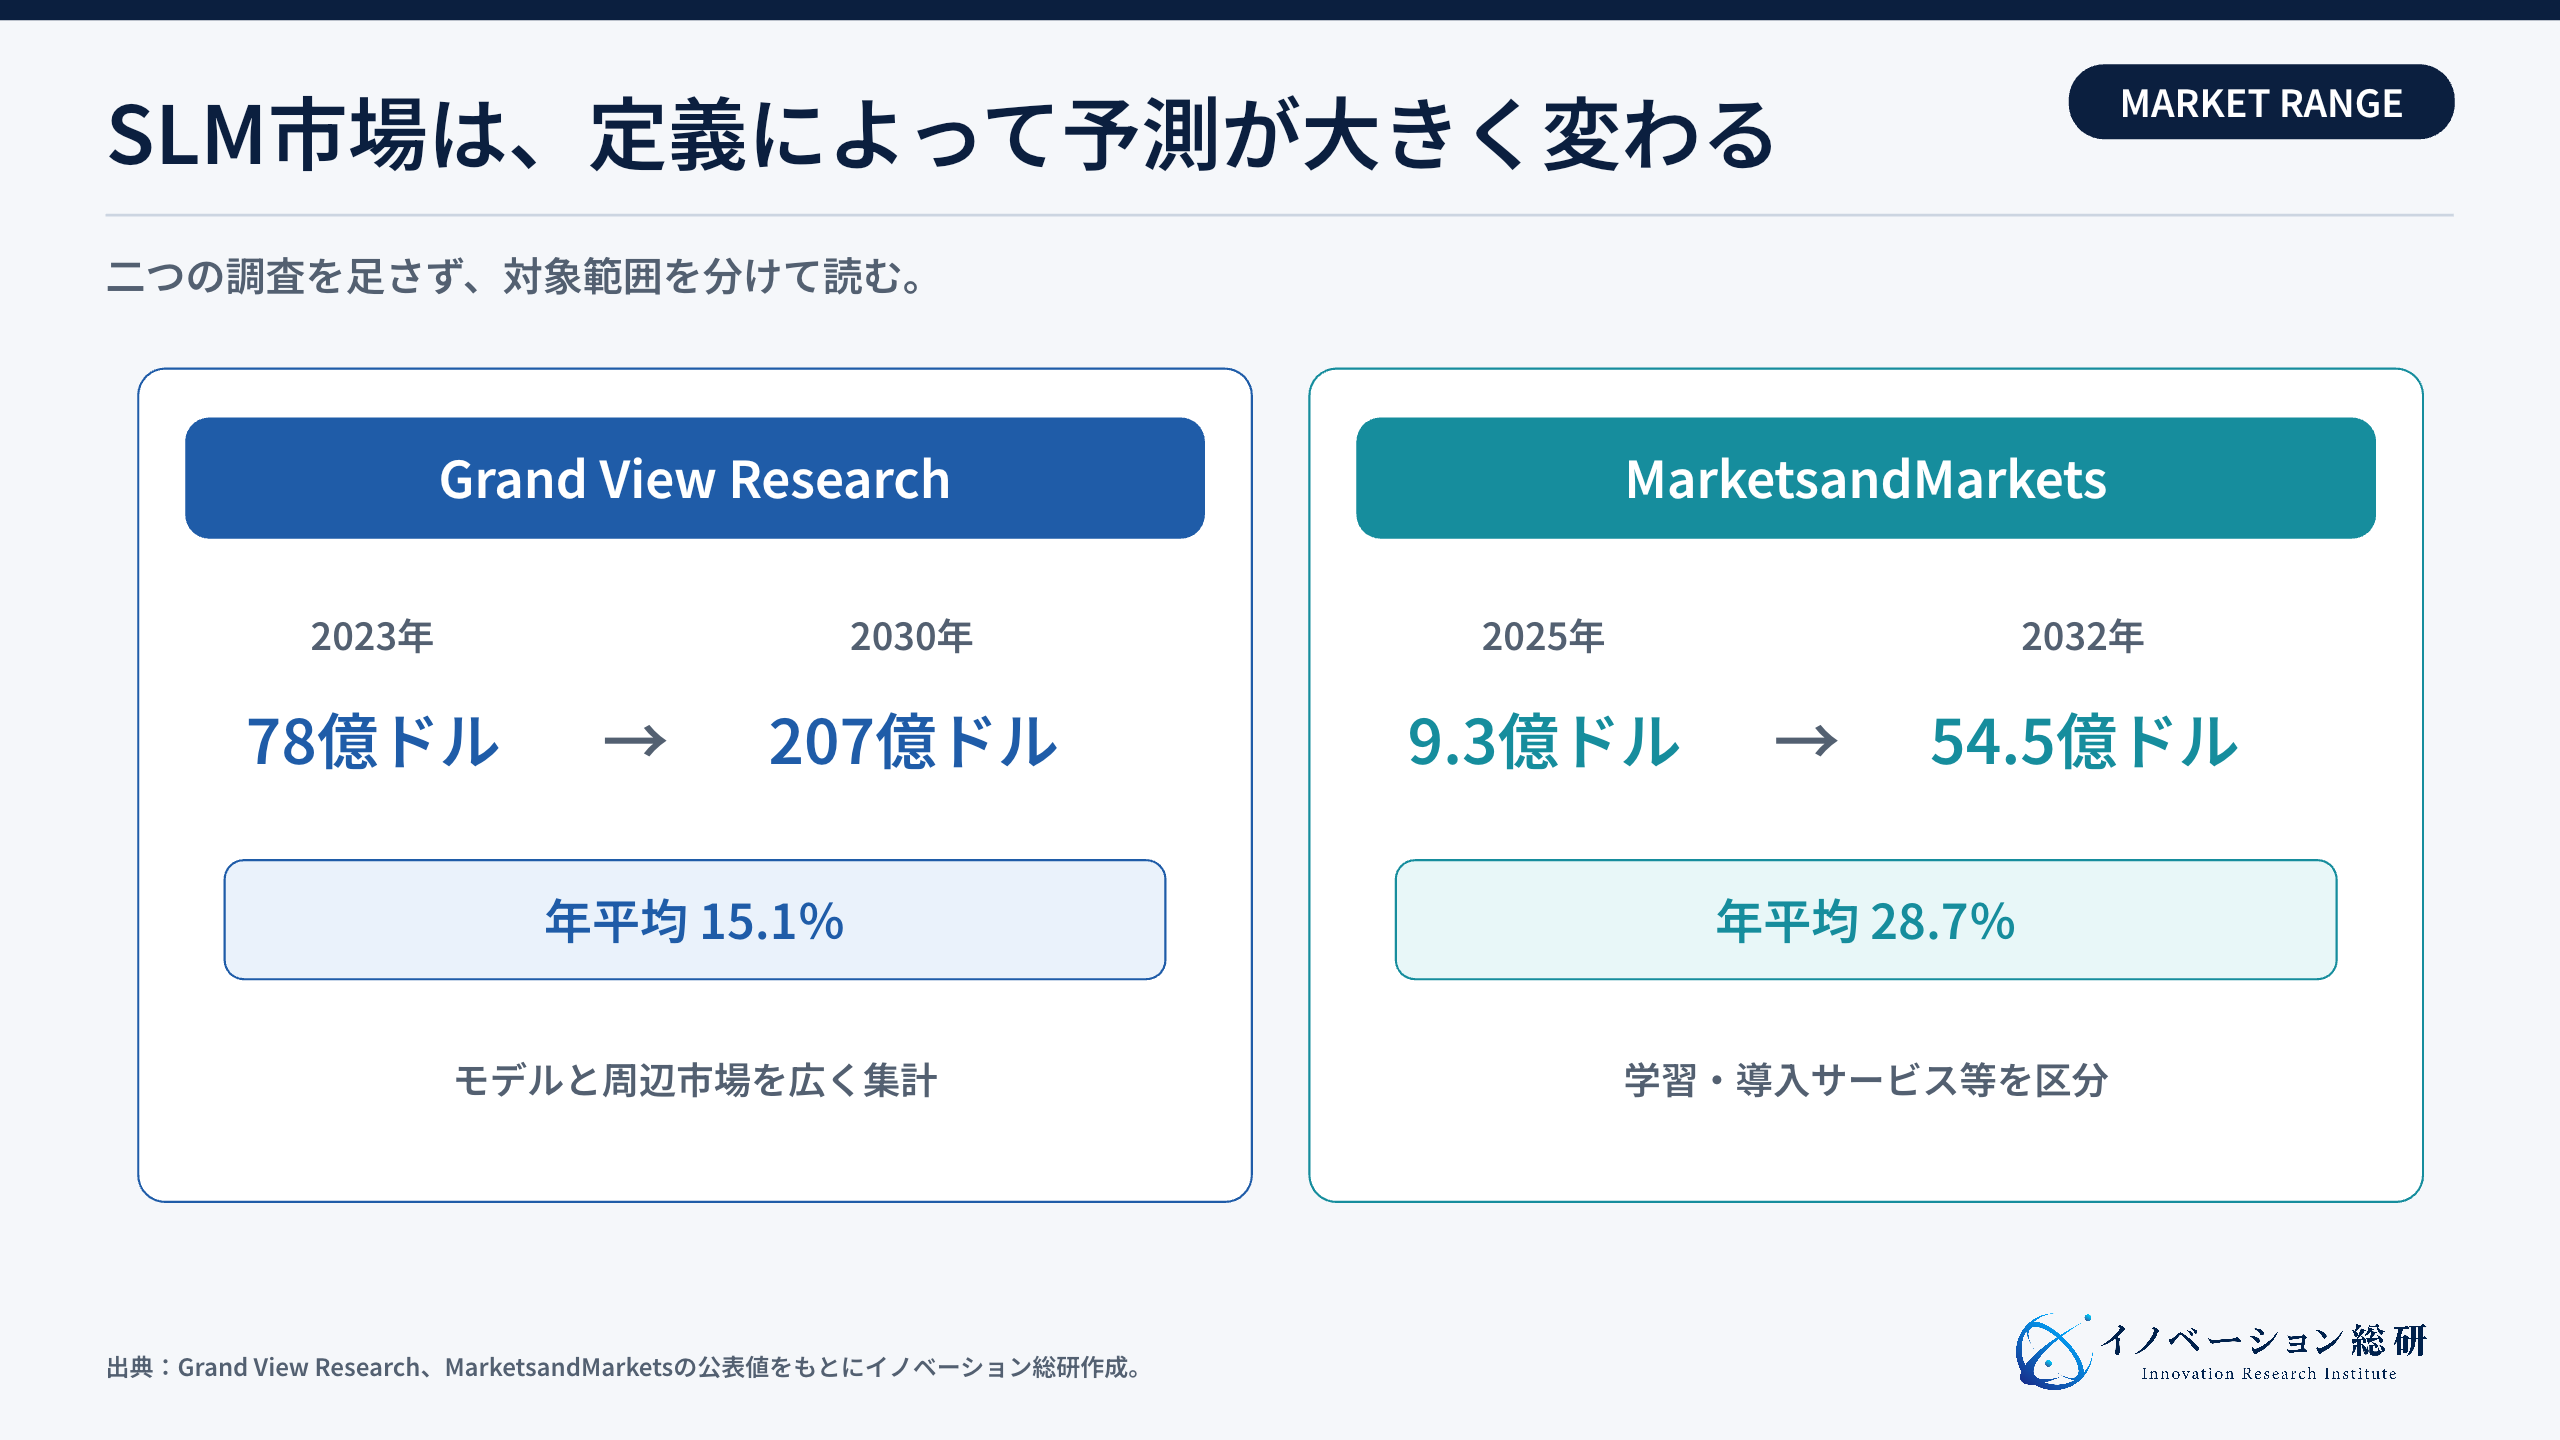
事業計画では、単一の市場規模を売上目標へ掛けない方が安全です。対象を「モデル提供」「導入支援」「端末組み込み」「業務アプリ」に分けます。そのうえで、顧客数、1社当たりの端末数、更新料、運用料から積み上げます。
市場予測から確実に読めるのは、モデルの軽量化だけが売上になるのではなく、統合・導入サービスの需要も大きいことです。MarketsandMarketsは、導入と展開のサービスが主要な提供領域になると説明しています。
SLMが伸びる理由は、費用・遅延・データ管理の三つ
一つ目は費用です。AIエージェントは、一つの業務で分類、検索、情報抽出、確認、ツール実行を何度も繰り返します。すべてを高価なモデルへ送ると、利用量が増えるほど費用も増えます。狭い仕事をSLMへ移せれば、上位モデルを使う回数を減らせます。
二つ目は遅延です。製造装置、車両、店舗、スマートフォンでは、通信往復の待ち時間が使い勝手を左右します。端末内で処理すれば、通信品質に左右されにくくなります。エッジAIの実装と同じく、モデルだけでなく端末性能と通信条件を一緒に見ます。GoogleのGemma 3nやMetaのLlama 3.2は、端末やエッジで動かす用途を明確に打ち出しています。
三つ目はデータ管理です。顧客情報、契約、設計、医療、災害対応などでは、入力を外部へ送れる範囲が限られます。端末や社内サーバーで処理できれば、送信範囲を小さくできます。
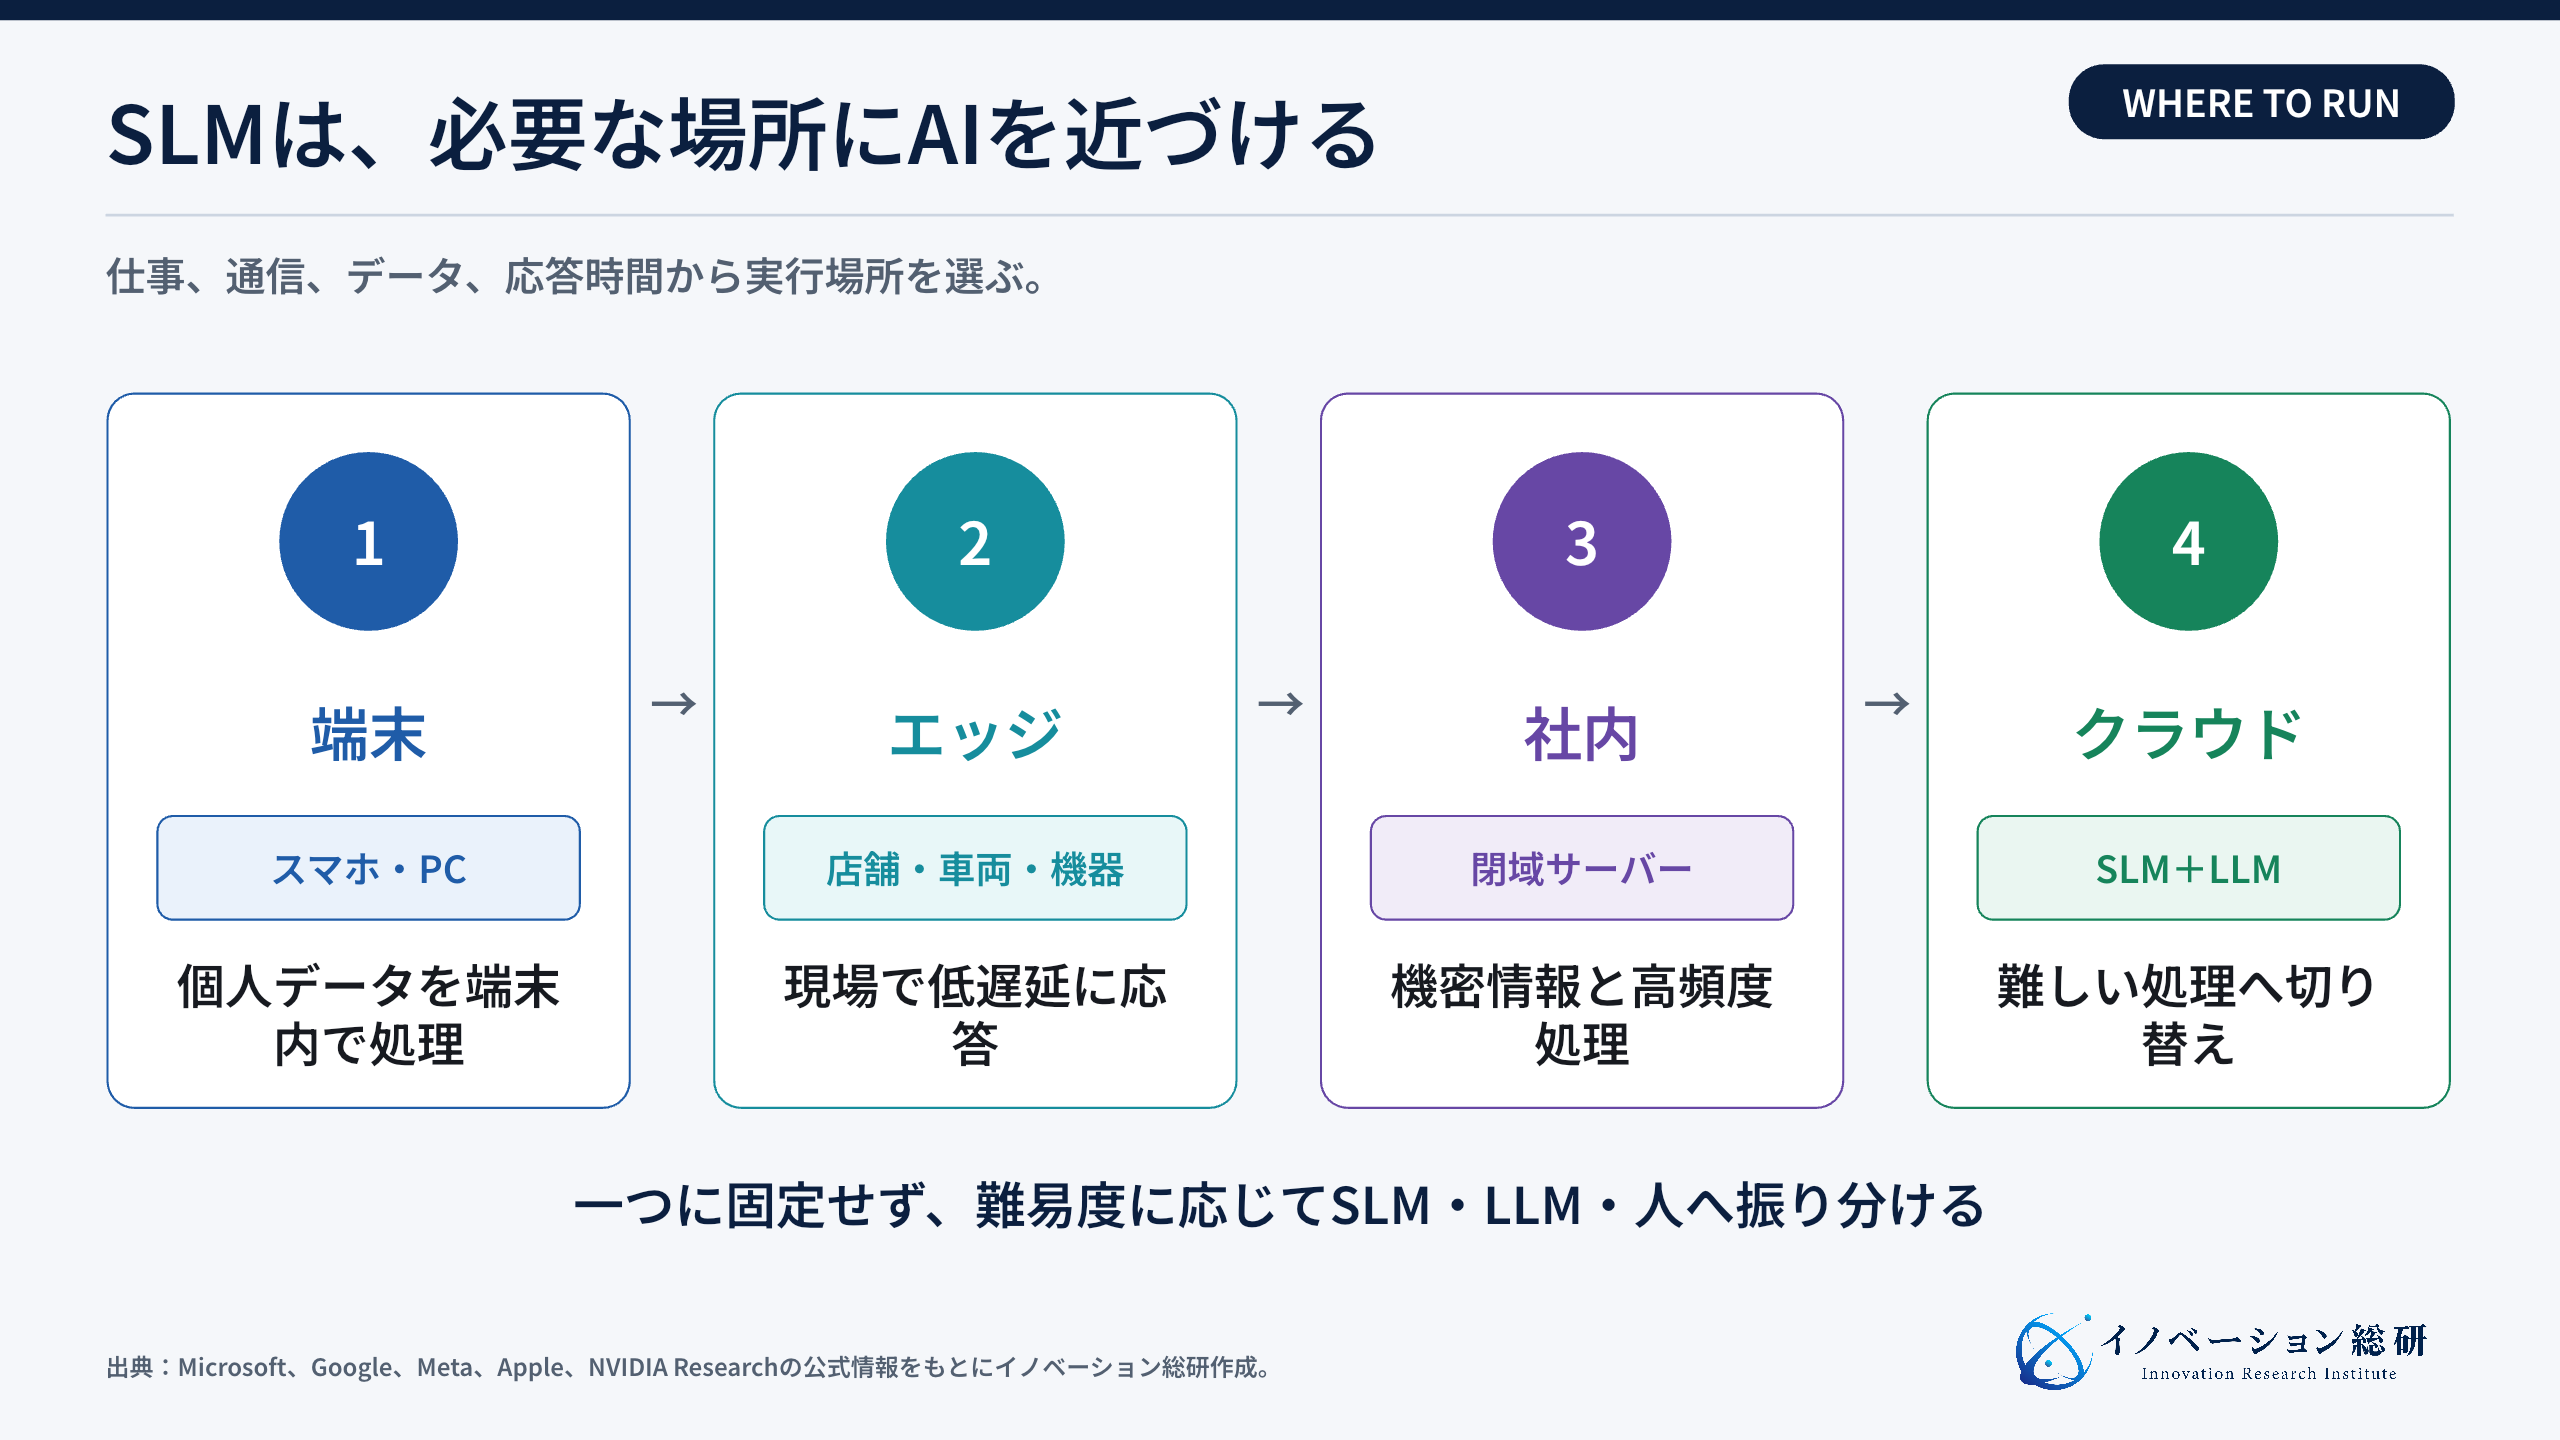
ただし、端末内だから安全とは限りません。端末の紛失、モデルの持ち出し、古いモデルの残存、入力ログの保管といった新しい管理が増えます。「外へ送らない」と「安全に運用できる」は別の条件です。
小規模言語モデルの業界構造は5層に分かれる
SLMの事業は、モデルを作る会社だけでは完結しません。業界を五つの層に分けると、自社が入れる場所を見つけやすくなります。
第一層はモデル開発です。Microsoft、Google、Meta、IBM、Mistral、NTT、楽天などが、軽量なモデルを作り、公開または商用提供します。
第二層は軽量化と特化です。量子化、蒸留、追加学習によって、モデルを端末や業務へ合わせます。どのデータを学ばせ、元の能力を壊さないかが技術の中心です。
第三層は実行基盤です。CPU、GPU、NPUへモデルを合わせ、速さ、メモリー、電力を調整します。llama.cpp、Ollama、vLLM、端末向けの開発基盤がこの層を支えます。
第四層は振り分けと監視です。入力の難しさを判定し、SLM、LLM、人へ処理を振り分けます。精度、費用、応答時間を継続して測ります。
第五層は業務アプリです。保険文書、客室乗務員のレポート、災害対応、設備保全など、顧客が実際に使う仕事へ組み込みます。RAGで社内文書を参照させる場合も、検索の正しさと回答の合否を別々に測る必要があります。
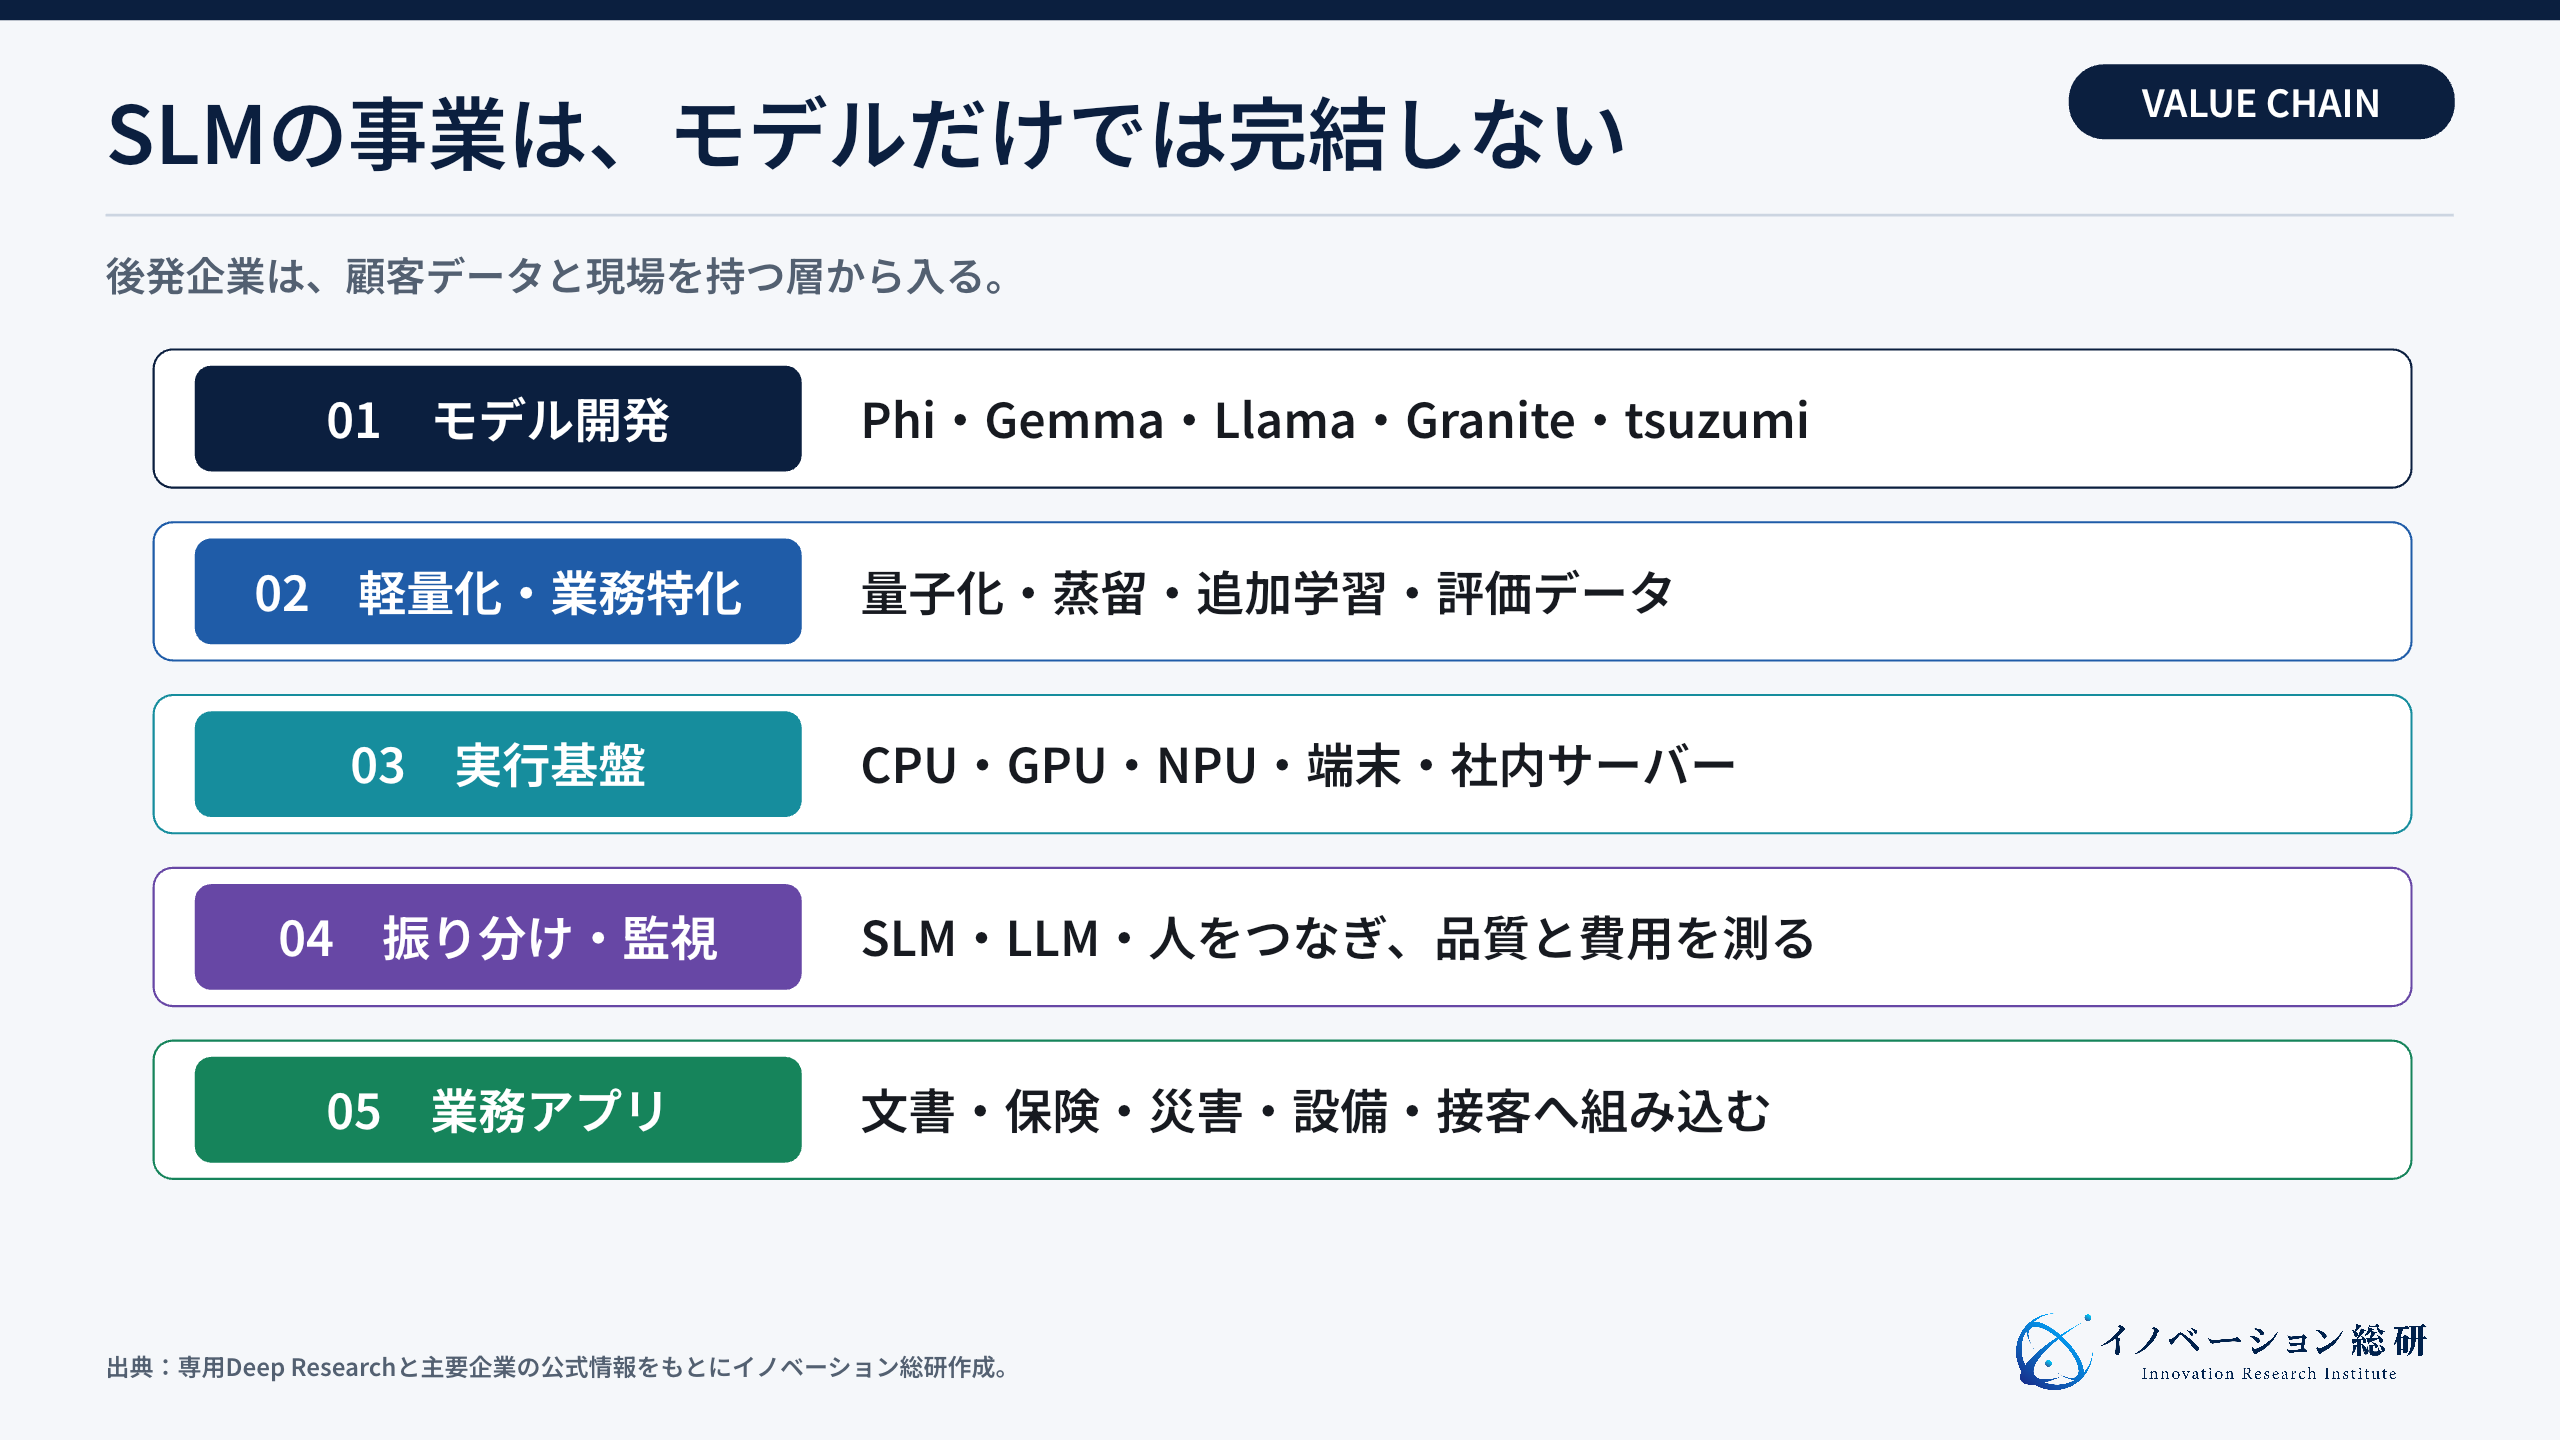
後発企業が第一層で汎用モデルをゼロから作ると、大きな資金と学習データが必要です。一方、第二層から第五層には、顧客の業務データ、端末、現場、販売網を持つ会社の機会があります。
Microsoft・Google・Meta・AppleはAIを端末へ移す
主要企業の戦い方を見ると、パラメータ数だけでなく、端末、開発基盤、配布方法が競争軸になっています。
| 企業 | 主なモデル・基盤 | 何を狙っているか | 導入側が見る点 |
|---|---|---|---|
| Microsoft | Phi-4-mini、Phi Silica | 小型モデルの推論、Windows端末、業務特化 | モデル配布、ライセンス、Windowsとの統合 |
| Gemma 3、Gemma 3n、Google AI Edge | 画像・音声を含む端末内AI | 対応端末、必要メモリー、開発ツール | |
| Meta | Llama 3.2 1B・3B、量子化モデル | モバイルとエッジへ開いたモデルを展開 | ライセンス、安全モデル、端末最適化 |
| Apple | Foundation Models、Core AI | OSに組み込んだ端末内AIと共通API | 対応OS・端末、用途制限、モデル更新 |
MicrosoftはPhiを小さな推論役へ置く
Microsoft ResearchのPhi-4-miniは38億パラメータです。数学やコードを含む高密度な学習データを使い、同規模のモデルで高い性能を狙っています。
Windowsでは、端末内推論へ調整したPhi Silicaも提供しています。Microsoftの動きは、モデルを公開するだけでなく、OS、開発環境、クラウドをつなぐものです。導入企業にとっては、モデルの精度だけでなく、端末へどう配り、どう更新するかまで選べます。
GoogleはGemma 3nで画像・音声も端末内へ運ぶ
GoogleのGemma 3nは、テキスト、画像、音声、動画を扱う端末向けモデルです。E2BとE4Bという二つの実効サイズがあり、端末のメモリーに合わせる設計を採っています。
Google AI Edgeは、RAGと関数呼び出しも端末上で試せるようにしています。カメラで見た物を説明する、音声を理解する、端末内の情報を検索するといった用途を、クラウドへ送らずに作れる方向です。
MetaはLlama 3.2の1B・3Bを広い端末へ対応させる
Metaは、Llama 3.2の1Bと3Bを端末・エッジ向けに公開しました。量子化版では、同社のAndroid端末での検証において、元の形式と比べてモデルサイズを平均56%、メモリー使用量を平均41%減らしたと説明しています。
Qualcomm、MediaTek、Armと連携し、特定のスマートフォンだけでなく、広い端末で動かす生態系を作っています。導入側は、モデル性能に加え、端末ごとの動作確認と安全モデルを含む構成を見ます。
Appleは端末内モデルをアプリ機能として開放する
AppleのFoundation Modelsは、Apple Intelligenceを支える端末内モデルへ、アプリからアクセスする仕組みです。要約、抽出、分類、構造化出力、ツール呼び出しに対応します。
Appleは、端末内モデルを世界知識や高度な推論向けではないと説明しています。得意な仕事を明示している点が重要です。OS更新でモデルも変わるため、アプリ側にはモデルの版ごとに評価する運用が必要です。
IBM・Mistral・NTT・楽天は企業運用と業務特化を狙う
次の四社は、企業の仕事、端末、社内環境、日本語への適合を前面に出しています。
IBMはGranite 4.0で長い入力と同時処理を軽くする
IBM Granite 4.0は、MambaとTransformerを組み合わせた構造です。Tinyは全体7Bのうち1B、Smallは全体32Bのうち9Bを動かす設計です。Microは3Bです。
IBMは、長い文書や複数の同時処理で必要なメモリーを減らすことを重視しています。企業用途では、モデルを読み込めるかだけでなく、同時利用者が増えたときの費用と速度が重要だからです。暗号署名やAI管理の認証も、企業の調達条件を意識した動きです。
Mistralは端末とAIエージェントの両方へ軽量モデルを置く
Mistral AIは、Ministral 3の3B、8Bなどを端末・エッジ向けに展開しています。画像も扱い、関数呼び出しやエージェント用途を意識しています。
同社は、小型モデルを単独の対話AIとしてだけでなく、大きなモデルの間で実務を処理する役として位置付けています。翻訳、ローカル分析、通信なしの支援、ロボットなど、応答の速さと情報の置き場所が重要な仕事が対象です。
NTTはtsuzumi 2を社内運用と日本語業務へ合わせる
NTTのtsuzumi 2は、1GPUで動く軽量モデルです。金融、自治体、医療の知識を強め、企業が頻繁に使うタスクへの対応を狙っています。
企業内で使う回数が増えると、外部APIの回数課金より、自社でモデルを運用した方が安くなる境目が生まれます。機微な情報を使うAIエージェントでも、社内環境に置く選択肢があります。NTTの戦い方は、日本語性能だけでなく、業務特化と運用コストをまとめて提案することです。
楽天は1.5Bの日本語SLMを開いたモデルとして提供する
Rakuten AI 2.0 miniは、15億パラメータのSLMです。日本語と英語のデータで一から学習し、端末上の特定用途へ安く展開できるようにしています。
Apache 2.0ライセンスで公開されており、要約、質問応答、文章理解、対話システムの基盤に利用できます。日本企業にとっては、日本語モデルを作るだけでなく、公開して開発者を増やすことが競争軸になる例です。
JALの事例では、機内でレポート作成時間を最大3分の1にした
SLMの特徴が最も分かりやすいのは、通信が使いにくい現場です。JALは、客室乗務員から地上スタッフへ渡す引き継ぎレポートの作成にSLMを使いました。
富士通の事例によると、MicrosoftのPhi-4をJALの過去レポートで業務特化し、タブレット上で動くオンデバイス生成AIを開発しました。乗務員が会話形式で情報を入れると、業務用語に合わせたレポートを作ります。
富士通はモデルの特化、ヘッドウォータースは端末上で動かすアプリと量子化を担当しました。JALは業務データと評価基準を提供します。検証では、レポート作成時間を最大3分の1へ短縮しました。
この事例のポイントは、SLMを「小さなチャットボット」として売っていないことです。通信できない機内、決まった引き継ぎ書式、過去レポート、乗務員の修正という条件を一つにしています。価値はモデルの大きさではなく、現場の一連の作業を短くしたことにあります。
災害対応と保険業務でも、外へ出せない情報を扱う
三井不動産と日立は、約200棟のオフィスビルを統括する危機管理センターで、オフライン型の災害対策支援システムを検証しています。被災状況を入力すると、ビルごとに異なるマニュアルから対応内容を取り出し、優先順位を付けて示します。
日立の発表では、三井不動産が現場知識、マニュアル、評価を担当し、日立が業務特化モデルとAIエージェントを実装しています。大規模災害で通信が止まっても動くことが、採用理由です。
NTTデータは、tsuzumiを保険業務へ特化する検証を行いました。NTTデータの報告では、参照文書への質問、会話からの営業情報抽出、社内知識への回答を試しています。タスク特化学習は回答と情報抽出で効果を示しました。一方、約2,000万トークンの継続事前学習では、知識獲得の効果が限定的でした。
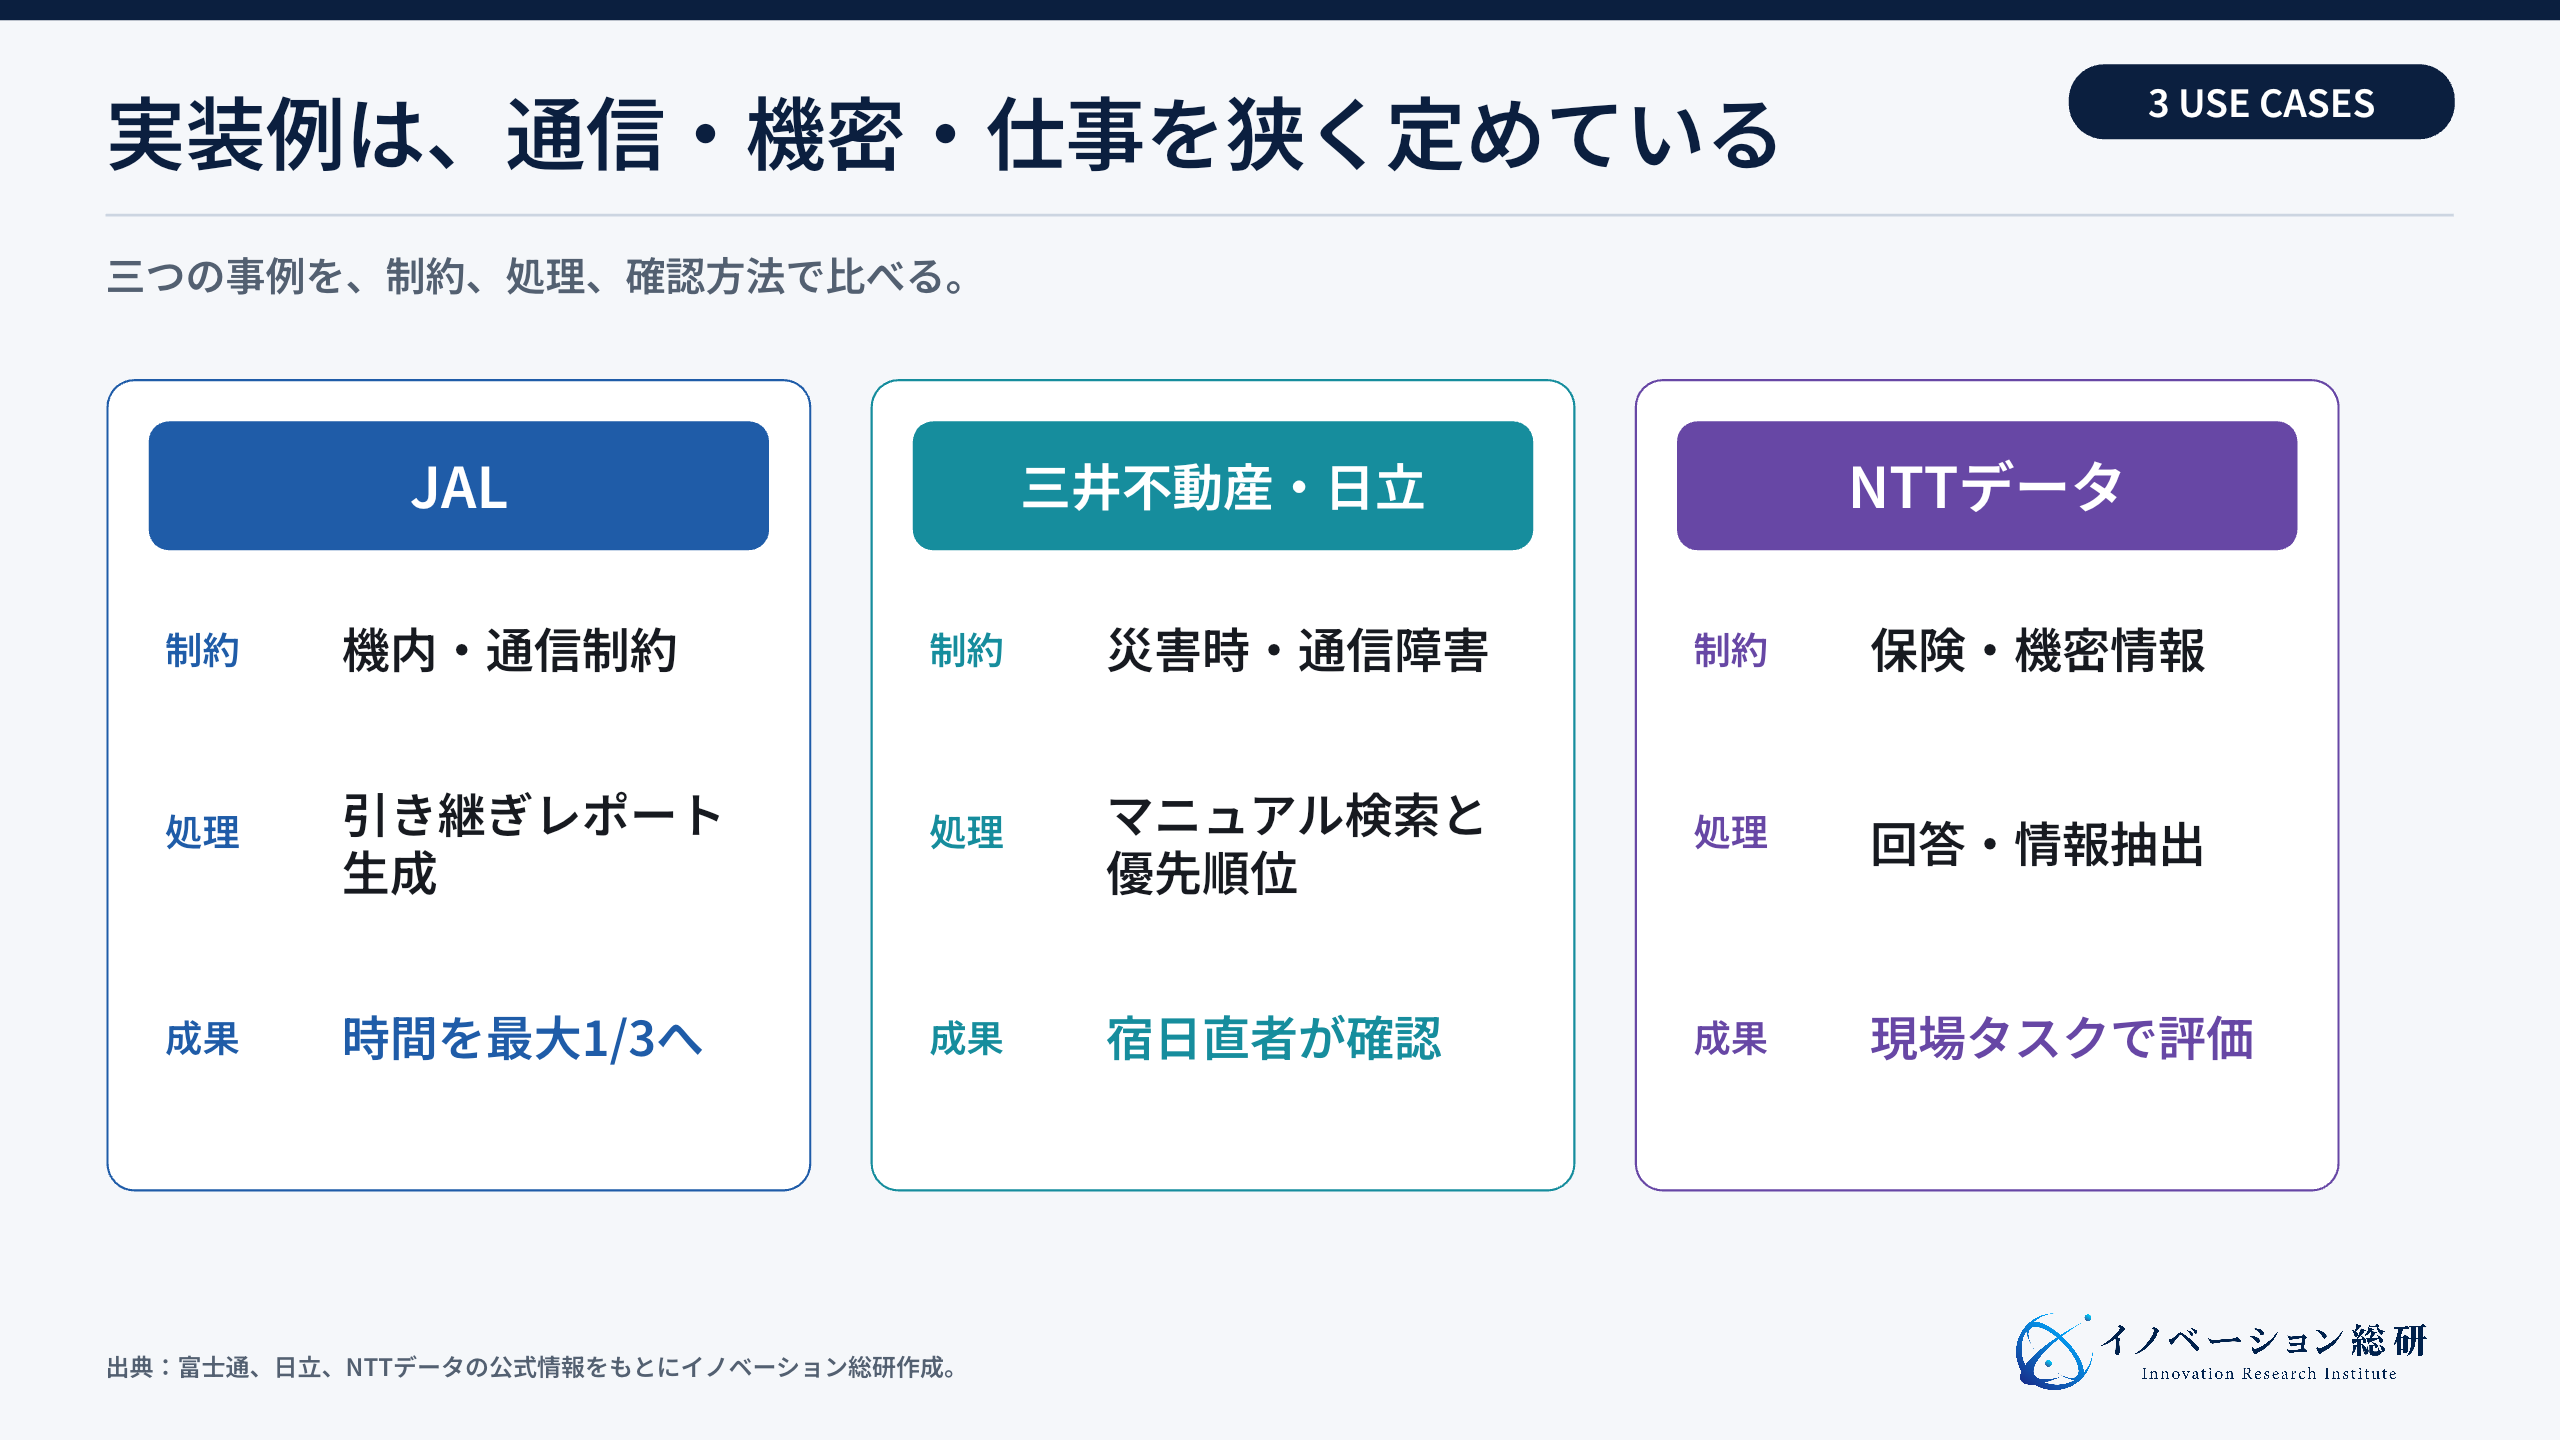
三つの事例には共通点があります。仕事が狭く定義され、参照する情報があり、利用者が結果を確認できます。逆に、何でも質問できる社内AIを小さなモデルだけで作ろうとすると、知識と推論の不足が表れやすくなります。
自社はSLMのどこへ入れるか
データ、端末、AI運用、閉域保守から近い入口を確認します。
NEXT STEP
次のステップ
AI技術を、現場で使い続けられる事業へ。
対象業務、実行場所、評価、端末、更新、例外処理、提携先を整理し、自社の参入余地を設計します。
SLMで考えられる4つの新規事業
新規参入では、汎用モデルの開発競争へ正面から入る必要はありません。顧客の仕事と実行場所を押さえる方が、後発企業の強みを作れます。
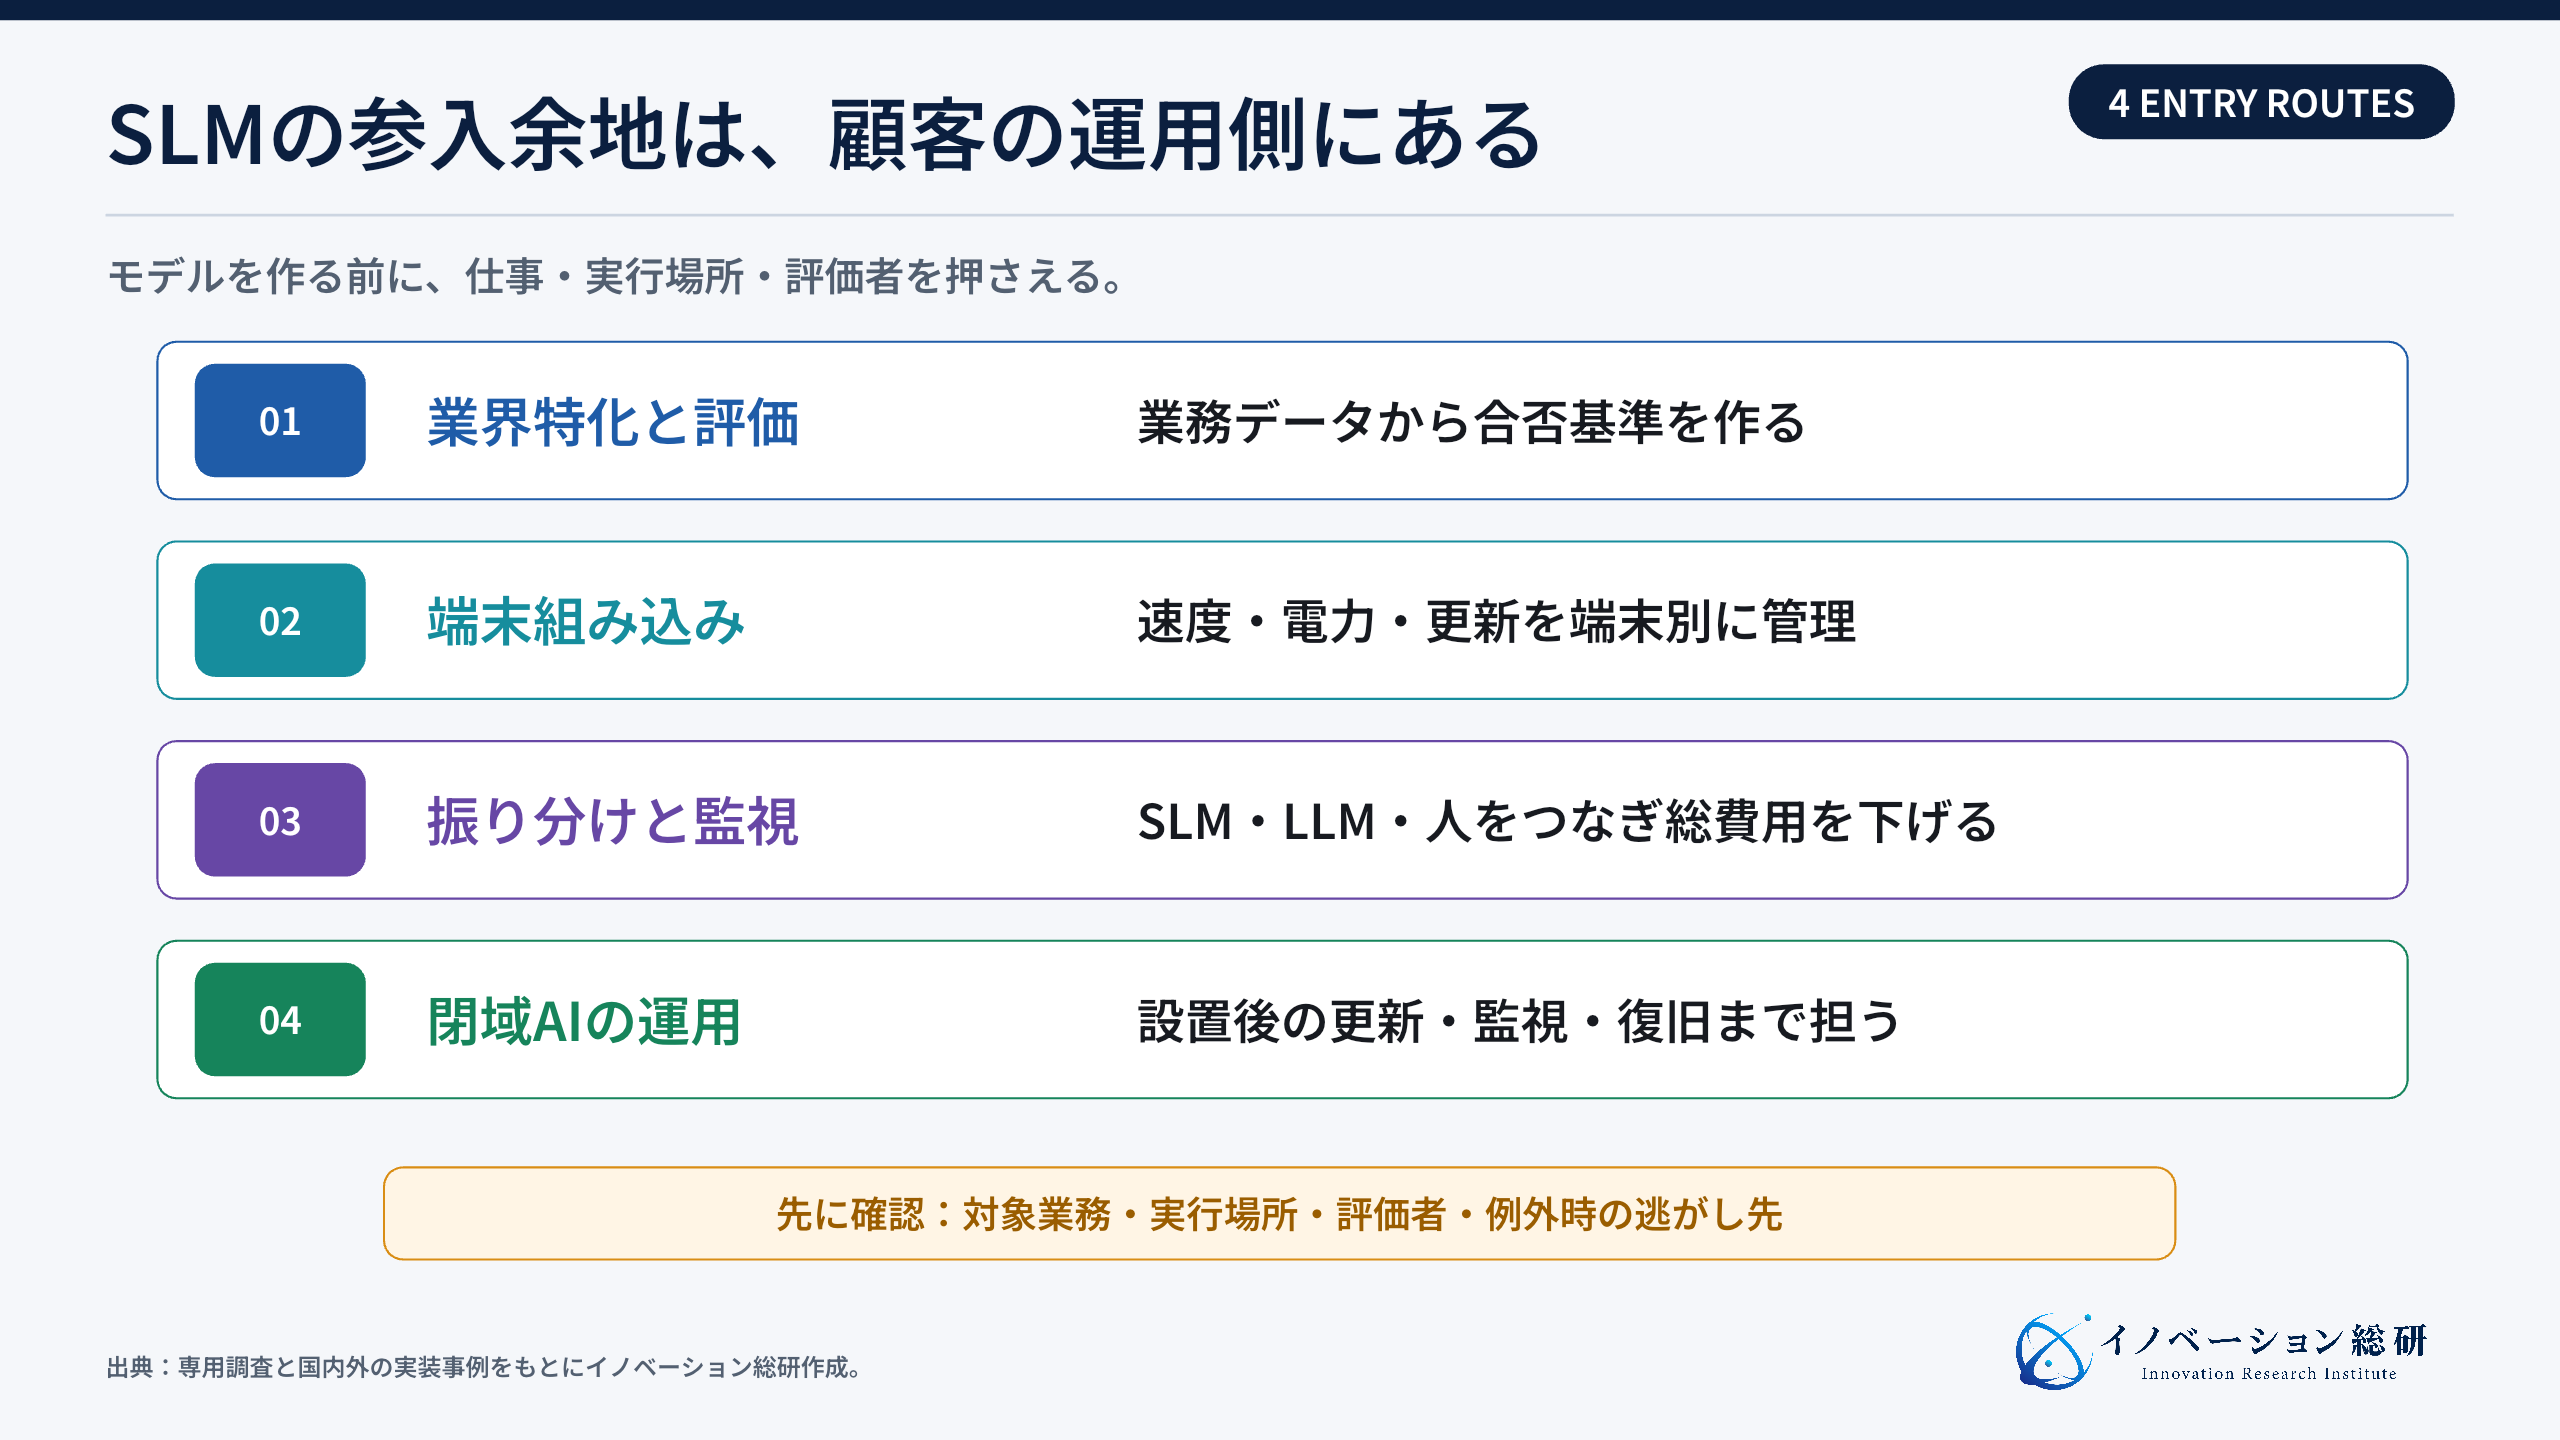
| 参入方法 | 最初の顧客 | 提供する価値 | 必要な資産・提携先 | 最初に確かめる証拠 |
|---|---|---|---|---|
| 業界特化モデルと評価 | 金融、保険、法務、製造、公共 | 用語と書式に合う抽出・分類・回答 | 顧客データ、専門家、評価設計、モデル提供企業 | 現場データでの正答率、修正率、例外率 |
| オンデバイス組み込み | 端末、機器、車両、アプリの会社 | 通信なしで速く処理し、データを端末に残す | 半導体、OS、端末メーカー、実行基盤 | 対象端末での速度、電力、メモリー、発熱 |
| モデル振り分けと監視 | AIエージェントや大量処理を運用する会社 | 簡単な処理をSLMへ移し、総費用を下げる | LLM接続、ログ、評価器、運用監視 | 品質を保ったまま減らせる上位モデル呼び出し数 |
| 閉域AIの導入・運用 | 外部送信を制限する企業・自治体 | 社内や施設内で生成AIを継続運用する | サーバー、認証、更新、保守、セキュリティ | データ境界、更新方法、障害時の復旧時間 |
業界特化モデルは、データ量より評価の質が壁になる
業界特化では、過去文書を集めて学習させるだけでは足りません。正しい回答例、誤りやすい例、答えてはいけない例を作ります。現場の専門家が評価し、修正した履歴を次の改善へ使います。
NTTデータの保険事例は、データを追加すれば必ず知識が増えるわけではないことを示しました。参入企業の資産は、大量の文書ではなく、仕事ごとの合否を判断できる評価データです。
端末組み込みは、モデルより配布と更新が継続収益になる
端末へ組み込むと、通信費と遅延を減らせます。一方、端末の種類、OS、メモリー、電池、発熱へ合わせる必要があります。AIスマホのように端末上でAIを動かす製品では、モデルの能力だけでなく、電池消費と更新方法が利用体験を左右します。販売後は、モデル、安全ルール、業務知識を更新します。
初期の開発費だけでなく、端末台数に応じたライセンス、更新、監視、保守を組み合わせると継続収益になります。機器メーカーや通信会社が持つ販売網も重要な提携資産です。
振り分け事業は、費用削減と品質維持を同時に証明する
AIエージェントでは、情報抽出、JSONへの変換、問い合わせ分類など、狭い処理が何度も発生します。そこをSLMへ移し、難しい入力だけをLLMや人へ送ります。
この事業は「SLMの方が安い」という説明だけでは売れません。同じ業務成功率を保ちながら、1件当たり費用、応答時間、上位モデルの利用回数をどれだけ減らしたかを示します。モデルが変わっても使える評価と振り分けが、長く残る資産です。
閉域運用は、設置後の保守責任まで商品にする
社内サーバーや施設内に置く場合、外部へのデータ送信は減らせます。その代わり、顧客側でハードウェア、認証、更新、監視、バックアップを持ちます。
参入企業は、モデルを設置して終わりにせず、脆弱性への対応、モデルの更新、品質の再評価、障害復旧をサービスへ含めます。閉域性そのものより、閉じた環境でも古くならない運用を売ることが重要です。
導入費用は、API料金だけで比べない
SLMを自社で動かすと、外部APIの利用料を減らせます。しかし、費用がゼロになるわけではありません。端末やサーバー、開発、追加学習、評価、配布、監視、保守に費用がかかります。
比較するときは、一件当たりの総費用を出します。年間の処理回数が少なく、質問の種類が広いなら、クラウドLLMを使う方が安い場合があります。処理回数が多く、仕事が定型で、端末や社内に置く理由が強いほど、SLMが合いやすくなります。
費用表には、次の項目を入れます。
- 初期のモデル選定、業務設計、端末最適化
- 学習データと評価データの作成
- サーバー、端末、電力、保守
- モデルとアプリの更新・再評価
- 誤りを人が直す時間と、業務停止の損失
- LLMや人へ切り替える例外処理
安いモデルを選んでも、誤りが増えて確認時間が伸びれば、総費用は上がります。モデルの単価ではなく、「人の修正を含む一件当たり費用」で比べます。
小規模言語モデル導入で決める責任分界と見送り条件
SLMは、端末や社内に置きやすい一方、顧客側の責任も増やします。導入前に、モデル会社、開発会社、端末会社、利用企業、人の役割を分けます。
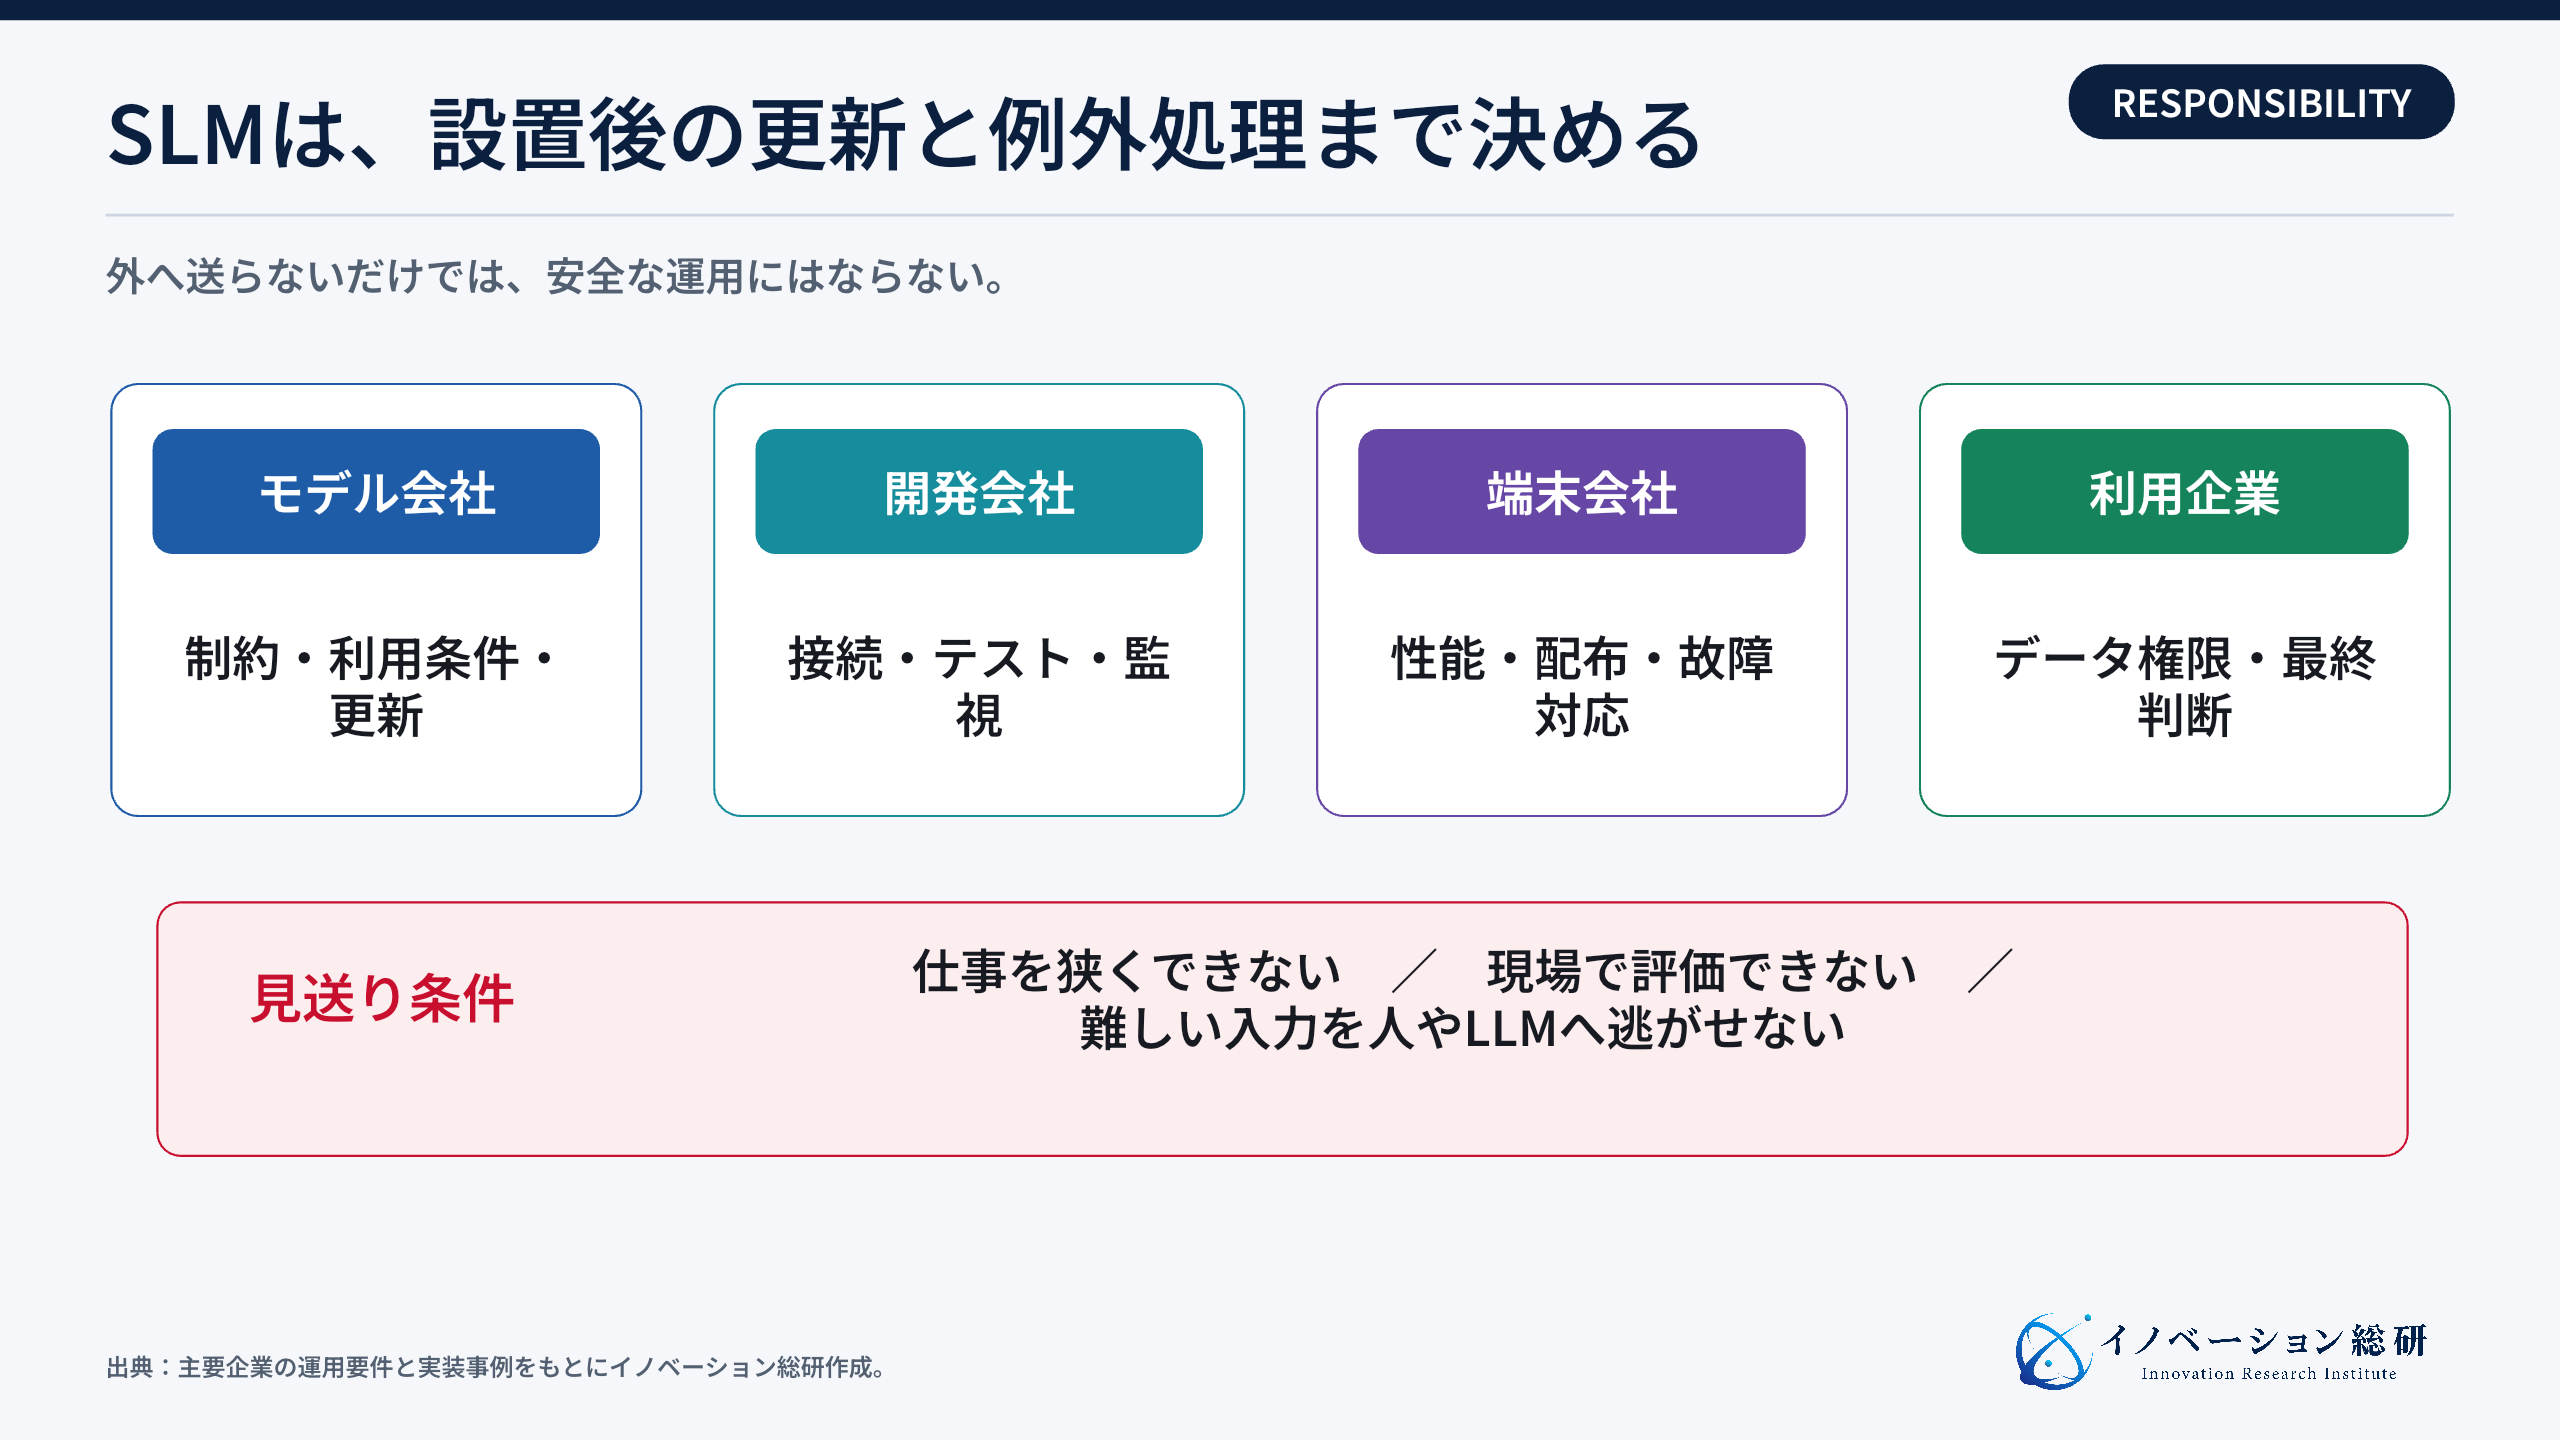
モデル会社は、モデルの利用条件、既知の制約、更新を示します。開発会社は、業務への接続、出力形式、テスト、監視を担います。端末会社は、対応機種、性能、配布、故障時の対応を担います。利用企業は、データ利用の権限、業務ルール、最終判断、人への切り替えを決めます。
次の条件に当てはまる場合は、SLMを主役にしない方がよいでしょう。
- 質問の範囲を狭く定義できず、広い世界知識が必要
- 間違いの影響が大きいのに、人の確認や停止機能を置けない
- 端末ごとの更新と回収を管理できない
- 現場データで精度を測る担当者と評価基準がない
- 処理量が少なく、自社運用の固定費を回収できない
- 大きなモデルへ切り替える経路を用意できない
参入判断の中心は、SLMを動かせるかではありません。対象業務を狭く定め、現場の合否を測り、難しい入力を安全に逃がせるかです。
小規模言語モデルに関するよくある質問
本記事のまとめ|SLMは小ささより使う場所で選ぶ
小規模言語モデルは、LLMより必要な計算資源を抑え、狭い仕事や端末内の処理へ合わせやすい言語モデルです。市場は成長が予測されていますが、調査ごとに対象範囲が違うため、金額は分けて読む必要があります。
Microsoft、Google、Meta、Appleは、モデルとOS・端末・開発環境を結び付けています。IBM、Mistral、NTT、楽天は、企業運用、エッジ、業務特化、日本語といった条件に応えています。
JAL、三井不動産・日立、NTTデータの事例からは、通信やデータに制約があり、仕事と評価を狭く定義できる場面でSLMが力を発揮することが分かります。
新規事業の入口は、汎用モデルの開発だけではありません。業界特化、端末組み込み、モデル振り分け、閉域運用に機会があります。自社が持つデータ、端末、顧客接点、保守網を起点に、どの仕事をどこで動かすかから設計してください。
参照した主な情報
- Microsoft Research:Phi-4-Mini Technical Report
- Microsoft Learn:Phi Silica transparency note
- Google Developers Blog:Gemma 3n developer guide
- Meta AI:量子化したLlama 3.2 1B・3B
- Apple Developer:Foundation Models
- IBM:Granite 4.0
- Mistral AI:Models
- NTT R&D:tsuzumi 2
- 楽天グループ:Rakuten AI 2.0 mini
- NVIDIA Research:Small Language Models are the Future of Agentic AI
- 富士通:JALのオンデバイス生成AI事例
- 日立:オフライン型災害対策支援システム
- NTTデータ:保険業界特化モデルの検証
- Grand View Research:Small Language Model Market
- MarketsandMarkets:Small Language Model Market
CONTACT
お問い合わせ
SLMの技術シーズを、運用で成立する事業へ。
対象業務、データ、端末、評価、更新、責任分界を一つの事業構造にし、参入・提携・待機・見送りを判断します。


